


Python爬取B站排行榜Top100视频数据实战教程

发布时间:2026-10-14 |
5人浏览过
本文详细介绍如何使用Python爬取B站热门视频排行榜Top100的数据。通过伪装浏览器请求、利用BeautifulSoup和正则表达式解析网页源码,并将排名、标题、播放量等七项关键信息保存至SQLite数据库。教程涵盖核心代码逻辑与数据保存策略,适合Python初学者参考学习。
欢迎收藏本文,以便后续随时查阅。
第一步:导入所需的第三方库
from bs4 import BeautifulSoup # 解析网页
import re   # 正则表达式,进行文字匹配
import urllib.request,urllib.error  # 通过浏览器请求数据
import sqlite3  # 轻型数据库
import time  # 获取当前时间
第二步:编写程序主函数
整个爬取流程主要包含三个环节:首先声明目标网页地址,其次获取并解析网页数据,最后将处理后的数据进行保存。
def main():
	#声明爬取网站
    baseurl = "https://www.bilibili.com/v/popular/rank/all"
    #爬取网页
    datalist = getData(baseurl)
    # print(datalist)
    #保存数据
    dbname = time.strftime("%Y-%m-%d", time.localtime())
    dbpath = "BiliBiliTop100  " + dbname
    saveData(datalist,dbpath)
具体技术实现细节如下: (1)数据请求阶段:采用伪装浏览器User-Agent的方式发起HTTP请求,以获取网页数据; (2)数据解析阶段:结合使用BeautifulSoup解析HTML源码,并辅以re正则表达式精准匹配所需字段; (3)数据存储阶段:鉴于B站排行榜每日更新,程序采用当前日期作为数据库文件的命名依据,确保数据按日归档。
第三步:查看程序运行结果
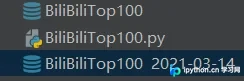
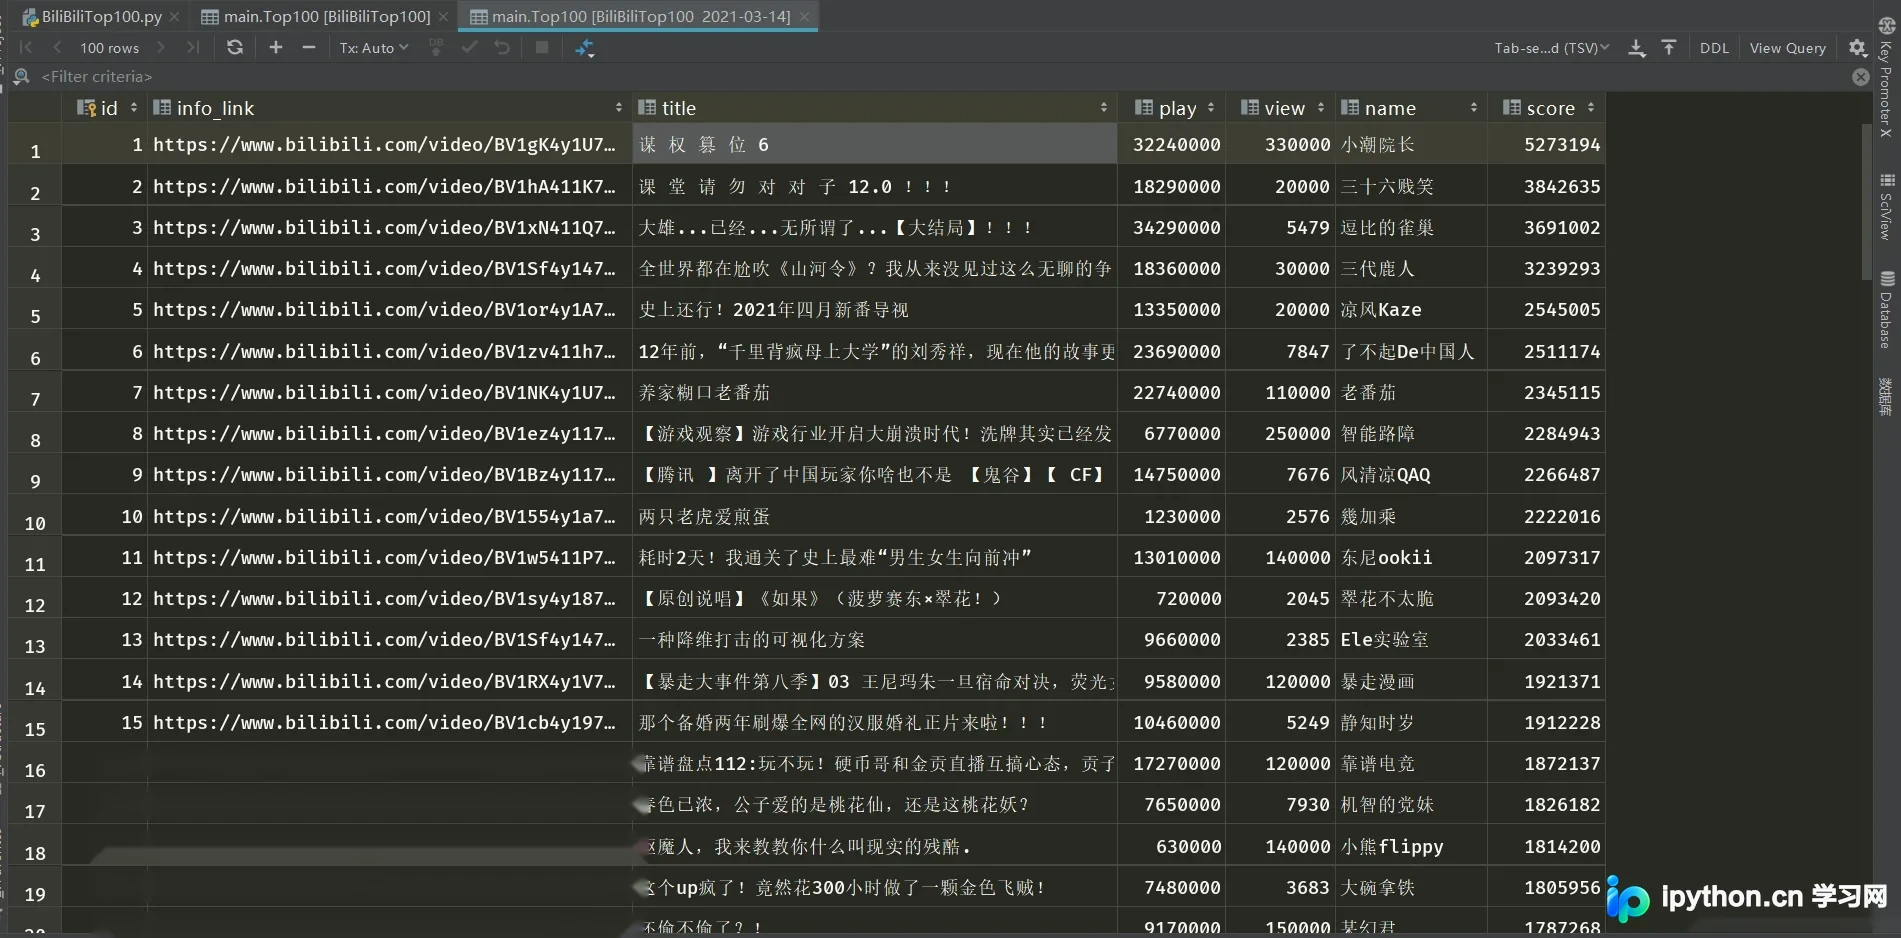
最终存入数据库的数据字段包括七个维度:视频排名、视频链接、视频标题、播放量、评论数、UP主名称以及综合评分。
第四步:完整程序源代码
from bs4 import BeautifulSoup #解析网页
import re # 正则表达式,进行文字匹配
import urllib.request,urllib.error
import sqlite3
import time


def main():
    #声明爬取网站
    baseurl = "https://www.bilibili.com/v/popular/rank/all"
    #爬取网页
    datalist = getData(baseurl)
    # print(datalist)
    #保存数据
    dbname = time.strftime("%Y-%m-%d", time.localtime())
    dbpath = "BiliBiliTop100  " + dbname
    saveData(datalist,dbpath)

#re正则表达式
findLink =re.compile(r'<a class="title" href="(.*?)" rel="external nofollow" ') #视频链接
findOrder = re.compile(r'<div class="num">(.*?)</div>') #榜单次序
findTitle = re.compile(r'<a class="title" href=".*?" rel="external nofollow"  rel="external nofollow"  target="_blank">(.*?)</a>') #视频标题
findPlay = re.compile(r'<span class="data-box"><i class="b-icon play"></i>([\s\S]*)(.*?)</span> <span class="data-box">') #视频播放量
findView = re.compile(r'<span class="data-box"><i class="b-icon view"></i>([\s\S]*)(.*?)</span> <a href=".*?" rel="external nofollow"  rel="external nofollow"  target="_blank"><span class="data-box up-name">') # 视频评价数
findName = re.compile(r'<i class="b-icon author"></i>(.*?)</span></a>',re.S) #视频作者
findScore = re.compile(r'<div class="pts"><div>(.*?)</div>综合得分',re.S) #视频得分
def getData(baseurl):
    datalist = []
    html = askURL(baseurl)
    #print(html)

    soup = BeautifulSoup(html,'html.parser')  #解释器
    for item in soup.find_all('li',class_="rank-item"):
        # print(item)
        data = []
        item = str(item)

        Order = re.findall(findOrder,item)[0]
        data.append(Order)
        # print(Order)

        Link = re.findall(findLink,item)[0]
        Link = 'https:' + Link
        data.append(Link)
        # print(Link)

        Title = re.findall(findTitle,item)[0]
        data.append(Title)
        # print(Title)

        Play = re.findall(findPlay,item)[0][0]
        Play = Play.replace(" ","")
        Play = Play.replace("\n","")
        Play = Play.replace(".","")
        Play = Play.replace("万","0000")
        data.append(Play)
        # print(Play)

        View = re.findall(findView,item)[0][0]
        View = View.replace(" ","")
        View = View.replace("\n","")
        View = View.replace(".","")
        View = View.replace("万","0000")
        data.append(View)
        # print(View)

        Name = re.findall(findName,item)[0]
        Name = Name.replace(" ","")
        Name = Name.replace("\n","")
        data.append(Name)
        # print(Name)

        Score = re.findall(findScore,item)[0]
        data.append(Score)
        # print(Score)
        datalist.append(data)
    return datalist

def askURL(url):
    #设置请求头
    head = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0;Win64;x64) AppleWebKit/537.36(KHTML, likeGecko) Chrome/80.0.3987.163Safari/537.36"
    }
    request = urllib.request.Request(url, headers = head)
    html = ""
    try:
        response = urllib.request.urlopen(request)
        html = response.read().decode("utf-8")
        #print(html)
    except urllib.error.URLError as e:
        if hasattr(e,"code"):
            print(e.code)
        if hasattr(e,"reason"):
            print(e.reason)
    return html

def saveData(datalist,dbpath):
    init_db(dbpath)
    conn = sqlite3.connect(dbpath)
    cur = conn.cursor()

    for data in datalist:
        sql = '''
        insert into Top100(
        id,info_link,title,play,view,name,score)
        values("%s","%s","%s","%s","%s","%s","%s")'''%(data[0],data[1],data[2],data[3],data[4],data[5],data[6])
        print(sql)
        cur.execute(sql)
        conn.commit()
    cur.close()
    conn.close()

def init_db(dbpath):
    sql = '''
    create table Top100
    (
    id integer primary key autoincrement,
    info_link text,
    title text,
    play numeric,
    view numeric,
    name text,
    score numeric
    )
    '''
    conn = sqlite3.connect(dbpath)
    cursor = conn.cursor()
    cursor.execute(sql)
    conn.commit()
    conn.close()


if __name__ =="__main__":
    main()
至此,关于如何使用Python爬取B站排行榜Top100视频数据的教程已介绍完毕。如需了解更多Python与B站视频相关的内容,欢迎查阅本站历史文章或继续浏览后续更新,感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















