


Python递归函数中正确使用迭代器的方法与异常处理

本文详解在Python递归函数中如何使用迭代器优化内存占用,分析直接yield返回迭代器对象导致的逻辑错误,并提供next()调用与for循环两种正确写法。同时针对未找到目标文件时触发的StopIteration异常,给出添加空yield或try-except块的两种修复方案,确保递归遍历的稳定性。
递归遍历文件夹的需求与内存问题
首先,我们的目标是实现一个递归遍历文件夹的功能。当遇到满足特定条件的文件时,需要返回该文件的路径。
如果不使用迭代器,常规的递归实现方式如下:
path_list = []
def get_one_cage(root: str, cook_folder_name: str):
    for item in os.listdir(root).copy():
        item_path = os.path.join(root, item)
        if item == cook_folder_name:
            path_list.append(item_path)
            return
        elif os.path.isdir(item_path):
            get_one_cage(item_path, cook_folder_name)
这种实现采用了深度优先遍历策略。当找到符合条件的文件时,将其路径追加到一个全局列表中,随后返回上一层调用。这种方法存在一个明显的缺陷:需要一个列表来存储所有满足条件的文件路径,这会占用大量的内存空间。
使用迭代器优化内存占用
使用迭代器可以实现“遍历一个,生成一个”的效果,从而显著节省内存。
为了替换原有的实现,最直观的想法是将return语句替换为yield,使其成为生成器函数,并通过for循环来调用该迭代器函数。
def get_one_cage(root: str, cook_folder_name: str):
    for item in os.listdir(root).copy():
        item_path = os.path.join(root, item)
        if item == cook_folder_name:
            yield item_path
        elif os.path.isdir(item_path):
            get_one_cage(item_path, cook_folder_name)
直接yield返回迭代器的逻辑陷阱
然而,在实际运行中,当递归深入到内嵌函数层级时,程序无法按预期工作,这令人困惑。
经过分析,问题在于迭代器函数本身并不直接执行代码,它只是一个对象。
简单来说,Python程序的执行通常遵循“动词+名词”的结构,或者仅包含动词。例如:
a = 1
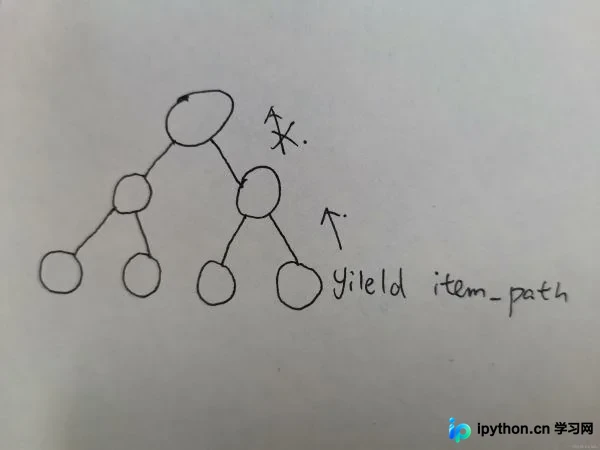
上述代码实际上是将1赋值给变量a,这是一个有明确动作的过程。而迭代器仅仅是一个名词(对象),必须通过for语句进行迭代,或者调用next()方法,亦或是通过print、yield、return等动词操作,它才会真正执行。仅仅放置一个迭代器对象而不加任何操作,是无法触发执行的。此外,上述代码还存在另一个逻辑漏洞。在第一段代码中,我们使用全局变量来存储遍历结果。而在第二段代码中,虽然本意是将结果yield到调用for循环的地方,但由于程序已经嵌套了多层递归,每次yield只能返回当前层的结果。具体逻辑如下图所示:
基于以上两点分析,我们对代码进行如下修改:
def get_one_cage(root: str, cook_folder_name: str):
    for item in os.listdir(root).copy():
        item_path = os.path.join(root, item)
        if item == cook_folder_name:
            yield item_path
        elif os.path.isdir(item_path):
            yield get_one_cage(item_path, cook_folder_name)
程序的执行结果如下所示:

显然,这里返回的是一个迭代器对象,而不是预期的字符串(str)。其内部逻辑如下图所示:
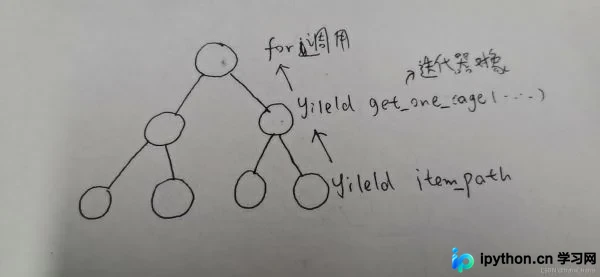
这好比原本的计划是:小明把沙袋传给小红,小红再传给小兰。但实际发生的情况是:小明把沙袋传给了小红,而小红本身被传了出去(即返回了迭代器对象)。正确的修改方式如下:
def get_one_cage(root: str, cook_folder_name: str):
    for item in os.listdir(root).copy():
        item_path = os.path.join(root, item)
        if item == cook_folder_name:
            yield item_path
        elif os.path.isdir(item_path):
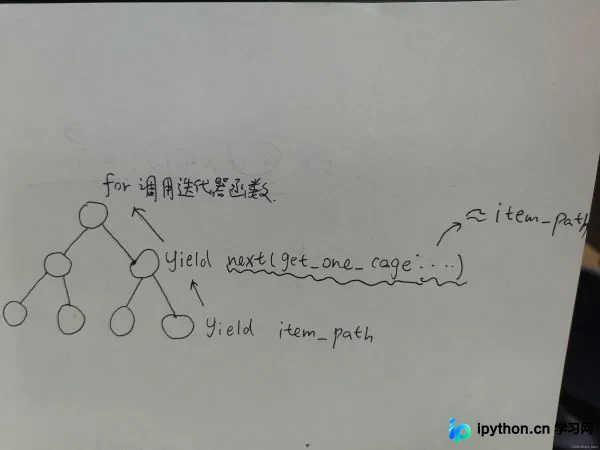
            yield next(get_one_cage(item_path, cook_folder_name))
其逻辑流程如下:
正确的迭代器调用方式
另一种情况是参考学长源码中的写法,即使用for循环来调用迭代器:
def get_one_cage(root: str, cook_folder_name: str):
    for item in os.listdir(root).copy():
        item_path = os.path.join(root, item)
        if item == cook_folder_name:
            yield item_path
        elif os.path.isdir(item_path):
             for i in get_one_cage(item_path, cook_folder_name):
                 yield i
这种方式适用于需要返回多个文件的情况。源码中通常还会配合os.path.isfile进行判断,这里为了简化演示,代码显得较为冗余。这两种方式均可以正常使用。
处理未找到文件时的StopIteration异常
在昨天文章发布后,遇到了一个Bug。简单来说,如果文件夹系统中不存在我们想要的文件,当递归深入到最深层级的文件夹时,程序会报错。
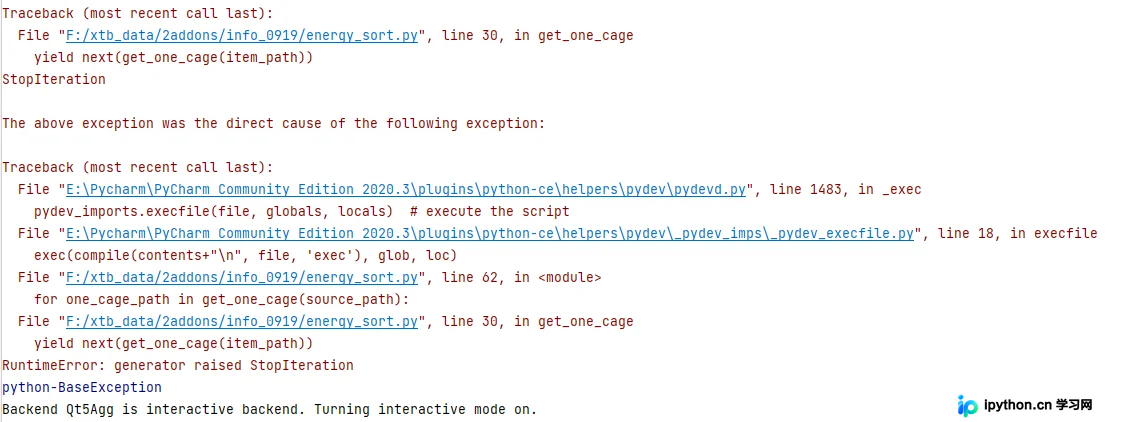
1 我们可以这样理解:老板让员工寻找某样东西,员工将其外包给临时人员。如果临时人员找到了目标物品,可以一路传递回去,任务正常完成。但如果没找到,临时人员会一直寻找,不停歇地遍历所有能访问的地方(即遍历完整个文件夹)。当遍历结束仍未找到时,就会抛出StopIteration异常。因此,问题的核心在于缺乏一个返回机制。解决方法是在遍历结束时添加一个空的yield语句。
def get_one_cage(root: str):
    for index, item in enumerate(os.listdir(root)):
        item_path = os.path.join(root, item)
        if item == 'cooked_xyz':
            yield item_path
        elif os.path.isdir(item_path):
            yield next(get_one_cage(item_path))
        elif index == len(os.listdir(root).copy()) - 1:
            yield
或者,利用try...except语句来处理异常:
def get_one_cage(root: str):
    try:
        for item in os.listdir(root):
            item_path = os.path.join(root, item)
            if item == 'cooked_xyz':
                yield item_path
            elif os.path.isdir(item_path):
                yield next(get_one_cage(item_path))
    except:
        yield
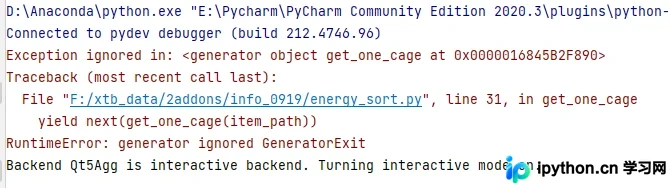
此时会出现如上报错,这是正常现象。 将最后的yield替换为return也是可行的,但建议统一使用yield,混合使用yield和return会让代码逻辑显得怪异。
个人推荐第二种方法。 注:copy()方法在此处并非必须。
以上就是Python编程如何在递归中使用迭代器的详细内容,更多关于Python编程递归中使用迭代器的资料请关注本站其它相关文章!
以上就是Python编程如何在递归函数中使用迭代器的详细内容,更多关于Python递归函数中使用迭代器的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















