


Python实现词频统计:从文本处理到结果输出的完整流程

发布时间:2026-10-14 |
4人浏览过
本文介绍使用Python实现词频统计软件的方法。涵盖文件读取、大小写转换、特殊字符去除、单词统计、排序及结果写入文本等步骤。通过正则表达式清洗数据,利用字典统计词频,并按出现次数降序排列,最终输出高频单词及总数,适合初学者参考。
功能要求
这是一份课程作业,代码中包含详细注释,旨在开发一个词频统计软件。
1)实现数据读取功能,支持文件的输入与输出操作。
2)处理过程中不区分大小写,并去除文本中的特殊字符。
3)统计单词出现频率,例如记录“about”出现10次,同时计算文本中单词的总数。
4)对统计得到的单词进行排序,依据是单词出现的次数。
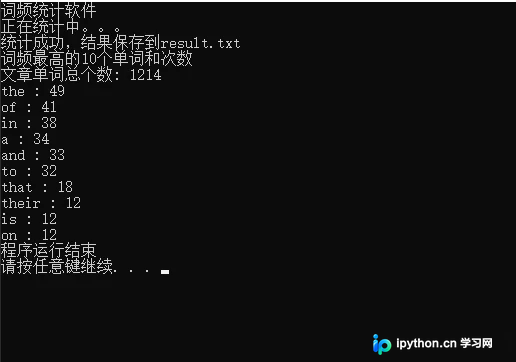
5)输出词频最高的10个单词及其对应的出现次数。
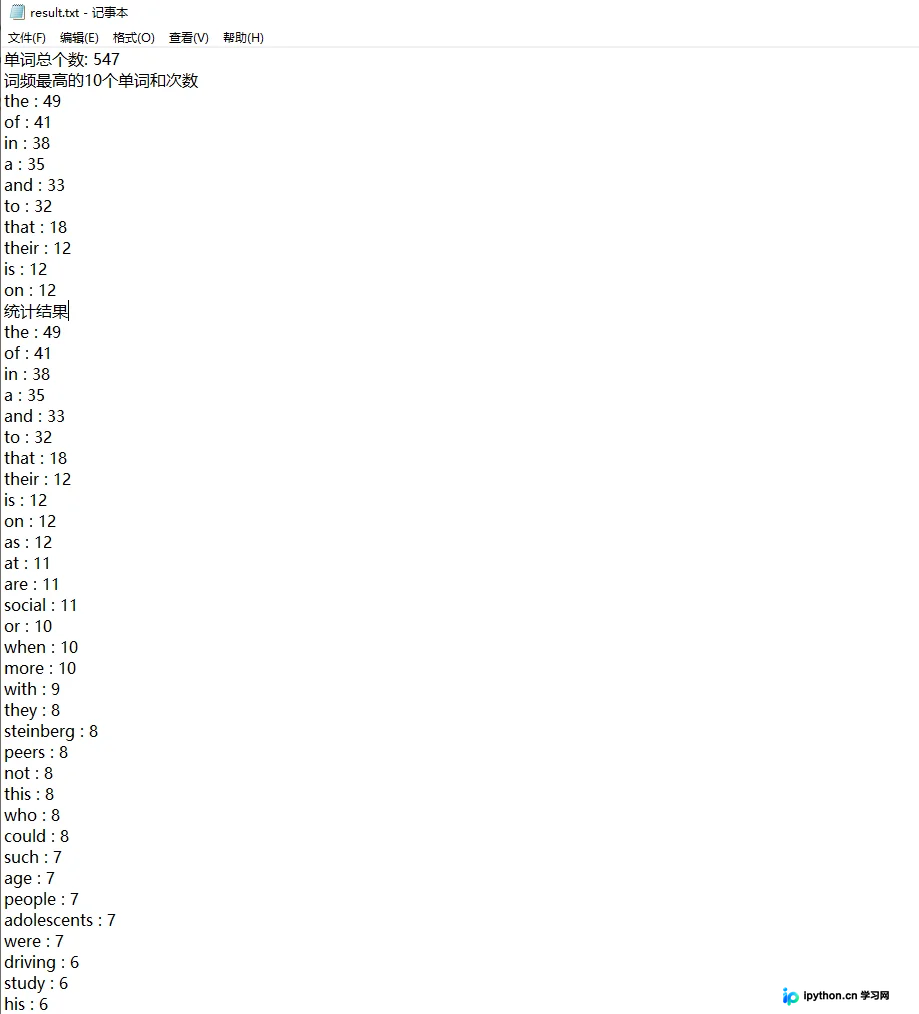
6)将最终的统计结果保存至文本文件中。
方法如下
1. 实现文件读取,处理大小写转换,并利用正则表达式去除特殊字符。
import re

def getword():
     # 读取文件
     f=open('read.txt','r',encoding='utf-8')
     # 将大写转化成小写
     word=f.read().lower()
     # 关闭文件
     f.close()
     #利用正则除去特殊字符   |\符+
     list=re.split('\s+|\,+|\.+|\!+|\:+|\?+|\;+|\(+|\)+|\-+|\_+|\=+|\++|\“+|\、+|\/+|\{+|\}+|\”+|\:+|\。+|\“+|\[+|\]+|\【+|\】+|\—+|\%+|\"+',word)
     # 遍历列表 去除列表中的空格
     i = 0
     while i < len(list):
          if list[i] == '':
               list.remove(list[i])
               i -= 1
          i += 1

     # for a in list:
     #      if a == "":
     #         list.remove(a)
    #用for循环的话如果存在多个空字符串 其列表会随时发生变化,导致无法正常删除空字符串 所以在使用for…in循环遍历列表时,最好不要对元素进行增删操作

#  对于others'优化 如果最后一个字符是‘就将'其去掉
     for i in range(len(list)):
          l=list[i]
          if list[i][-1] == "'":
               list[i] = list[i][:-1]
     return list
2. 执行单词统计与排序逻辑。
from getfilewords import getword

def statistics():
    dict={}  #定义一个空的字典,在后面的运算中逐步添加数据
    words=getword()
    for word in words: #遍历整个列表
        if word in dict.keys():  #判断当前单词是否已经存在 dict.keys()是已存进字典中的单词
            # 补充:keys() 方法用于返回字典中的所有键;
            # values() 方法用于返回字典中所有键对应的值;
            #详情见Test1
            dict[word]=dict[word]+1  #在当前单词的个数上加 1
        else:
            dict[word]=1  #当前单词第一次出现时 会把单词写入dict字典里 格式为 ‘单词'=1
#排序
    w_order=sorted(dict.items(),key=lambda x:x[1],reverse=True)
# print(dict.items())
# dict.items()返回的是列表
# 按字典集合中,每一个元组的第二个元素排列。
# sorted会对dict.items()这个list进行遍历,把list中的每一个元素,也就是每一个tuple()当做x传入匿名函数lambda x:x[1],函数返回值为x[1]
# reverse属性True为降序 False为升序
    return w_order #返回排序后的列表
3. 将处理结果写入指定文本文件。
from WordStatistics import statistics
def writefile():
    w_order=statistics()
    f = open('result.txt', 'w',encoding='utf-8')
    print("文章单词总个数:",+len(getword()),file=f)
    print("文章单词总个数:", +len(getword()))

    # 写入文件
    print("词频最高的10个单词和次数",file=f)
    print("词频最高的10个单词和次数")

    w_order10=w_order[:10]#将列表的前十位提取并且遍历 输出key(单词)和values(次数)
    for key,values in w_order10:
        print(key,':',values,file=f)
        print(key, ':', values)

    #遍历列表中的所有数据
    print("统计结果",file=f)
    for key,values in w_order:
        print(key,':',values,file=f)
    f.close()#关闭文件
4. 设定程序入口点。
import os

from writefile import writefile

print("词频统计软件")
print("正在统计中。。。")
print("统计成功,结果保存到result.txt")
writefile()
print("程序运行结束")
os.system("pause")
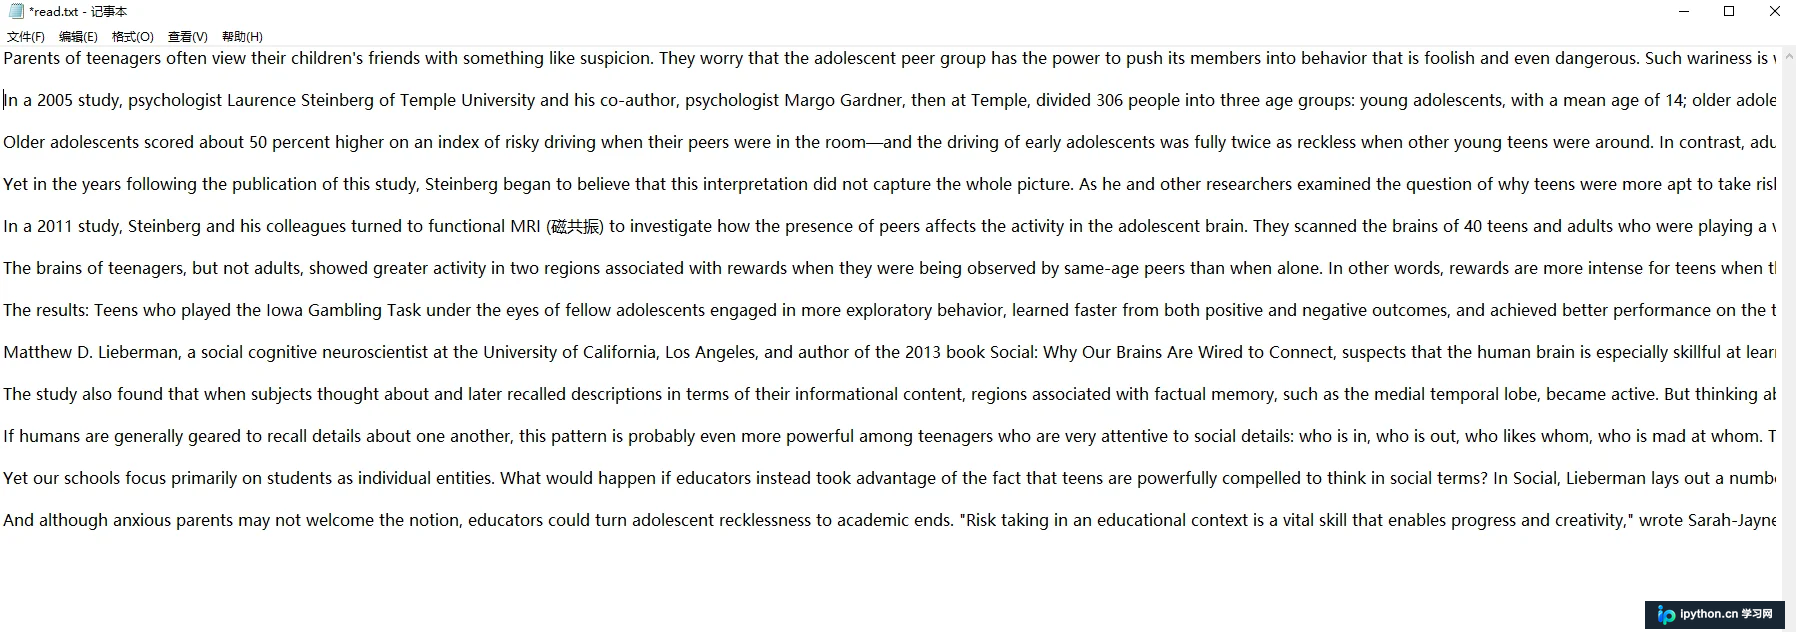
5. 展示运行截图,此处为需要统计的示例文本。
运行程序
运行结果
总结
至此,关于如何利用Python实现词频统计功能的文章介绍完毕。如需了解更多Python实现词频统计的相关内容,请搜索本站历史文章或继续浏览后续内容。感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















