


Python StatsModels线性回归实战:从原理到代码详解

本文详解Python中StatsModels库的线性回归应用。从插值、拟合与回归的概念辨析入手,深入讲解一元及多元线性回归的建模流程。通过完整代码示例展示数据预处理、模型拟合及参数估计过程,并详细解读回归系数、P值、R方等关键统计指标,帮助读者掌握统计回归分析的核心方法。
1、背景知识
1.1 插值、拟合、回归和预测
在数学建模领域,插值、拟合、回归和预测是四个高频出现且极易混淆的概念。
- 插值的核心任务是在已知的离散数据点之间构建连续函数,确保生成的曲线严格穿过所有给定的离散点。作为离散函数逼近的重要手段,插值利用有限点的取值情况来估算其他位置的近似值。
- 拟合则是寻找一个连续函数(曲线)来逼近给定的离散数据,旨在使曲线与数据整体吻合。
尽管插值和拟合都是基于已知数据点寻找具有相似变化规律和特征的近似曲线,但二者存在本质区别:插值要求近似曲线必须完全经过所有给定数据点,而拟合仅要求曲线在整体上尽可能接近数据点,并反映数据的总体变化规律和发展趋势。从数学角度看,插值可视为一种特殊的拟合,即误差函数为0的拟合。然而,由于实际数据通常包含噪声或误差,强制误差为0往往导致过拟合,使得模型在训练集之外的数据上泛化能力较差。因此,实践中插值多应用于图像处理,而拟合更常用于实验数据处理。
- 回归是一种研究一组随机变量与另一组随机变量之间关系的统计分析方法。它不仅涉及建立数学模型并估计模型参数、检验模型的可信度,还包括利用建立的模型和估计的参数进行预测或控制。
- 预测是一个广泛的概念,在数学建模中特指对已获取的数据和信息进行定量研究,据此建立与预测目标相适应的数学模型,进而对未来发展趋势进行定量预测。通常观点认为,插值和拟合均属于预测类方法。
回归与拟合在侧重点上有所不同:回归是一种数据分析方法,侧重于研究两个或多个变量之间的内在关系;而拟合是一种具体的数据处理技术,侧重于通过寻优曲线参数使曲线与数据保持一致。
1.2 线性回归
回归分析(Regression analysis)是一种用于研究自变量与因变量之间定量关系的统计分析方法,广泛应用于预测分析、时间序列建模以及变量间因果关系的发现。根据变量间关系的类型,回归分析主要分为线性回归和非线性回归两类。
线性回归(Linear regression)假设数据集中的目标变量(y)与特征变量(X)之间存在线性关系,即满足一个多元一次方程。若回归分析中仅包含一个自变量和一个因变量,且二者关系可用直线近似表示,则称为一元线性回归;若包含两个或多个自变量,且因变量与自变量之间呈线性关系,则称为多元线性回归。基于样本数据,通过最小二乘法可估计线性回归模型的参数,使得模型计算值与样本数据之间误差的平方和达到最小。
此外,还需进一步分析样本数据是否适合采用线性回归方法,即检验线性相关假设的合理性及线性模型的稳定性。这需要借助统计分析进行显著性检验,以确认因变量与自变量之间的线性关系是否显著,以及使用线性模型描述二者关系是否恰当。
2、Statsmodels 进行线性回归
本节结合Statsmodels统计分析包的使用,介绍线性拟合和回归分析的具体操作。线性模型可表达为如下公式:
2.1 导入工具包
import statsmodels.api as sm from statsmodels.sandbox.regression.predstd
import wls_prediction_std
2.2 导入样本数据
样本数据通常存储于数据文件中,因此需读取文件以获取样本数据。为便于阅读和测试程序,本文使用随机数生成样本数据。读取数据文件导入数据的具体方法将在后文介绍。
# 生成样本数据:
nSample = 100
x1 = np.linspace(0, 10, nSample) # 起点为 0,终点为 10,均分为 nSample个点
e = np.random.normal(size=len(x1)) # 正态分布随机数
yTrue = 2.36 + 1.58 * x1 # y = b0 + b1*x1
yTest = yTrue + e # 产生模型数据
本案例为一元线性回归问题,(yTest,x)为导入的样本数据,目标是通过线性回归获得因变量 y 与自变量 x 之间的定量关系。yTrue 代表理想模型的数值,yTest 为模拟实验检测的数据,即在理想模型基础上加入了正态分布的随机误差。
2.3 建模与拟合
一元线性回归模型方程为:
y = β0 + β1 * x + e
首先通过 sm.add_constant() 向矩阵 X 添加截距列,随后使用 sm.OLS() 建立普通最小二乘模型,最后调用 model.fit() 即可实现线性回归模型的拟合,并返回包含拟合结果与统计分析信息的摘要。
X = sm.add_constant(x1) # 向 x1 左侧添加截距列 x0=[1,…1] model = sm.OLS(yTest, X) # 建立最小二乘模型(OLS) results = model.fit() # 返回模型拟合结果
statsmodels.OLS 是 statsmodels.regression.linear_model 的函数,有 4个参数 (endog, exog, missing, hasconst)。
第一个参数 endog 代表回归模型中的因变量 y(t),其数据类型为1-d array。
第二个输入 exog 代表自变量 x0(t),x1(t),…,xm(t),其数据类型为(m+1)-d array。需要注意的是,statsmodels.OLS 的回归模型默认不包含常数项,其形式为: y = B*X + e = β0*x0 + β1*x1 + e, x0 = [1,…1] 而之前导入的数据 (yTest,x1) 并不包含 x0,因此需要在 x1 左侧增加一列截距列 x0=[1,…1],将自变量矩阵转换为 X = (x0, x1)。函数 sm.add_constant() 正是实现此功能。参数 missing 用于数据检查,hasconst 用于检查常量,一般情况下无需特别处理。
2.4 拟合和统计结果的输出
Statsmodels 进行线性回归分析时,输出结果十分丰富,results.summary() 用于返回回归分析的摘要信息。
print(results.summary()) # 输出回归分析的摘要
摘要返回的内容非常丰富,此处先讨论其中最重要的部分,即 summary 中间段落的内容。
==============================================================================
                 coef    std err          t      P>|t|      [0.025      0.975]
------------------------------------------------------------------------------
const          2.4669      0.186     13.230      0.000       2.097       2.837
x1             1.5883      0.032     49.304      0.000       1.524       1.652
==============================================================================
coef:回归系数(Regression coefficient),即模型参数 β0、β1、…的估计值。
std err :标准差( Standard deviation),也称标准偏差,是方差的算术平方根,反映样本数据值与回归模型估计值之间的平均差异程度。标准差越大,表明回归系数越不可靠。
t:t 统计量(t-Statistic),等于回归系数除以标准差,用于对每个回归系数分别进行检验,评估每个自变量对因变量的影响是否显著。若某个自变量 xi 的影响不显著,意味着可以考虑从模型中剔除该自变量。
P>|t|:t检验的 P值(Prob(t-Statistic)),反映每个自变量 xi 与因变量 y 的相关性假设的显著性。若 p<0.05,可理解为在0.05的显著性水平下,变量xi与y存在回归关系,具有统计显著性。
[0.025,0.975]:回归系数的置信区间(Confidence interval)的下限、上限,表示某个回归系数的置信区间以 95%的置信度包含该回归系数。需注意,这并非指样本数据落在这一区间的概率为 95%。
此外,还有一些重要指标需要关注:
R-squared:R方判定系数(Coefficient of determination),表示所有自变量对因变量的联合影响程度,用于度量回归方程拟合度的好坏,数值越接近于 1说明拟合程度越好。
F-statistic:F 统计量(F-Statistic),用于对整体回归方程进行显著性检验,评估所有自变量在整体上对因变量的影响是否显著。
Statsmodels 也支持通过属性直接获取所需的回归分析数据,例如:
print(“OLS model: Y = b0 + b1 * x”) # b0: 回归直线的截距,b1: 回归直线的斜率 print('Parameters: ', results.params) # 输出:拟合模型的系数 yFit = results.fittedvalues # 拟合模型计算出的 y值 ax.plot(x1, yTest, ‘o', label=“data”) # 原始数据 ax.plot(x1, yFit, ‘r-', label=“OLS”) # 拟合数据
3、一元线性回归
3.1 一元线性回归 Python 程序:
# LinearRegression_v1.py
# Linear Regression with statsmodels (OLS: Ordinary Least Squares)
# v1.0: 调用 statsmodels 实现一元线性回归
# 日期:2021-05-04
import numpy as np
import matplotlib.pyplot as plt
import statsmodels.api as sm
from statsmodels.sandbox.regression.predstd import wls_prediction_std
def main():  # 主程序
    # 生成测试数据:
    nSample = 100
    x1 = np.linspace(0, 10, nSample)  # 起点为 0,终点为 10,均分为 nSample个点
    e = np.random.normal(size=len(x1))  # 正态分布随机数
    yTrue = 2.36 + 1.58 * x1  #  y = b0 + b1*x1
    yTest = yTrue + e  # 产生模型数据
    # 一元线性回归:最小二乘法(OLS)
    X = sm.add_constant(x1)  # 向矩阵 X 添加截距列(x0=[1,...1])
    model = sm.OLS(yTest, X)  # 建立最小二乘模型(OLS)
    results = model.fit()  # 返回模型拟合结果
    yFit = results.fittedvalues  # 模型拟合的 y值
    prstd, ivLow, ivUp = wls_prediction_std(results) # 返回标准偏差和置信区间
    # OLS model: Y = b0 + b1*X + e
    print(results.summary())  # 输出回归分析的摘要
    print("\nOLS model: Y = b0 + b1 * x")  # b0: 回归直线的截距,b1: 回归直线的斜率
    print('Parameters: ', results.params)  # 输出:拟合模型的系数
    # 绘图:原始数据点,拟合曲线,置信区间
    fig, ax = plt.subplots(figsize=(10, 8))
    ax.plot(x1, yTest, 'o', label="data")  # 原始数据
    ax.plot(x1, yFit, 'r-', label="OLS")  # 拟合数据
    ax.plot(x1, ivUp, '--',color='orange',label="upConf")  # 95% 置信区间 上限
    ax.plot(x1, ivLow, '--',color='orange',label="lowConf")  # 95% 置信区间 下限
    ax.legend(loc='best')  # 显示图例
    plt.title('OLS linear regression ')
    plt.show()
    return
if __name__ == '__main__': #YouCans, XUPT
    main()
3.2 一元线性回归 程序运行结果:
OLS Regression Results
==============================================================================
Dep. Variable:                      y   R-squared:                       0.961
Model:                            OLS   Adj. R-squared:                  0.961
Method:                 Least Squares   F-statistic:                     2431.
Date:                Wed, 05 May 2021   Prob (F-statistic):           5.50e-71
Time:                        16:24:22   Log-Likelihood:                -134.62
No. Observations:                 100   AIC:                             273.2
Df Residuals:                      98   BIC:                             278.5
Df Model:                           1
Covariance Type:            nonrobust
==============================================================================
                 coef    std err          t      P>|t|      [0.025      0.975]
------------------------------------------------------------------------------
const          2.4669      0.186     13.230      0.000       2.097       2.837
x1             1.5883      0.032     49.304      0.000       1.524       1.652
==============================================================================
Omnibus:                        0.070   Durbin-Watson:                   2.016
Prob(Omnibus):                  0.966   Jarque-Bera (JB):                0.187
Skew:                           0.056   Prob(JB):                        0.911
Kurtosis:                       2.820   Cond. No.                         11.7
==============================================================================
OLS model: Y = b0 + b1 * x
Parameters:  [2.46688389 1.58832741]
4、多元线性回归
4.1 多元线性回归 Python 程序:
# LinearRegression_v2.py
# Linear Regression with statsmodels (OLS: Ordinary Least Squares)
# v2.0: 调用 statsmodels 实现多元线性回归
# 日期:2021-05-04
import numpy as np
import matplotlib.pyplot as plt
import statsmodels.api as sm
from statsmodels.sandbox.regression.predstd import wls_prediction_std
# 主程序
def main():  # 主程序
    # 生成测试数据:
    nSample = 100
    x0 = np.ones(nSample)  # 截距列 x0=[1,...1]
    x1 = np.linspace(0, 20, nSample)  # 起点为 0,终点为 10,均分为 nSample个点
    x2 = np.sin(x1)
    x3 = (x1-5)**2
    X = np.column_stack((x0, x1, x2, x3))  # (nSample,4): [x0,x1,x2,...,xm]
    beta = [5., 0.5, 0.5, -0.02] # beta = [b1,b2,...,bm]
    yTrue = np.dot(X, beta)  # 向量点积 y = b1*x1 + ...+ bm*xm
    yTest = yTrue + 0.5 * np.random.normal(size=nSample)  # 产生模型数据
    # 多元线性回归:最小二乘法(OLS)
    model = sm.OLS(yTest, X)  # 建立 OLS 模型: Y = b0 + b1*X + ... + bm*Xm + e
    results = model.fit()  # 返回模型拟合结果
    yFit = results.fittedvalues  # 模型拟合的 y值
    print(results.summary())  # 输出回归分析的摘要
    print("\nOLS model: Y = b0 + b1*X + ... + bm*Xm")
    print('Parameters: ', results.params)  # 输出:拟合模型的系数
    # 绘图:原始数据点,拟合曲线,置信区间
    prstd, ivLow, ivUp = wls_prediction_std(results) # 返回标准偏差和置信区间
    fig, ax = plt.subplots(figsize=(10, 8))
    ax.plot(x1, yTest, 'o', label="data")  # 实验数据(原始数据+误差)
    ax.plot(x1, yTrue, 'b-', label="True")  # 原始数据
    ax.plot(x1, yFit, 'r-', label="OLS")  # 拟合数据
    ax.plot(x1, ivUp, '--',color='orange', label="ConfInt")  # 置信区间 上届
    ax.plot(x1, ivLow, '--',color='orange')  # 置信区间 下届
    ax.legend(loc='best')  # 显示图例
    plt.xlabel('x')
    plt.ylabel('y')
    plt.show()
    return
if __name__ == '__main__':
    main()
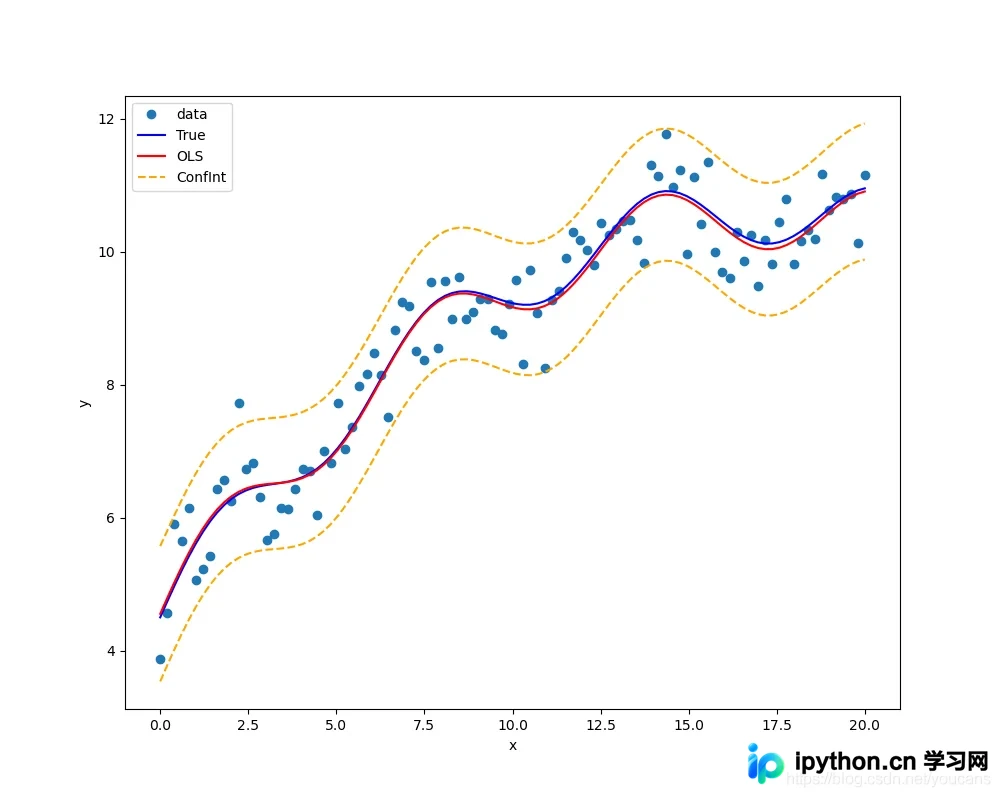
4.2 多元线性回归 程序运行结果:
OLS Regression Results
==============================================================================
Dep. Variable:                      y   R-squared:                       0.932
Model:                            OLS   Adj. R-squared:                  0.930
Method:                 Least Squares   F-statistic:                     440.0
Date:                Thu, 06 May 2021   Prob (F-statistic):           6.04e-56
Time:                        10:38:51   Log-Likelihood:                -68.709
No. Observations:                 100   AIC:                             145.4
Df Residuals:                      96   BIC:                             155.8
Df Model:                           3
Covariance Type:            nonrobust
==============================================================================
                 coef    std err          t      P>|t|      [0.025      0.975]
------------------------------------------------------------------------------
const          5.0411      0.120     41.866      0.000       4.802       5.280
x1             0.4894      0.019     26.351      0.000       0.452       0.526
x2             0.5158      0.072      7.187      0.000       0.373       0.658
x3            -0.0195      0.002    -11.957      0.000      -0.023      -0.016
==============================================================================
Omnibus:                        1.472   Durbin-Watson:                   1.824
Prob(Omnibus):                  0.479   Jarque-Bera (JB):                1.194
Skew:                           0.011   Prob(JB):                        0.551
Kurtosis:                       2.465   Cond. No.                         223.
==============================================================================
OLS model: Y = b0 + b1*X + ... + bm*Xm
Parameters:  [ 5.04111867  0.4893574   0.51579806 -0.01951219]
5、附录:回归结果详细说明
Dep.Variable: y 因变量 Model:OLS 最小二乘模型 Method: Least Squares 最小二乘 No. Observations: 样本数据的数量 Df Residuals:残差自由度(degree of freedom of residuals) Df Model:模型自由度(degree of freedom of model) Covariance Type:nonrobust 协方差阵的稳健性 R-squared:R 判定系数 Adj. R-squared: 修正的判定系数 F-statistic: 统计检验 F 统计量 Prob (F-statistic): F检验的 P值 Log likelihood: 对数似然 coef:自变量和常数项的系数,b1,b2,...bm,b0 std err:系数估计的标准误差 t:统计检验 t 统计量 P>|t|:t 检验的 P值 [0.025, 0.975]:估计参数的 95%置信区间的下限和上限 Omnibus:基于峰度和偏度进行数据正态性的检验 Prob(Omnibus):基于峰度和偏度进行数据正态性的检验概率 Durbin-Watson:检验残差中是否存在自相关 Skewness:偏度,反映数据分布的非对称程度 Kurtosis:峰度,反映数据分布陡峭或平滑程度 Jarque-Bera(JB):基于峰度和偏度对数据正态性的检验 Prob(JB):Jarque-Bera(JB)检验的 P值。 Cond. No.:检验变量之间是否存在精确相关关系或高度相关关系。
以上就是Python数学建模StatsModels统计回归之线性回归示例详解的详细内容,更多关于数学建模StatsModels统计回归之线性回归的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















