


Python使用Requests库抓取股票资金流向数据

本文详解如何使用Python的Requests库发起HTTP GET请求,通过构造特定的URL参数和Headers获取东方财富网的股票资金流向数据。接着利用正则表达式和JSON模块解析返回的嵌套数据结构,提取关键财务指标。最后结合Pandas库将清洗后的数据整理为DataFrame并导出为Excel文件,实现从数据采集到可视化的完整流程。
Requests库与GET请求基础
Requests是Python中用于发起HTTP请求的常用库,其操作简便且功能强大。当我们通过浏览器访问东旭蓝天股票的首页时,底层发送的最基础请求类型即为GET请求,此时需要向服务器传入相应的URL参数以获取数据。
构造请求URL与参数
import requests
url='http://push2his.eastmoney.com/api/qt/stock/fflow/daykline/get'
在Python中,可以使用requests库的get函数来接收服务器返回的数据。为了确保请求被正确识别,通常需要设置请求头(Headers),例如模拟浏览器的User-Agent信息。
设置请求头Headers
header={
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/86.0.4240.198 Safari/537.36'
}
在发起请求前,需要仔细分析Network面板中的请求参数。这些参数通常包括回调函数名、限制条数、K线类型、字段列表、安全标识、股票代码以及时间戳等,它们共同构成了请求的有效载荷。
分析网络请求参数
data={
    'cb': 'jQuery1123026726575651052076_1633873068863',
    'lmt': '0',
    'klt':' 101',
    'fields1': 'f1,f2,f3,f7',
    'fields2': 'f51,f52,f53,f54,f55,f56,f57,f58,f59,f60,f61,f62,f63,f64,f65',
    'ut': 'b2884a393a59ad64002292a3e90d46a5',
    'secid': '0.000040',
    '_': '1633873068864'
}
获取到服务器响应后,可以使用content属性提取返回的二进制数据,并将其赋值给变量sd,以便后续进行解码和处理。
获取响应内容
sd=requests.get(url=url,headers=header,data=data).contentPython的json库能够从字符串或文件中解析JSON格式的数据,并将其转换为Python字典或列表对象。同时,re模块提供了基于正则表达式的字符串匹配功能,可用于模糊匹配并提取所需的关键字符串部分。
数据解析与正则提取
import json
import re
text=str(sd,'utf-8')
res=re.findall(r'[(](.*?)[)]',text)
re=json.loads(res[0])
p=re['data']['klines']
为了将杂乱无章的原始数据整理成结构化的Excel表格,需要编写特定的代码逻辑。该代码负责解析数据字段,提取日期、价格、涨跌幅及各类资金净流入净额和占比等信息,并将其存入对应的列表中。
数据清洗与列表构建
all_list=re['data']['klines']
data_list=[]
latest_price_list=[]
price_limit_list=[]
net_amount_list1=[]
net_proportion_list1=[]
net_amount_list2=[]
net_proportion_list2=[]
net_amount_list3=[]
net_proportion_list3=[]
net_amount_list4=[]
net_proportion_list4=[]
net_amount_list5=[]
net_proportion_list5=[]
for i in range(len(all_list)):
        data=all_list[i].split(',')[0]
        data_list.append(data)
        ##收盘价
        latest_price=all_list[i].split(',')[11]
        latest_price_list.append(latest_price)
        ##涨跌幅
        price_limit=all_list[i].split(',')[12]
        price_limit_list.append(price_limit)
        ##主力净流入
        ####净额
        net_amount1=all_list[i].split(',')[1]
        net_amount_list1.append(net_amount1)
        ##占比
        net_proportion1=all_list[i].split(',')[6]
        net_proportion_list1.append(net_proportion1)
        ##超大单净流入
        ####净额
        net_amount2=all_list[i].split(',')[5]
        net_amount_list2.append(net_amount2)
        ##占比
        net_proportion2=all_list[i].split(',')[10]
        net_proportion_list2.append(net_proportion2)
        ##大单净流入
        ####净额
        net_amount3=all_list[i].split(',')[4]
        net_amount_list3.append(net_amount3)
        ##占比
        net_proportion3=all_list[i].split(',')[9]
        net_proportion_list3.append(net_proportion3)
        ##中单净流入
        ####净额
        net_amount4=all_list[i].split(',')[3]
        net_amount_list4.append(net_amount4)
        ##占比
        net_proportion4=all_list[i].split(',')[8]
        net_proportion_list4.append(net_proportion4)
        ##小单净流入
        ####净额
        net_amount5=all_list[i].split(',')[2]
        net_amount_list5.append(net_amount5)
        ##占比
        net_proportion5=all_list[i].split(',')[7]
        net_proportion_list5.append(net_proportion5)
#print(data_list)
Pandas导出Excel文件
import pandas as pd
df=pd.DataFrame()
df['日期'] = data_list
df['收盘价'] = latest_price_list
df['涨跌幅(%)'] = price_limit_list
df['主力净流入-净额'] = net_amount_list1
df['主力净流入-净占比(%)'] = net_proportion_list1
df['超大单净流入-净额'] = net_amount_list2
df['超大单净流入-净占比(%)'] = net_proportion_list2
df['大单净流入-净额'] = net_amount_list3
df['大单净流入-净占比(%)'] = net_proportion_list3
df['中单净流入-净额'] = net_amount_list4
df['中单净流入-净占比(%)'] = net_proportion_list4
df['小单净流入-净额'] = net_amount_list5
df['小单净流入-净占比(%)'] = net_proportion_list5
df# 写入excel
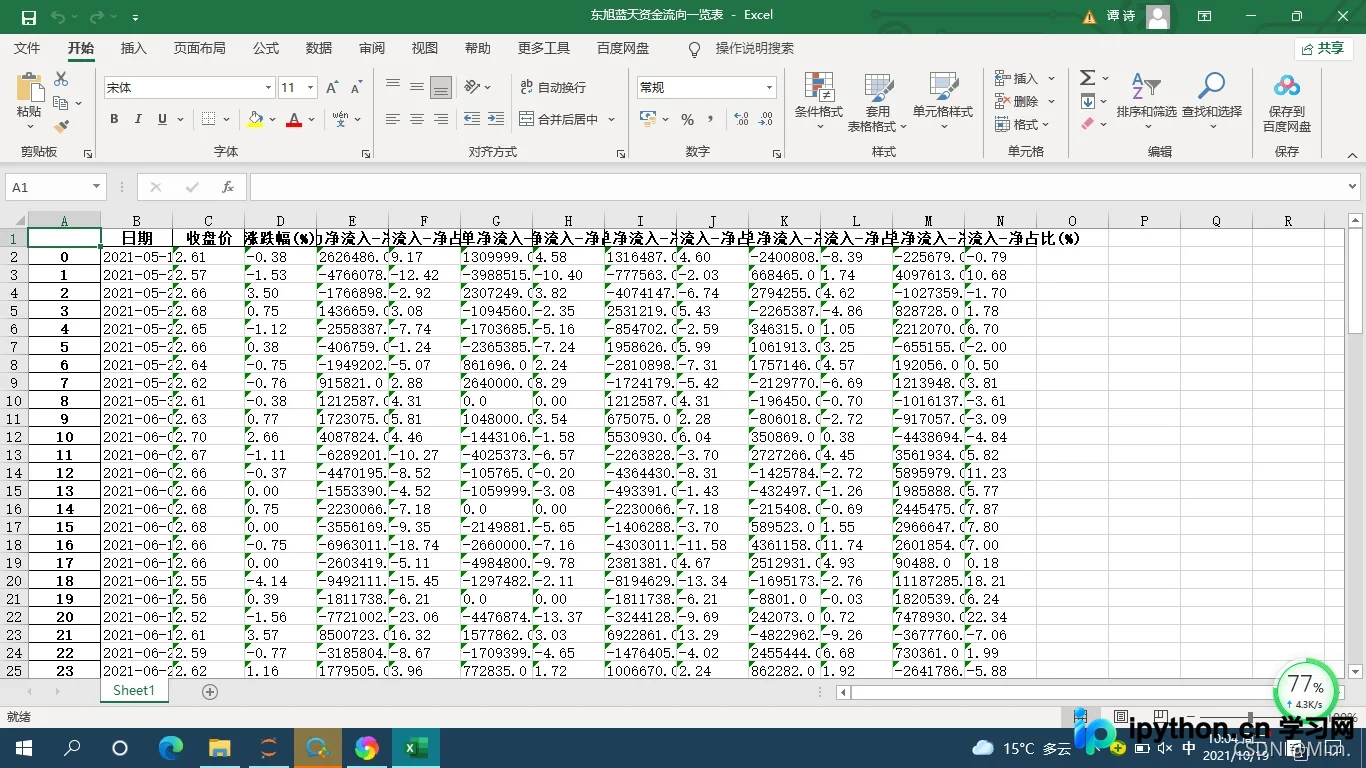
df.to_excel('东旭蓝天资金流向一览表.xlsx')
将爬取到的东旭蓝天资金流向数据保存至Excel文件中,生成的表格部分截图展示了处理后的结果,包括日期、收盘价、涨跌幅以及各类型资金的净流入情况。
至此,关于Python获取网页数据的详细流程介绍完毕。如需了解更多Python获取网页数据的相关内容,建议搜索本站历史文章或继续阅读后续文章,感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















