


Python爬虫基础:解决反爬机制的UA伪装技巧

本文介绍Python爬虫中常见的反爬机制及应对策略。通过requests库发起请求时,若未设置User-Agent,服务器可能识别为爬虫并拒绝访问。文章详细演示了如何获取浏览器的User-Agent值,并在代码中通过headers字典进行UA伪装,从而成功抓取特定网页数据。
简易网页搜集器
此前我们已掌握了基础的浏览器页面爬取方法。然而,实际应用场景往往更为复杂,我们的目标通常不是抓取搜狗或B站等首页,而是需要获取特定信息页面的内容。
在掌握基础爬取后,你是否尝试过抓取搜索引擎页面,例如百度?这类页面通常具有特定的结构。
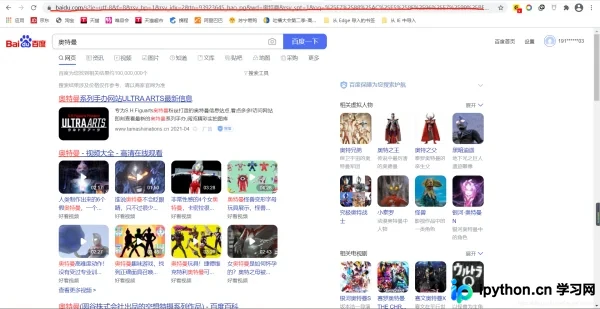
请注意图中红笔标注的区域,这代表当前打开的网页。我们的目标是抓取该页面的数据。按照之前的代码逻辑,实现方式如下:
import requests

if __name__ == "__main__":
    # 指定URL
    url = "https://www.baidu.com/s?ie=utf-8&f=8&rsv_bp=1&rsv_idx=2&tn=93923645_hao_pg&wd=%E5%A5%A5%E7%89%B9%E6%9B%BC&rsv_spt=1&oq=%25E7%2588%25AC%25E5%258F%2596%25E7%2599%25BE%25E5%25BA%25A6%25E9%25A6%2596%25E9%25A1%25B5&rsv_pq=b233dcfd0002d2d8&rsv_t=ccdbEuqbJfqtjnkFvevj%2BfxQ0Sj2UP88ixXHTNUNsmTa9yWEWTUEgxTta9r%2Fj3mXxDs%2BT1SU&rqlang=cn&rsv_dl=tb&rsv_enter=1&rsv_sug3=8&rsv_sug1=5&rsv_sug7=100&rsv_sug2=0&rsv_btype=t&inputT=1424&rsv_sug4=1424"

    # 发送请求
    response = requests.get(url)

    # 获取数据
    page_text = response.text

    # 存储
    with open("./奥特曼.html", "w", encoding = "utf-8") as fp:
        fp.write(page_text)

    print("爬取成功!!!")
然而,检查保存的文件后发现,结果与预期不符。
我们发现保存的文件内容为空白,这是为何?
为了更直观地说明问题,我们可以将网址替换为搜狗(由于网络环境限制,此处以百度为例,读者可自行尝试搜狗代码)。使用相同的代码逻辑,结果如下:
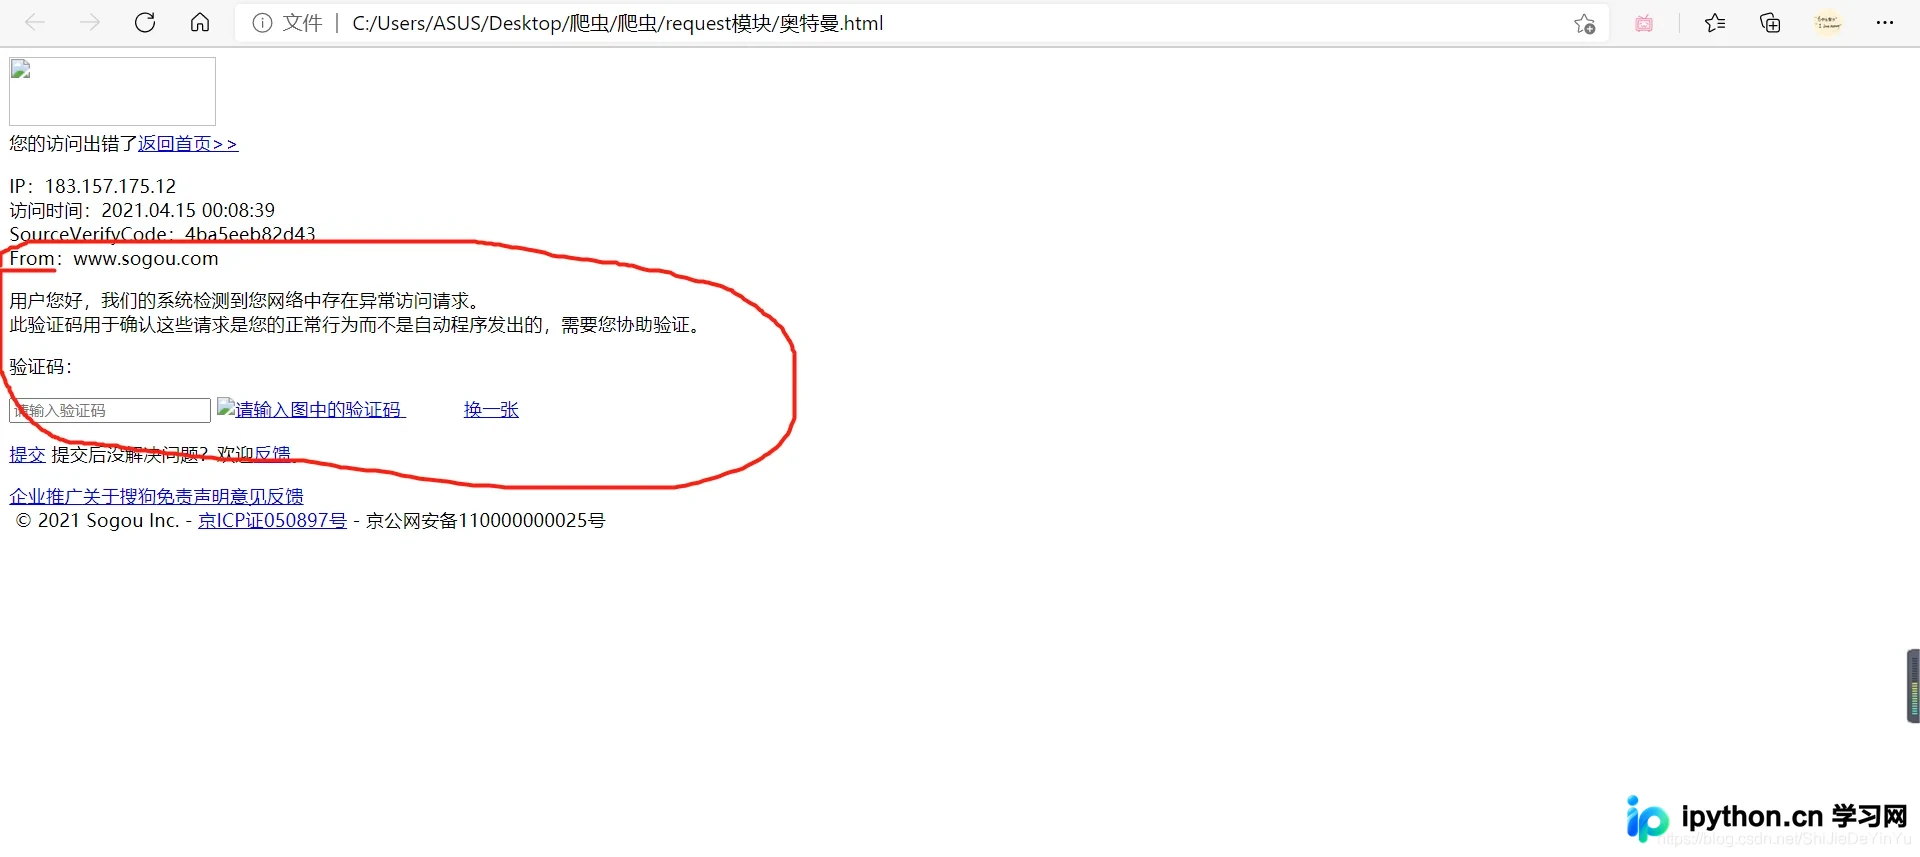
我们发现返回内容中包含“网络中存在异常访问”的提示,这代表什么含义?
这句话表明,搜狗或百度服务器已识别出发送请求的是爬虫程序,而非人工浏览器操作。
其背后的原理是什么?
简单来说,程序访问与人工浏览器访问存在差异。服务器通过User-Agent(UA)字段判断访问者身份:若识别为浏览器则接受请求,否则拒绝。这是常见的反爬机制。
这是否意味着我们束手无策?
并非如此。既然服务器通过User-Agent进行识别,我们可以让爬虫模拟浏览器的User-Agent。
在Python中,模拟输入数据或User-Agent通常使用字典结构。
具体写法如下:
header = {
	"user-agent": "" # user-agent 的值 是一个长字符串
	}
那么,User-Agent的值应如何获取?
1. 打开任意网页,右键点击并选择“检查”。
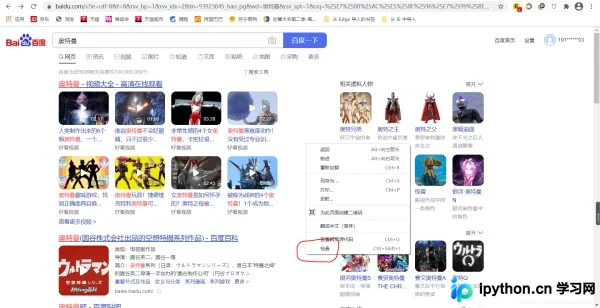
2. 选择“Network”(谷歌浏览器)或“网络”选项。
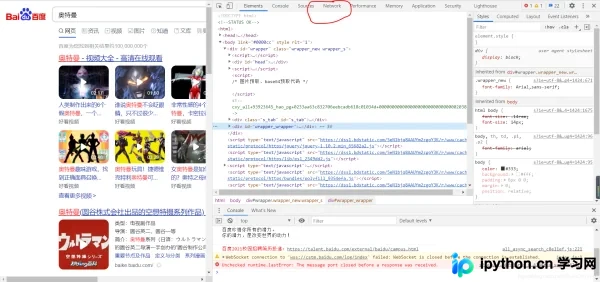
若打开后显示空白,请刷新网页。
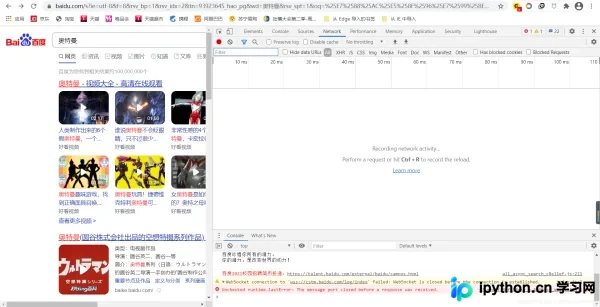
刷新后的界面如下:
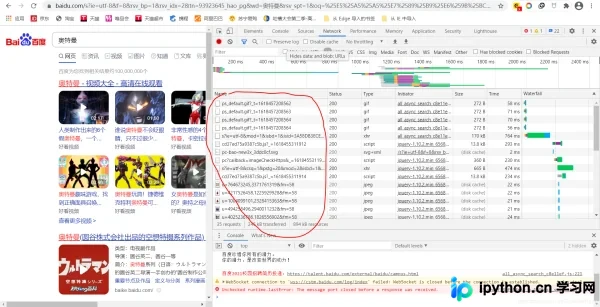
随机选择红圈标注的一项,展开详情并找到“user-agent”,复制其值即可。
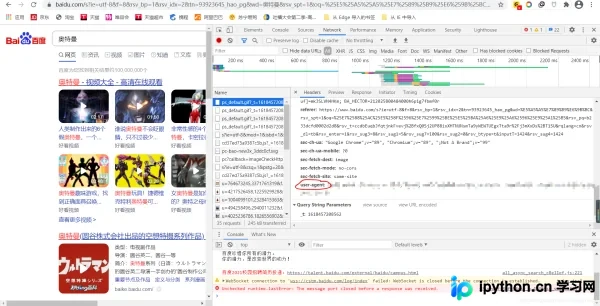
获取User-Agent后,重新编写爬取代码即可。
import requests

if __name__ == "__main__":
    # 指定URL
    url = "https://www.baidu.com/s?ie=utf-8&f=8&rsv_bp=1&rsv_idx=2&tn=93923645_hao_pg&wd=%E5%A5%A5%E7%89%B9%E6%9B%BC&rsv_spt=1&oq=%25E7%2588%25AC%25E5%258F%2596%25E7%2599%25BE%25E5%25BA%25A6%25E9%25A6%2596%25E9%25A1%25B5&rsv_pq=b233dcfd0002d2d8&rsv_t=ccdbEuqbJfqtjnkFvevj%2BfxQ0Sj2UP88ixXHTNUNsmTa9yWEWTUEgxTta9r%2Fj3mXxDs%2BT1SU&rqlang=cn&rsv_dl=tb&rsv_enter=1&rsv_sug3=8&rsv_sug1=5&rsv_sug7=100&rsv_sug2=0&rsv_btype=t&inputT=1424&rsv_sug4=1424"

    # 模拟 “user-agent”,即 UA伪装
    header = {
        "user-agent" : "" # 复制的 user-agent 的值
        }
    # 发送请求
    response = requests.get(url, headers = header)

    # 获取数据
    page_text = response.text

    # 存储
    with open("./奥特曼(UA伪装).html", "w", encoding = "utf-8") as fp:
        fp.write(page_text)

    print("爬取成功!!!")
再次运行程序并打开保存的文件。
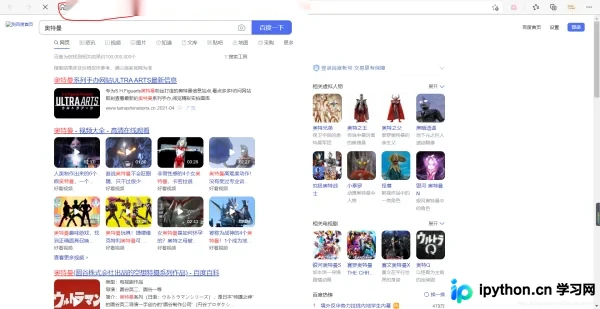
此次成功,说明爬虫程序已完美绕过服务器的反爬检测。
关于Python爬虫基础之简易网页搜集器的介绍到此结束。更多相关Python网页搜集器内容,请搜索本站历史文章或继续浏览后续内容,感谢支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















