


Python编码规范:彻底解决Python编码噩梦

本文详细解析Python中的编码问题,对比Python 3中str与bytes的区别,以及Python 2中unicode与str的差异。介绍如何使用chardet库检测编码格式,并演示编码与解码的具体操作。最后提供在Python 2和3中设置文件编码的两种实用方法,帮助开发者摆脱编码困扰。
博客原文:http://python.iswbm.com/en/latest/c01/c01_44.html
Github:https://github.com/iswbm/PythonCodingTime
在Python开发中,编码问题一直是许多开发者面临的难题。即便是经验丰富的资深开发者,也时常会被令人头疼的编码错误困扰。往往耗费半天时间才理清思路,但过段时间又容易遗忘,导致问题重现。
面对编码问题,开发者通常需要重新查阅各种博客和帖子,从头梳理编码、Unicode以及ASCII之间的区别,搞懂decode和encode报错的原因,并理清Python 2与Python 3中字符串类型的对应关系及检测方法。这一反复折腾的过程确实令人痛苦。
反反复复,这个过程真是太痛苦了。
今天我把大家在 Python 上会遇到的一些编码问题都讲清楚了,以后你可以不用再 Google,收藏这篇文章就行。
1. Python 3 中 str 与 bytes
在Python 3版本中,字符串主要包含两种类型:str和bytes。
今天就来说一说这二者的区别:
unicode string(str 类型):以 Unicode code points 形式存储,人类认识的形式
byte string(bytes 类型):以 byte 形式存储,机器认识的形式
在Python 3中,你定义的所有字符串,都是 unicode string类型,使用 type 和 isinstance 可以判别
# python3

>>> str_obj = "你好"
>>>
>>> type(str_obj)
<class 'str'>
>>>
>>> isinstance("你好", str)
True
>>>
>>> isinstance("你好", bytes)
False
>>>
而 bytes 是一个二进制序列对象,你只要你在定义字符串时前面加一个 b,就表示你要定义一个 bytes 类型的字符串对象。
# python3
>>> byte_obj = b"Hello World!"
>>> type(byte_obj)
<class 'bytes'>
>>>
>>> isinstance(byte_obj, str)
False
>>>
>>> isinstance(byte_obj, bytes)
True
>>>
但是在定义中文字符串时,你就不能直接在前面加 b 了,而应该使用 encode 转一下。
>>> byte_obj=b"你好"
  File "<stdin>", line 1
SyntaxError: bytes can only contain ASCII literal characters.
>>>
>>> str_obj="你好"
>>>
>>> str_obj.encode("utf-8")
b'\xe4\xbd\xa0\xe5\xa5\xbd'
>>>
2. Python 2 中 str 与 unicode
而在Python 2中,字符串的类型与Python 3有所不同,需要仔细区分。
在Python 2里,字符串也只有两种类型,unicode和str。
只有 unicode object 和 非unicode object(其实应该叫 str object) 的区别:
unicode string(unicode类型):以 Unicode code points 形式存储,人类认识的形式byte string(str 类型):以 byte 形式存储,机器认识的形式
当我们直接使用双引号或单引号包含字符的方式来定义字符串时,就是 str 字符串对象,比如这样
# python2

>>> str_obj="你好"
>>>
>>> type(str_obj)
<type 'str'>
>>>
>>> str_obj
'\xe4\xbd\xa0\xe5\xa5\xbd'
>>>
>>> isinstance(str_obj, bytes)
True
>>> isinstance(str_obj, str)
True
>>> isinstance(str_obj, unicode)
False
>>>
>>> str is bytes
True
而当我们在双引号或单引号前面加个 u,就表明我们定义的是 unicode 字符串对象,比如这样
# python2

>>> unicode_obj = u"你好"
>>>
>>> unicode_obj
u'\u4f60\u597d'
>>>
>>> type(unicode_obj)
<type 'unicode'>
>>>
>>> isinstance(unicode_obj, bytes)
False
>>> isinstance(unicode_obj, str)
False
>>>
>>> isinstance(unicode_obj, unicode)
True
3. 如何检测对象的编码
所有的字符,在 unicode 字符集中都有对应的编码值(英文叫做:code point)
而把这些编码值按照一定的规则保存成二进制字节码,就是我们说的编码方式,常见的有:UTF-8,GB2312 等。
也就是说,当我们要将内存中的字符串持久化到硬盘中的时候,都要指定编码方法,而反过来,读取的时候,也要指定正确的编码方法(这个过程叫解码),不然会出现乱码。
那问题就来了,当我们知道了其对应的编码方法,我们就可以正常解码,但并不是所有时候我们都能知道应该用什么编码方式去解码?
这时候就要介绍到一个 python 的库 – chardet ,使用它之前 需要先安装
python3 -m pip install chardet
chardet 有一个 detect 方法,可以 预测其其编码格式
>>> import chardet
>>> chardet.detect('微信公众号:Python编程时光'.encode('gbk'))
{'encoding': 'GB2312', 'confidence': 0.99, 'language': 'Chinese'}
为什么说是预测呢,通过上面的输出来看,你会看到有一个 confidence 字段,其表示预测的可信度,或者说成功率。
但是使用它时,若你的字符数较少,就有可能 “误诊”),比如只有 中文 两个字,就像下面这样,我们是 使用 gbk 编码的,使用 chardet 却识别成 KOI8-R 编码。
>>> str_obj = "中文"
>>> byte_obj = bytes(a, encoding='gbk')  # 先得到一个 gbk 编码的 bytes
>>>
>>> chardet.detect(byte_obj)
{'encoding': 'KOI8-R', 'confidence': 0.682639754276994, 'language': 'Russian'}
>>>
>>> str_obj2 = str(byte_obj, encoding='KOI8-R')
>>> str_obj2
'жпнд'
所以为了编码诊断的准确,要尽量使用足够多的字符。
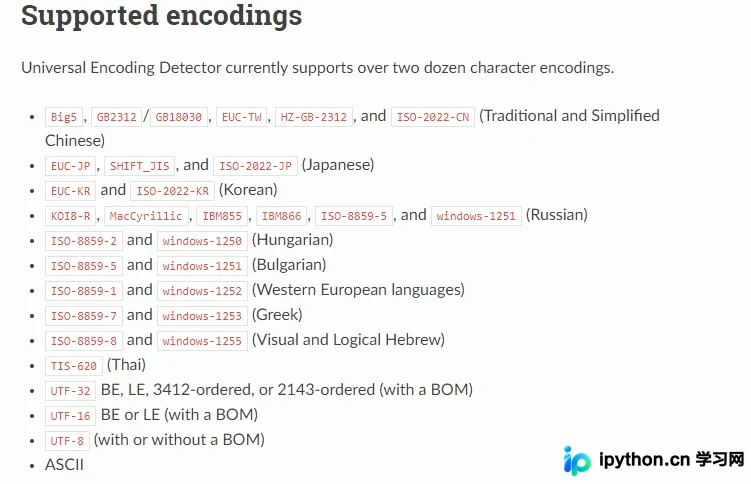
chardet 支持多国的语言,从官方文档中可以看到支持如下这些语言(https://chardet.readthedocs.io/en/latest/supported-encodings.html)
4. 编码与解码的区别
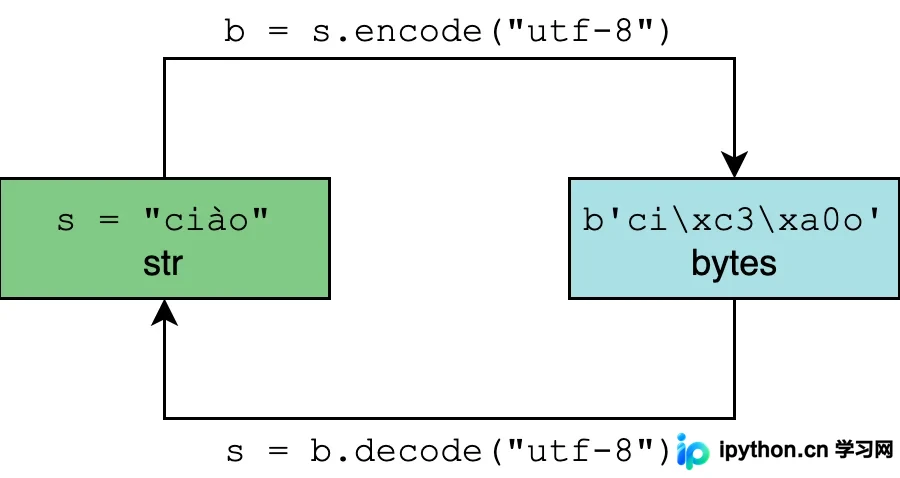
编码和解码,其实就是 str 与 bytes 的相互转化的过程(Python 2 已经远去,这里以及后面都只用 Python 3 举例)
编码:encode 方法,把字符串对象转化为二进制字节序列
解码:decode 方法,把二进制字节序列转化为字符串对象
那么假如我们真知道了其编码格式,如何来转成 unicode 呢?
有两种方法
第一种是,直接使用 decode 方法
>>> byte_obj.decode('gbk')
'中文'
>>>
第二种是,使用 str 类来转
>>> str_obj = str(byte_obj, encoding='gbk')
>>> str_obj
'中文'
>>>
5. 如何设置文件编码
在Python 2中,默认使用的是ASCII编码来读取的,因此,我们在使用Python 2的时候,如果你的python文件里有中文,运行是会报错的。
SyntaxError: Non-ASCII character '\xe4' in file demo.py
原因就是ASCII编码表太小,无法解释中文。
而在Python 3中,默认使用的是uft-8来读取,所以省了不少的事。
对于这个问题,通常解决方法有两种:
第一种方法
在python2中,可以使用在头部指定
可以这样写,虽然很好看
# -*- coding: utf-8 -*-
但这样写太麻烦了,我通常使用下面两种写法
# coding:utf-8
# coding=utf-8
第二种方法
import sys

reload(sys)
sys.setdefaultencoding('utf-8')
这里在调用sys.setdefaultencoding(‘utf-8') 设置默认的解码方式之前,执行了reload(sys),这是必须的,因为python在加载完sys之后,会删除 sys.setdefaultencoding 这个方法,我们需要重新载入sys,才能调用 sys.setdefaultencoding 这个方法。
以上就是Python编码技巧摆脱Python编码噩梦的详细内容,更多关于Python编码的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















