


Python实现CART决策树算法及详细注释

本文深入解析CART(分类回归树)算法原理,重点阐述其利用基尼系数进行特征选择的机制。通过Python代码示例,详细演示如何构建二叉决策树,涵盖从数据划分到递归生成的完整流程。文章对比了CART与ID3、C4.5的区别,并提供了二分类场景下的简化实现代码及运行结果分析,适合希望掌握决策树底层逻辑的开发者参考。
一、CART决策树算法简介
CART(Classification And Regression Trees,分类回归树)是一种通用的树构建算法,支持分类与回归两种任务。与仅能处理离散数据且限于分类任务的ID3和C4.5算法不同,CART的适用范围更广,既能处理离散型数据,也能处理连续型数据,同时覆盖分类和回归场景。
本文仅聚焦于基础CART分类决策树的构建过程,暂不涉及回归树及剪枝策略的讨论。
在开始之前,需明确两个关键点: 1. CART算法生成的决策树为二叉树,而ID3和C4.5生成的是多叉树。从计算效率来看,二叉树模型通常比多叉树具有更高的运算效率,因此CART常用于二分类场景。 2. CART算法通过计算基尼(Gini)指数来选择最优划分特征。
二、基尼系数
基尼系数用于衡量模型的不纯度。基尼系数越小,表示不纯度越低。需要注意的是,这与C4.5算法中信息增益比的定义逻辑相反。
在分类问题中,假设数据集包含K个类别,样本属于第k类的概率为pk,则概率分布的基尼系数定义如下:
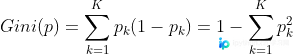
若CART应用于二分类问题(尽管它不限于此),概率分布的基尼系数可简化为:
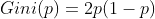
假设使用特征A将数据集D划分为子集D1和D2,此时按特征A划分后的数据集基尼系数计算公式为:
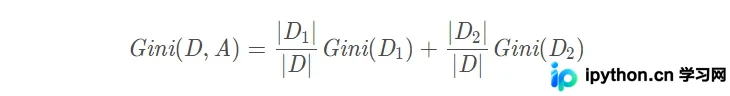
三、CART决策树生成算法
输入:训练数据集D,停止计算的条件 输出:CART决策树 基于训练数据集,从根节点开始,递归执行以下操作以构建二叉决策树: (1)计算当前所有特征对该数据集的基尼指数(参考前述公式); (2)选取基尼指数最小的特征作为最优特征,其对应的切分点为最优切分点(若存在多个最小值,任选其一即可); (3)依据最优特征和最优切分点,从当前节点生成两个子节点,并将训练数据按特征属性分配至对应的子节点中; (4)对两个子节点递归执行步骤(1)至(3),直到满足停止条件。 (5)生成最终的CART树。 算法停止条件包括:节点中样本数量小于预设阈值、样本集的基尼指数低于预设阈值(即样本基本属于同一类,若完全属于同一类则基尼指数为0),或特征集合为空。 注:最优切分点是当前样本划分为两类(因需构建二叉树)的必要条件。对于离散特征,最优切分点对应最优特征的某个取值;对于连续特征,最优切分点可以是某个具体数值。实际应用中需遍历所有可能的切分点取值以寻找最优解。
四、CART算法的Python实现
针对二分类问题,函数calcGini和choose_best_feature可简化如下实现:
# 计算样本属于第1个类的概率p
def calcProbabilityEnt(dataset):
    numEntries = len(dataset)
    count = 0
    label = dataset[0][len(dataset[0]) - 1]
    for example in dataset:
        if example[-1] == label:
            count += 1
    probabilityEnt = float(count) / numEntries
    return probabilityEnt

def choose_best_feature(dataset):
    # 特征总数
    numFeatures = len(dataset[0]) - 1
    # 当只有一个特征时
    if numFeatures == 1:
        return 0
    # 初始化最佳基尼系数
    bestGini = 1
    # 初始化最优特征
    index_of_best_feature = -1
    for i in range(numFeatures):
        # 去重,每个属性值唯一
        uniqueVals = set(example[i] for example in dataset)
        # 定义特征的值的基尼系数
        Gini = {}
        for value in uniqueVals:
            sub_dataset1, sub_dataset2 = split_dataset(dataset,i,value)
            prob1 = len(sub_dataset1) / float(len(dataset))
            prob2 = len(sub_dataset2) / float(len(dataset))
            probabilityEnt1 = calcProbabilityEnt(sub_dataset1)
            probabilityEnt2 = calcProbabilityEnt(sub_dataset2)
            Gini[value] = prob1 * 2 * probabilityEnt1 * (1 - probabilityEnt1) + prob2 * 2 * probabilityEnt2 * (1 - probabilityEnt2)
            if Gini[value] < bestGini:
                bestGini = Gini[value]
                index_of_best_feature = i
                best_split_point = value
    return index_of_best_feature, best_split_point
五、运行结果

至此,关于Python实现CART决策树算法及详细注释的介绍已完成。如需了解更多Python决策树算法相关内容,建议查阅本站历史文章或继续阅读后续相关文章,感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















