


为什么Python是人工智能和数据分析的首选语言

在人工智能与数据分析领域,工程落地的核心诉求是快速验证数学思想、高效清洗多维数据,并将算法无缝部署到异构计算硬件上。Python之所成为该领域的通用标准,本质上在于它扮演了高效率的“调度中枢”——开发者用极其直观的语法编写业务逻辑,底层则直接调动由C、C++及CUDA优化的高性能计算内核。理解这一分工,是掌握现代AI与数据科学技术栈的关键起点。
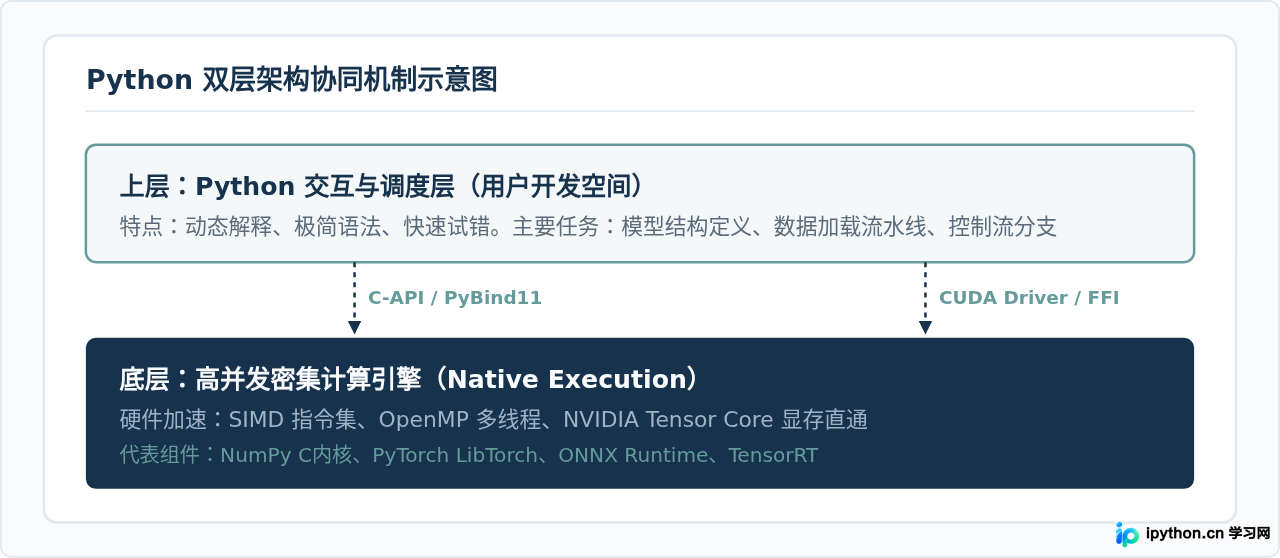
双层执行机制:兼顾开发效率与底层性能
很多初学者常有一个疑问:Python运行速度偏慢,为什么需要高频矩阵计算的AI和大数据领域偏偏选它?答案在于Python独特的架构定位。在数据科学体系中,Python并不直接承担密集数值的底层循环计算,而是作为顶层API与胶水层存在。
以矩阵乘法为例,当我们在Python中调用矩阵运算时,实际执行代码的是底层的BLAS/LAPACK库或NVIDIA CUDA核心,运行效率与纯C/C++原生代码相当。Python负责分配任务、定义输入形状并获取计算结果,避开了底层繁杂的指针管理和内存分配。
一致且高表达力的数据科学语法
数学家与数据科学家希望将精力集中在数学推导和逻辑分析上,而非语言本身的语法噪音。Python的设计哲学强调代码的可读性,其切片操作、列表推导式与运算符重载机制,能以接近数学符号的形式直接表达矩阵运算与条件过滤。
例如,对一个结构化数据表执行条件筛选并求均值,传统的静态编译语言往往需要多层嵌套循环和类型转换,而Python配合常用数据处理库仅需直观的一行表达式即可完成:
# 演示:针对数据框的高可读性过滤与聚合计算
import pandas as pd

# 构建示例结构化数据
data = {
    "device_id": ["A-1", "A-2", "B-1", "B-2", "A-3"],
    "error_rate": [0.012, 0.045, 0.008, 0.091, 0.021],
    "region": ["East", "West", "East", "North", "East"]
}
df = pd.DataFrame(data)

# 仅需一行即可表达业务逻辑:筛选 East 区域且 error_rate 小于 0.03 的均值
avg_error = df[ (df["region"] == "East") & (df["error_rate"] < 0.03) ]["error_rate"].mean()

print(f"计算结果: {avg_error:.4f}")
# 示例输出:计算结果: 0.0165
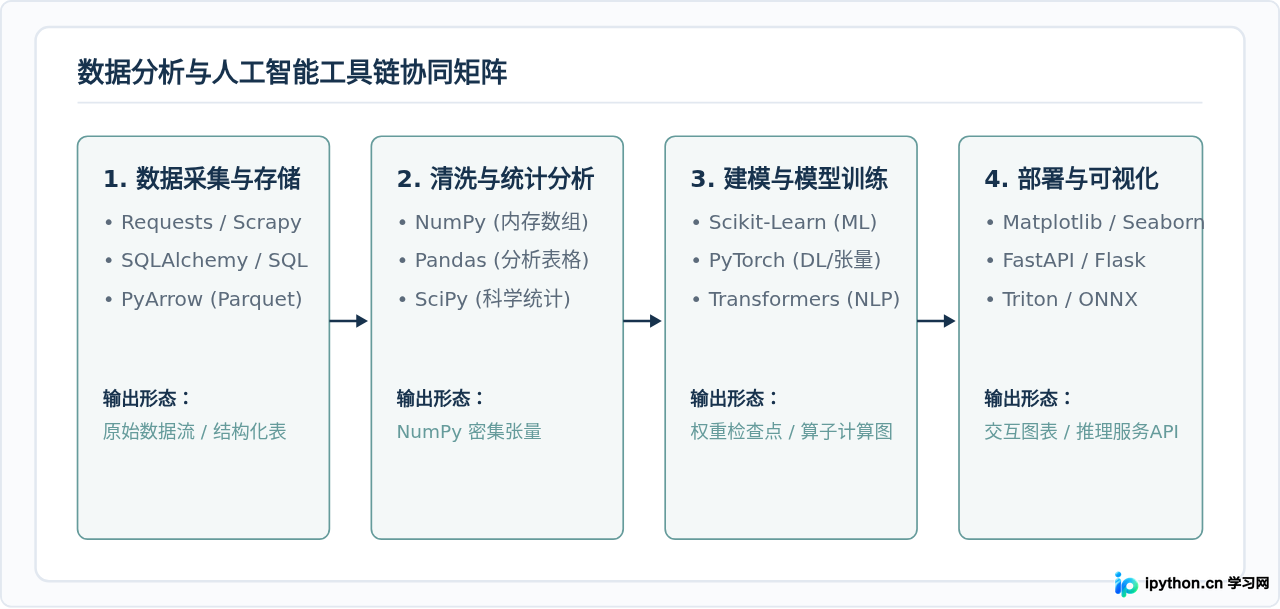
无缝衔接的完整生态链协同
一门编程语言能够在某一垂直领域确立标准地位,往往取决于其配套生态是否完整。Python拥有在数据分析和AI领域高度互通的标准对象模型。NumPy提供的 ndarray 结构成为了工业界统一的内存数据交换格式,使得数据采集、清洗、训练与可视化能够紧密串联,无需在各环节之间编写繁琐的数据格式转换代码。
技术特性横向对比:主流语言的应用定位
每种语言都有其最适合的场景。理解Python为何胜出,最好的方式是将它与工程中常见的其他主流语言进行横向技术对比:
| 语言 | 典型定位 | 主要优势 | AI与分析领域的局限 |
|---|---|---|---|
| Python | 科学计算中枢、AI研究与应用调度 | 极低的研发门槛、庞大的专业库群、生态统一 | 单线程纯解释执行较慢,需依赖底层C/C++拓展 |
| C / C++ | 高性能算子实现、嵌入式端侧推理 | 近乎极致的执行性能、硬件内存精准控制 | 代码编写繁琐、开发周期长、难以快速做交互式探索 |
| Java | 企业级后台、分布式离线大数据体系 | 强健的类型系统、Hadoop/Spark底座成熟 | GPU硬件级绑定偏弱,AI算法原型开发滞后 |
| R | 学术统计建模、生物信息学分析 | 内置统计方法丰富、数据绘图精美完备 | 通用工程集成能力相对受限,工业级AI生态偏小 |
| Julia | 数值计算、微分方程求解 | 避免“双语言问题”(兼顾C的高性能与Python语法) | 社区生态起步较晚,行业历史积淀与通用库较少 |
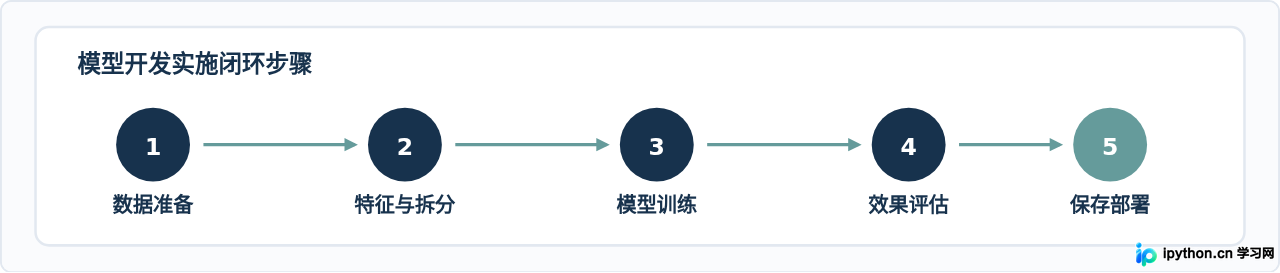
实践工作流:从特征工程到模型预测
为了直观展现Python在日常研发中的流程组织,以下给出一个典型的数据分析与机器学习标准开发步骤。代码展示了特征构造、训练集划分、模型拟合以及评估打分的全过程:
# 完整可运行范例:使用 Scikit-Learn 完成分类任务构建
import numpy as np
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score

# 步骤 1 & 2: 生成模拟工业特征数据集并切分
X, y = make_classification(
    n_samples=1000,
    n_features=10,
    n_informative=5,
    random_state=42
)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# 步骤 3: 实例化模型并拟合
model = RandomForestClassifier(n_estimators=50, random_state=42)
model.fit(X_train, y_train)

# 步骤 4: 推理验证与评估
predictions = model.predict(X_test)
accuracy = accuracy_score(y_test, predictions)

print(f"验证集分类准确率: {accuracy:.2%}")
# 示例输出:验证集分类准确率: 87.50%for 循环对数百万条数据逐行操作,应优先使用 Pandas/NumPy 的向量化算子(Vectorization),这样计算指令会自动下沉至底层 C 库中并发执行,避免造成数十倍的运行延迟。
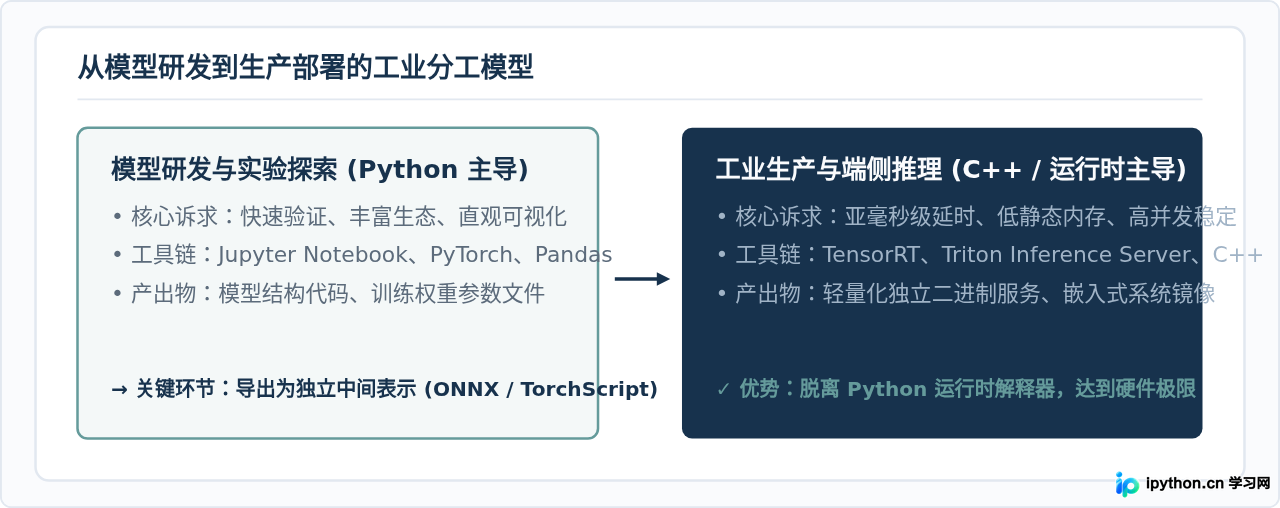
工业落地的边界与权衡
虽然Python在研发实验和算法构建阶段无可替代,但在实际工程架构中,仍需正视其性能边界,合理进行系统分工:
- 内存开销(Memory Footprint):Python动态对象的元数据包装会导致较大的内存膨胀。在处理超大规模单机数据时,推荐使用内存映射(Memory Mapping)技术,或采用 Polars、DuckDB 等列式存储引擎提升局部性。
- 全局解释器锁(GIL):虽然近年多解释器模式(PEP 684)等特性持续演进,但在CPU密集型原生并发场景下,直接使用原生Python多线程仍受限制。工业界一般采用多进程(Multiprocessing)调度,或直接交由C++计算线程池接管。
- 边缘部署与推理交付:模型在Python环境完成探索与训练后,生产上线通常会导出为 ONNX 或 TensorRT 格式,并由 C++ 或 Go 编写的高并发轻量服务进行加载,以追求更低的系统延时与更高的吞吐量。
总结
Python之所以成为人工智能与数据分析领域事实上的行业标准,并不是因为它的运行速度有多快,而是因为它在研发交互效率与底层计算性能之间找到了绝佳的平衡点:
- 分工合理:顶层代码负责快速推演业务逻辑,底层原生模块与GPU驱动专职处理矩阵加速。
- 生态自洽:从最底层的数据存储格式到顶层的深度学习算法框架,形成了无缝互通的闭环。
- 社区协同:全球学术界与工业界将最新算法的第一版实现优先开源在Python生态中,使Python的领先优势形成了自我强化的良性循环。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















