


Python多线程编程详解:从基础概念到GIL与同步机制

本文深入解析Python多线程编程核心概念,对比进程与线程在CPU密集与IO密集型任务中的适用性。详细讲解Thread类常用方法如start、join及生命周期,剖析GIL对Python多线程的限制,并介绍通过Lock和Semaphore实现线程同步与并发控制的最佳实践。
1.自定义进程
通过继承Process类并重写run方法来定义自定义进程。
from multiprocessing import Process
import time
import os
class MyProcess(Process):
    def __init__(self, name):  ##重写,需要__init__,也添加了新的参数。        ##Process.__init__(self) 不可以省略,否则报错:AttributeError:'XXXX'object has no attribute '_colsed'
        Process.__init__(self)
        self.name = name
    def run(self):
        print("子进程(%s-%s)启动" % (self.name, os.getpid()))
        time.sleep(3)
        print("子进程(%s-%s)结束" % (self.name, os.getpid()))
if __name__ == '__main__':
    print("父进程启动")
    p = MyProcess("Ail")
    # 自动调用MyProcess的run()方法
    p.start()
    p.join()
    print("父进程结束")
# 输出结果 父进程启动 子进程(Ail-38512)启动 子进程(Ail-38512)结束 父进程结束
2.进程与线程
多进程适用于CPU密集型操作,例如科学计算或高精度浮点运算等涉及大量CPU指令的场景;
多线程适用于IO密集型操作,如数据读写、爬虫抓取、文件上传或下载等I/O交互频繁的任务。
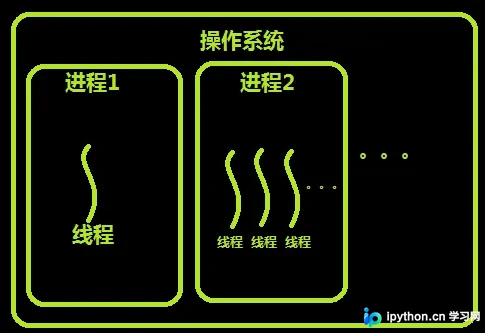
线程体现的是并发执行,而进程体现的是并行执行:进程之间相互独立,是系统分配资源的最小单位;同一进程内的所有线程共享该进程的资源。
进程指一个正在运行的程序或代码实例,未运行的代码称为程序。进程是操作系统进行资源分配的最小单位,拥有独立的内存空间,因此进程间数据不共享,且系统开销较大。
进程是程序的一次动态执行过程。每个进程都拥有独立的地址空间、内存、数据栈以及其他用于跟踪执行的辅助数据结构。操作系统负责调度所有进程的执行,并为它们合理分配执行时间片。
线程是调度执行的最小单位,也称为执行路径,它不能独立存在,必须依附于进程。一个进程至少包含一个线程,即主线程。多个线程共享内存空间(包括数据共享和全局变量),从而提升程序的运行效率。
线程是操作系统进行运算调度的最小单位,它包含在进程内部,是进程中的实际运作单元。一条线程代表进程中一个单一顺序的控制流,一个进程可以并发多个线程,每条线程并行执行不同的任务。一个线程是一个execution context(执行上下文),即CPU执行所需的一串指令集合。
主线程是指在创建线程进程时产生的第一个线程,对应于main函数执行的线程。
协程是用户态的轻量级线程,其调度由用户控制,拥有独立的寄存器上下文和栈,切换时几乎没有内核切换的开销,具有极高的切换灵活性。
进程和线程的关系
3.多线程
操作系统通过为不同线程分配时间片(CPU运行时长)来调度线程。当CPU执行完一个线程的时间片后,会快速切换到下一个线程。由于时间片极短且切换速度极快,用户通常无法察觉。多个线程根据分配的时间片轮流被CPU执行,如今绝大多数计算机的CPU都是多核架构,在操作系统的调度下,多个线程能够被多个CPU并行执行,从而大幅提升程序的执行速度和CPU利用效率。绝大多数主流编程语言都很好地支持多线程,然而,Python由于GIL(全局解释器锁)的存在,无法实现真正的多线程并行加速。
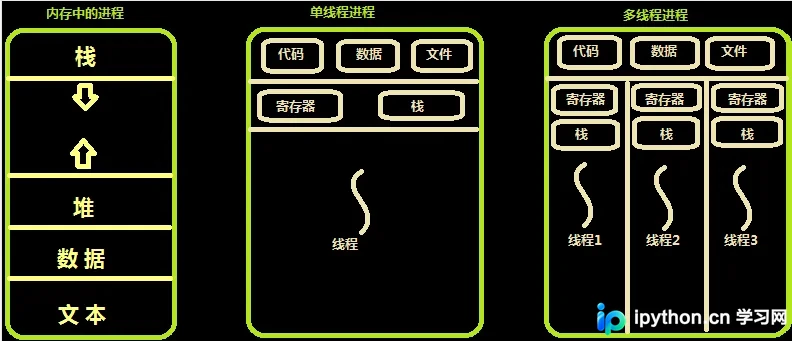
内存中的线程
4.Thread类方法
(1)start() --开始执行该线程;
(2)run() --定义线程的方法(开发者可以在子类中重写);标准的 run() 方法会对作为 target 参数传递给该对象构造器的可调用对象(如果存在)发起调用,并附带从 args 和 kwargs 参数分别获取的位置和关键字参数。
(3)join(timeout=None) --直至启动的线程终止之前一直挂起;除非给出了timeout(单位秒),否则一直被阻塞;因为 join() 总是返回 None ,所以要在 join() 后调用 is_alive() 才能判断是否发生超时 -- 如果线程仍然存活,则 join() 超时。一个线程可以被 join() 很多次。如果尝试加入当前线程会导致死锁, join() 会引起 RuntimeError 异常。如果尝试 join() 一个尚未开始的线程,也会抛出相同的异常。
(4)is_alive() --布尔值,表示这个线程是否还存活;当 run() 方法刚开始直到 run() 方法刚结束,这个方法返回 True 。
(5)threading.current_thread()--返回当前对应调用者的控制线程的 Thread 对象。例如,获取当前线程的名字,可以是current_thread().name。
5.多线程与多进程小Case
from threading import Thread
from multiprocessing import Process
import os
def work():
    print('hello,',os.getpid())
if __name__ == '__main__':
    # 在主进程下开启多个线程,每个线程都跟主进程的pid一样
    t1 = Thread(target=work)  # 开启一个线程
    t2 = Thread(target=work)  # 开启两个线程
    t1.start()  ##start()--It must be called at most once per thread object.It arranges for the object's run() method to be                ## invoked in a separate thread of control.This method will raise a RuntimeError if called more than once on the                ## same thread object.
    t2.start()
    print('主线程/主进程pid', os.getpid())
    # 开多个进程,每个进程都有不同的pid
    p1 = Process(target=work)
    p2 = Process(target=work)
    p1.start()
    p2.start()
    print('主线程/主进程pid',os.getpid())
6.Thread 的生命周期
线程的状态包括:创建、就绪、运行、阻塞、结束。
(1)创建对象时,代表 Thread 内部被初始化;
(2) 调用 start() 方法后,thread 会开始进入队列准备运行,在未获得CPU、内存资源前,称为就绪状态;轮询获取资源,进入运行状态;如果遇到sleep,则是进入阻塞状态;
(3) thread 代码正常运行结束或者是遇到异常,线程会终止。
7.自定义线程
(1)定义一个类,继承Thread;
(2)重写__init__ 和 run();
(3)创建线程类对象;
(4)启动线程。
import time
import threading
class MyThread(threading.Thread):
    def __init__(self,num):
        super().__init__() ###或者是Thread.__init__()
        self.num = num
    def run(self):
        print('线程名称:', threading.current_thread().getName(), '参数:', self.num, '开始时间:', time.strftime('%Y-%m-%d %H:%M:%S'))
if __name__ == '__main__':
    print('主线程开始:',time.strftime('%Y-%m-%d %H:%M:%S'))
    t1 = MyThread(1)
    t2 = MyThread(2)
    t1.start()
    t2.start()
    t1.join()
    t2.join()
    print('主线程结束:', time.strftime('%Y-%m-%d %H:%M:%S'))
8.线程共享数据与GIL(全局解释器锁)
如果是全局变量,则每个线程是共享的;
GIL锁:可以用篮球比赛的场景来模拟,把篮球场看作是CPU,一场篮球比赛看作是一个线程,如果只有一个篮球场,多场比赛就要排队进行,类似于一个简单的单核多线程的程序;如果由多块篮球场,多场比赛同时进行,就是一个简单的多核多线程的程序。然而,Python有着特别的规定:每场比赛必须要在裁判的监督之下才允许进行,而裁判只有一个。这样不管你有几块篮球场,同一时间只允许有一个场地进行比赛,其它场地都将被闲置,其它比赛都只能等待。
9.GIL 和 Lock
GIL保证同一时间内一个进程可以有多个线程,但只有一个线程在执行;锁的目的是为了保护共享的数据,同一时间只能有一个线程来修改共享的数据。
类为threading.Lock
它有两个基本方法, acquire() 和 release() 。
当状态为非锁定时, acquire() 将状态改为 锁定 并立即返回。当状态是锁定时, acquire() 将阻塞至其他线程调用 release() 将其改为非锁定状态,然后 acquire() 调用重置其为锁定状态并返回。
release() 只在锁定状态下调用; 它将状态改为非锁定并立即返回。如果尝试释放一个非锁定的锁,则会引发 RuntimeError 异常。
Caese 如下:
from threading import Thread
from threading import Lock
import time
number = 0
def task(lock):
    global number
    lock.acquire() ##持有锁
    for i in range(100000)      number += 1
    lock.release() ##释放锁
if __name__ == '__main__':
    lock=Lock()
    t1 = Thread(target=task,args=(lock,))
    t2 = Thread(target=task,args=(lock,))    t3 = Thread(target=task,args=(lock,))
    t1.start()    t2.start()    t3.start()    t1.join()    t2.join()    t3.join()        print('number:',number)
10.线程的信号量
class threading.Semaphore([values])
values是一个内部计数,values默认是1,如果小于0,则会抛出 ValueError 异常,可以用于控制线程数并发数。
信号量的实现方式:
s=Semaphore(?)
在内部有一个counter计数器,counter的值就是同一时间可以开启线程的个数。每当我们s.acquire()一次,计数器就进行减1处理,每当我们s.release()一次,计数器就会进行加1处理,当计数器为0的时候,其它的线程就处于等待的状态。
程序添加一个计数器功能(信号量),限制一个时间点内的线程数量,防止程序崩溃或其它异常。
Case
import time
import threading
s=threading.Semaphore(5)    #添加一个计数器
def task():
    s.acquire()    #计数器获得锁
    time.sleep(2)    #程序休眠2秒
    print("The task run at ",time.ctime())
    s.release()    #计数器释放锁

for i in range(40):
    t1=threading.Thread(target=task,args=())    #创建线程
    t1.start()    #启动线程
也可以使用with操作,替代acquire ()和release(),上面的代码调整如下:
import time
import threading
s=threading.Semaphore(5)    #添加一个计数器
def task():    with s:   ## 类似打开文件的with操作
    ##s.acquire()    #计数器获得锁
      time.sleep(2)    #程序休眠2秒
      print("The task run at ",time.ctime())
    ##s.release()    #计数器释放锁

for i in range(40):
    t1=threading.Thread(target=task,args=())    #创建线程
    t1.start()    #启动线程
建议使用with。
总结
本篇文章就到这里了,希望能够给你带来帮助,也希望您能够多多关注本站的更多内容!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















