


Python 高效查找最大文件的实现方案

发布时间:2026-10-14 |
2人浏览过
本文介绍如何使用 Python 快速定位占用空间最大的文件以释放磁盘空间。通过遍历目录并结合 heapq 模块的大顶堆算法,可高效筛选出指定数量的最大文件。文中提供了适用于 macOS/Linux 和 Windows 系统的完整代码示例及性能测试结果,帮助开发者快速清理冗余数据。
背景与问题概述
当前计算机普遍采用固态硬盘,尽管读写速度显著提升,但存储容量往往有限,导致磁盘空间不足的情况时有发生。面对此类问题,删除体积庞大的非必要文件是释放空间最直接且有效的手段。
那么,如何高效地识别出这些占用空间最大的文件?例如,我们需要找出体积最大的前 10 个文件。
核心思路如下:首先遍历指定目录,利用生成器依次返回文件路径及其大小;随后,将这些数据插入一个容量为 10 的大顶堆中;最后,从堆中提取并打印结果即可。
Python 实现方案与代码示例
借助 Python 语言,实现该逻辑的代码非常简洁:
import os
import time

from os.path import join, getsize
from heapq import nlargest


def walk_files_and_sizes(start_at: str):
    for root, _, files in os.walk(start_at):
        for file in files:
            path = join(root, file)
            try:
                size = getsize(path)  # bytes
                yield path, size
            except OSError:
                continue


def largest_files(n: int, start_at: str) -> None:
    MB = 1024 * 1024
    largest = nlargest(n, walk_files_and_sizes(start_at), key=lambda x: x[1])

    for path, size in largest:
        print(f'{size//MB} MB {path}')


if __name__ == '__main__':
    start = time.perf_counter()
    largest_files(10, "/Users/aaron/")
    elapsed = time.perf_counter() - start
    print(f'{elapsed} seconds elapsed')
在实际测试中,对容量约为 200 GB 的目录进行扫描,整个流程仅需 123 秒即可完成:
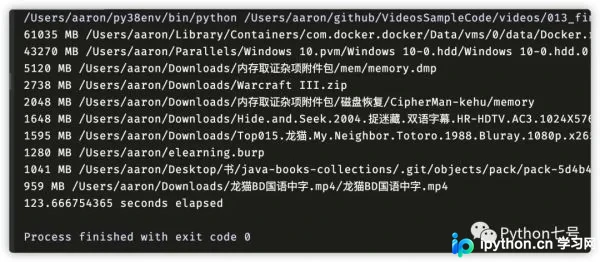
确认目标文件后,即可执行删除操作以释放磁盘空间。
若使用 Windows 操作系统,实现方式同样适用:
largest_files(10, "C:/Users/xxx/")
至此,关于利用 Python 快速查找最大文件的介绍已完成。如需了解更多相关内容,建议查阅本站过往文章或继续浏览后续内容,感谢大家的支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















