


TensorFlow张量裁剪、排序及高阶操作详解

本文详细介绍TensorFlow中张量的核心高阶操作。涵盖按数值和范数进行张量裁剪以解决梯度爆炸问题,利用sort、argsort及topk进行数据排序与Top-K准确率计算。此外,解析tf.where条件筛选、tf.scatter_nd索引更新及tf.meshgrid网格生成等常用函数的具体用法与参数细节。
一、张量裁剪
1.tf.maximum/minimum/clip_by_value()
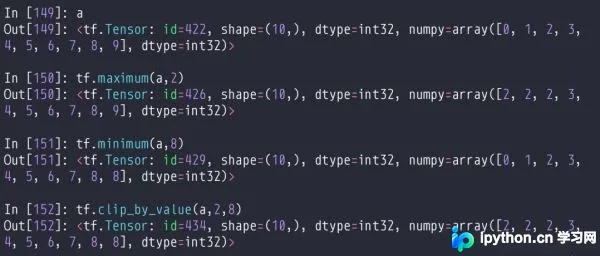
该函数基于数值进行裁剪,需传入张量及阈值参数。其中,tf.maximum会将张量中低于阈值的元素替换为阈值;tf.minimum则会将高于阈值的元素替换为阈值。若使用tf.clip_by_value,需同时指定上下两个阈值,从而将数据限制在指定区间内。
2.tf.clip_by_norm()
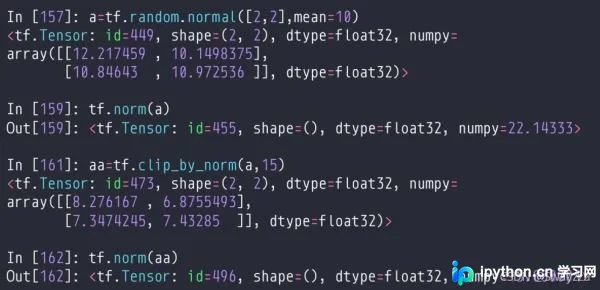
此方法依据范数进行裁剪,需传入张量及目标范数值。通过调整范数,可实现等比例缩放,在保持梯度方向不变的前提下减小数值大小。该操作常用于梯度裁剪,一次性对所有参数的范数进行处理并保留方向,从而有效防止梯度爆炸或梯度弥散现象。
二、张量排序
1.tf.sort/argsort()
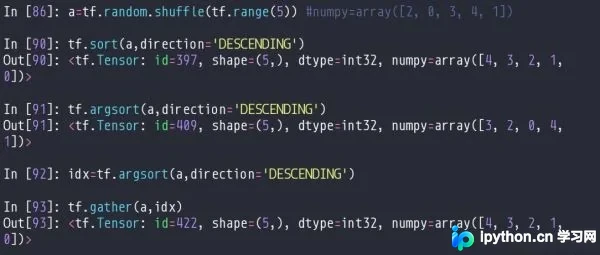
这两个函数分别用于返回排序后的数值及其对应的索引。获取索引后,可结合gather方法对数据进行重排。
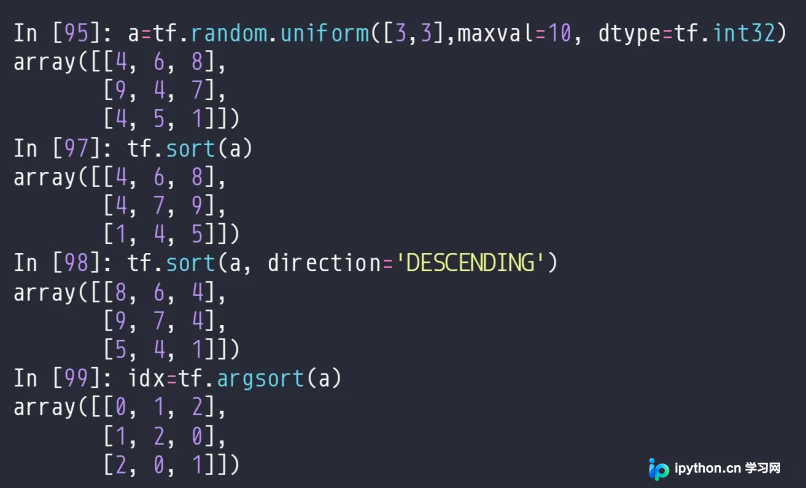
对于多维张量,若未指定操作轴,默认对最后一个轴执行操作。
2.tf.math.topk()
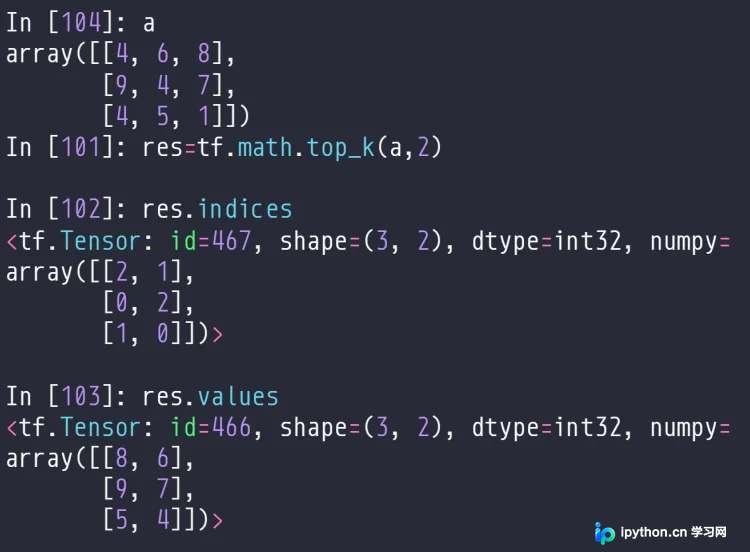
该函数返回前k个最大值及其对应索引。例如,传入参数a和2,表示提取每行中最大的两个数值及其索引,并将结果存入返回值中。
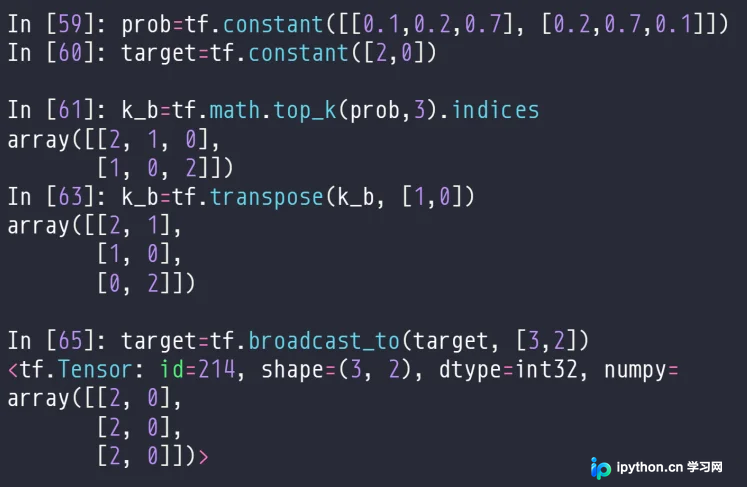
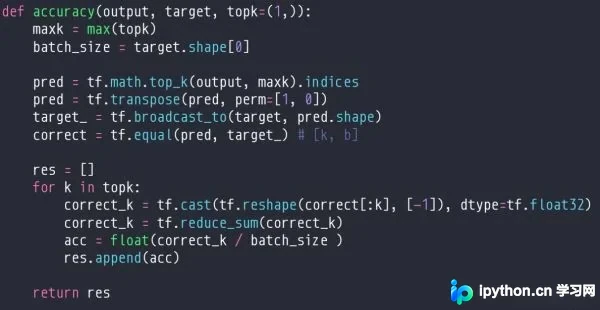
利用此规则可计算Top-K准确率。以两条数据为例,预测概率为prob,根据概率得到的最大索引分别为2和1,而实际标签target为2和0。
①调用tf.math.top_k方法对预测概率进行排序,获取前三大的值及其索引。
②对索引进行转置操作,便于阅读:第一列代表第一条数据的预测概率索引排序,第二列代表第二条数据的预测概率索引排序。
③计算Top-1准确率时,仅关注概率最大的索引(即第一行的两个数据2和1)。由于实际值为2和0,第一个数据预测正确,第二个错误,因此Top-1准确率为50%。
④Top-2准确率判定标准为:只要前两个预测索引中包含真实标签,即视为预测正确。第一行中,第一条数据预测正确(索引2在前三内),第二条错误;第二行中,第一条错误,但第二条预测正确(索引0在前三内)。
⑤基于“前两个索引中有一个匹配即算对”的规则,Top-2准确率为100%。
三、TensorFlow高阶操作
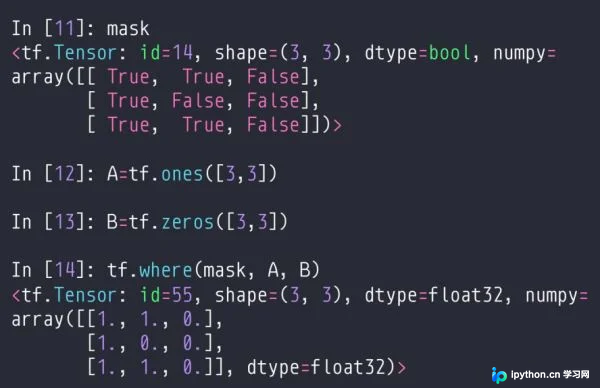
1.tf.where()
当传入布尔型数据时,该函数返回值为True的元素索引。
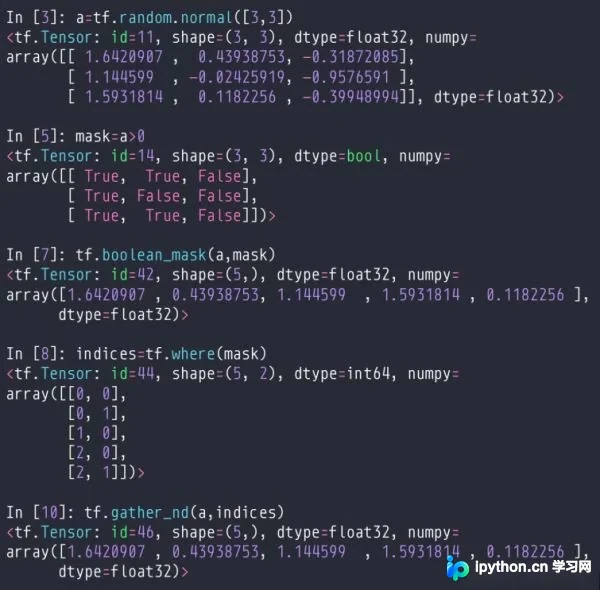
若传入条件表达式,如where(condition, A, B),其中condition为布尔张量,则函数会从A中选择condition为True位置对应的数据,从B中选择condition为False位置对应的数据。
2.tf.scatter_nd()
该函数需传入索引、数据及底板张量。
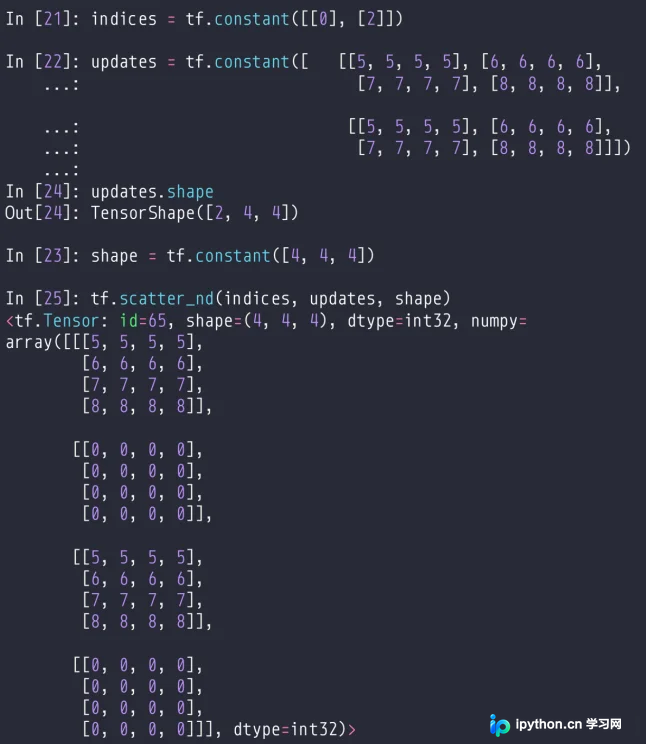
底板通常初始化为全0张量,索引与数据一一对应,且索引长度不超过底板维度。
每个传入的数据对应一个索引,并将数据更新到底板中索引指定的位置。
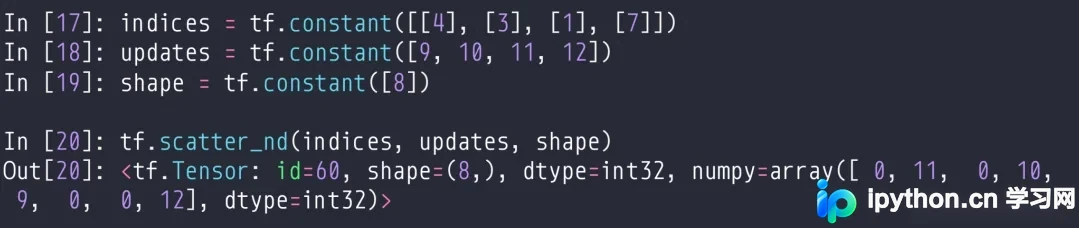
若底板已包含数据,需先将其清零再执行更新操作。
以下以二维情况为例进行说明。
3.tf.meshgrid()
其用法与NumPy中的meshgrid一致,分别生成网格中x轴和y轴的数据。示例如下。
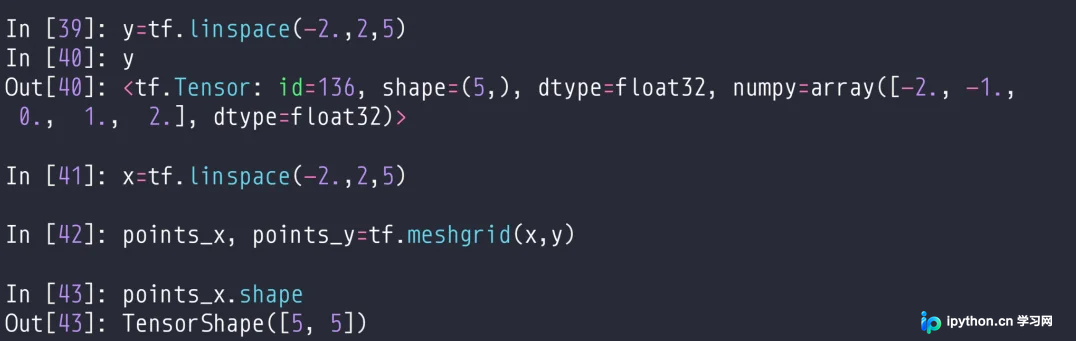
随后使用stack函数进行堆叠,即可得到所有25个点的坐标信息。
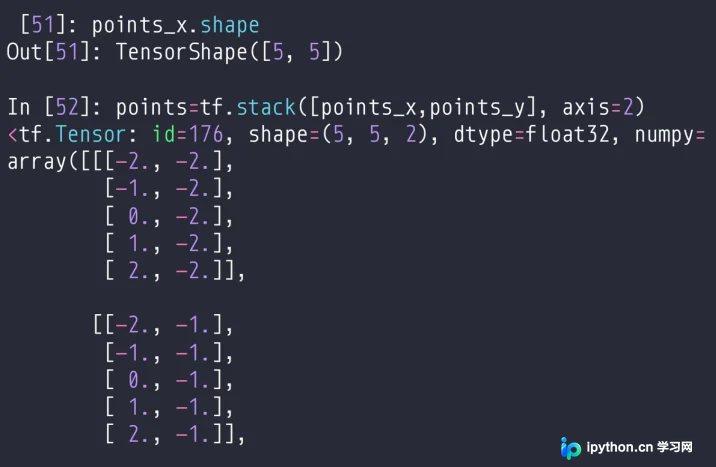
以上为TensorFlow中张量裁剪、排序及高阶操作的详细示例。如需了解更多TensorFlow张量高阶操作资料,请关注本站其他相关文章。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















