


深度学习常用优化算法详解:SGD、SGDM、Adam等对比分析

本文深入解析深度学习中的核心优化算法,包括基础SGD、引入动量的SGDM、结合二阶矩估计的Adam以及自适应步长的Adagrad和RMSProp。详细对比各算法在收敛速度、震荡抑制及泛化能力上的差异,帮助开发者根据模型特性选择最佳训练策略。
1.SGD
随机梯度下降(Stochastic Gradient Descent, SGD)
SGD与其他梯度下降变体的核心区别在于其更新机制:每次迭代仅选取单个数据样本来计算损失函数并求解梯度,进而更新模型参数。这种策略显著提升了单次计算的速度,但缺点是收敛过程较为缓慢,且容易在损失函数的最低点附近产生震荡,甚至陷入局部最优解而难以跳出。
2.SGDM
SGDM with Momentum:动量梯度下降
动量梯度下降在参数更新前,会对历史梯度信息进行指数加权平均处理,并使用该加权后的梯度替代原始梯度进行参数更新。这意味着每次更新都融合了过往的梯度信息,从而形成一种惯性效应。
具体计算中,动量梯度由两部分组成:加权平均后的梯度乘以系数beta,加上当前原始梯度乘以(1-beta),两者之和构成用于参数更新的最终动量梯度。
由于引入了历史梯度信息,该方法相当于为梯度下降增加了惯性。若此前更新方向一致,当前下降速度会加快;即便触及最低点,动量也能帮助算法越过局部极小值继续前行。当前更新方向由历史积累方向与当前梯度方向共同决定,从而有效减小训练过程中的震荡幅度并加速收敛。
尽管SGDM的收敛速度不及Adam,但其通常具备更好的模型泛化能力。
3.Adam
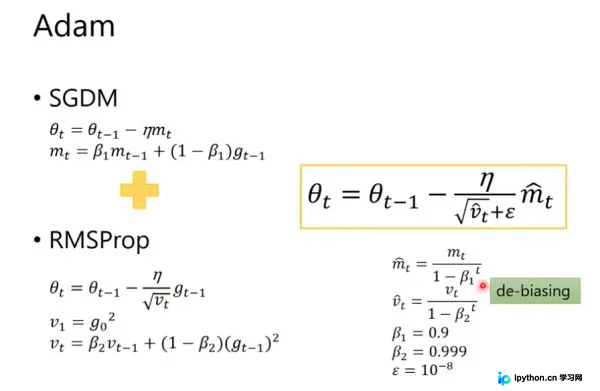
Adam(Adaptive Moment Estimation)是一种旨在替代传统随机梯度下降的深度学习优化算法。
它结合了SGDM(动量法)和RMSProp算法的优点,具有极快的训练速度,但在某些情况下泛化能力相对较弱。
4.Adagrad
Adaptive Gradient自适应步长
该方法通过为一个系数调整当前梯度的步长,该系数计算公式为:1除以(历史梯度平方和的平方根)。
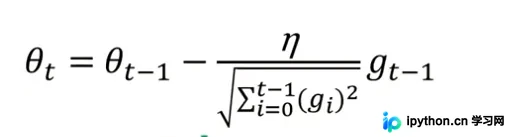
在数据分布稀疏的场景下,Adagrad能更有效地利用稀疏梯度信息,相比标准SGD实现更高效的收敛。
5.RMSProp
梯度平方根root mean square prop
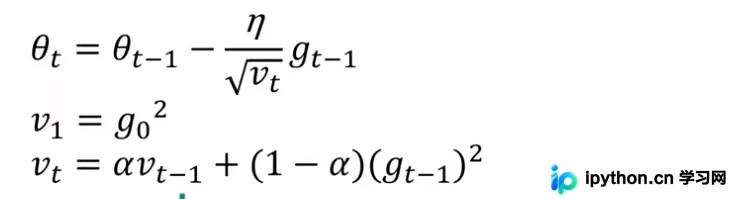
RMSProp与Adagrad的主要区别在于分母的计算方式。RMSProp采用指数加权平均来更新分母,避免因为早期梯度较大导致分母过大,进而使学习系数过小从而停滞不前。其计算逻辑类似于动量法中的指数加权平均。
6.NAG
Nesterov Accelerated Gradient(Nesterov加速梯度)是对SGD和SGDM的改进。在标准SGDM中,梯度方向由当前梯度与累积历史梯度共同决定;而在NAG中,算法先利用累积动量预估下一步位置,计算该位置的梯度,再将该梯度与历史累积动量结合,以计算当前时刻的累计动量。这种“先看向后看”的机制能更准确地调整梯度方向。
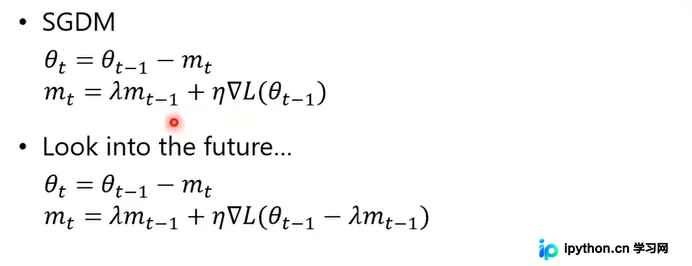
以上就是python人工智能深度学习算法优化的详细内容,更多关于python人工智能算法优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















