


Python数据分析实战:利用Pandas与Matplotlib解析学校四六级成绩

本文基于Python的Pandas和Matplotlib库,对某学校近9000条四六级考试成绩进行清洗与分析。通过数据预处理、分组统计及可视化绘图,展示了各学院平均分、过关人数分布及男女生通过率差异,为教育数据分析提供完整代码示例与结果解读。
近期深入学习了数据分析相关领域,初步掌握了Python中numpy和pandas的基础用法。为了避免技能生疏,我决定通过实际操作来巩固所学。恰好之前社群分享了一份学校四六级成绩表,这便成为了我熟悉pandas各项功能的绝佳素材。
1. 数据概况说明。
原始成绩表字段详尽,涵盖年级、性别、姓名、分数等大量信息。鉴于本次分析仅聚焦于学校整体的四六级通过率,因此剔除无关字段,保留核心数据如下:
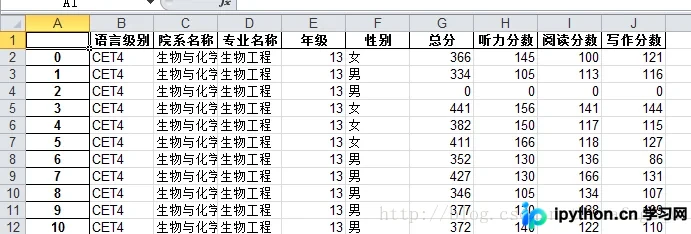
第一列为自增序号,无实际分析价值。
第二列标识学生参加的是四级(CET-4)还是六级(CET-6)考试。
第三列记录学生所属的院系名称。
第四列显示学生所在的具体专业。
第五列为年级字段,其中“13”代表2013年入学。
第六列为性别信息。
后续三列分别对应总分、听力分数及阅读分数(注:原文提及写作,但代码仅处理总分,此处依原文描述保留)。
总分为0的记录视为缺考。数据集中包含近9000条有效记录(未报名者未计入)。
2. 预期分析目标。
计划通过图表直观展示以下关键指标:
1. 各学院四六级考试的平均分数。
2. 各学院四六级考试的通过人数。
3. 各学院各年级的通过人数分布。
4. 各年级整体的通过人数。
5. 男生与女生各自的通过人数对比。
最终输出结果如下:
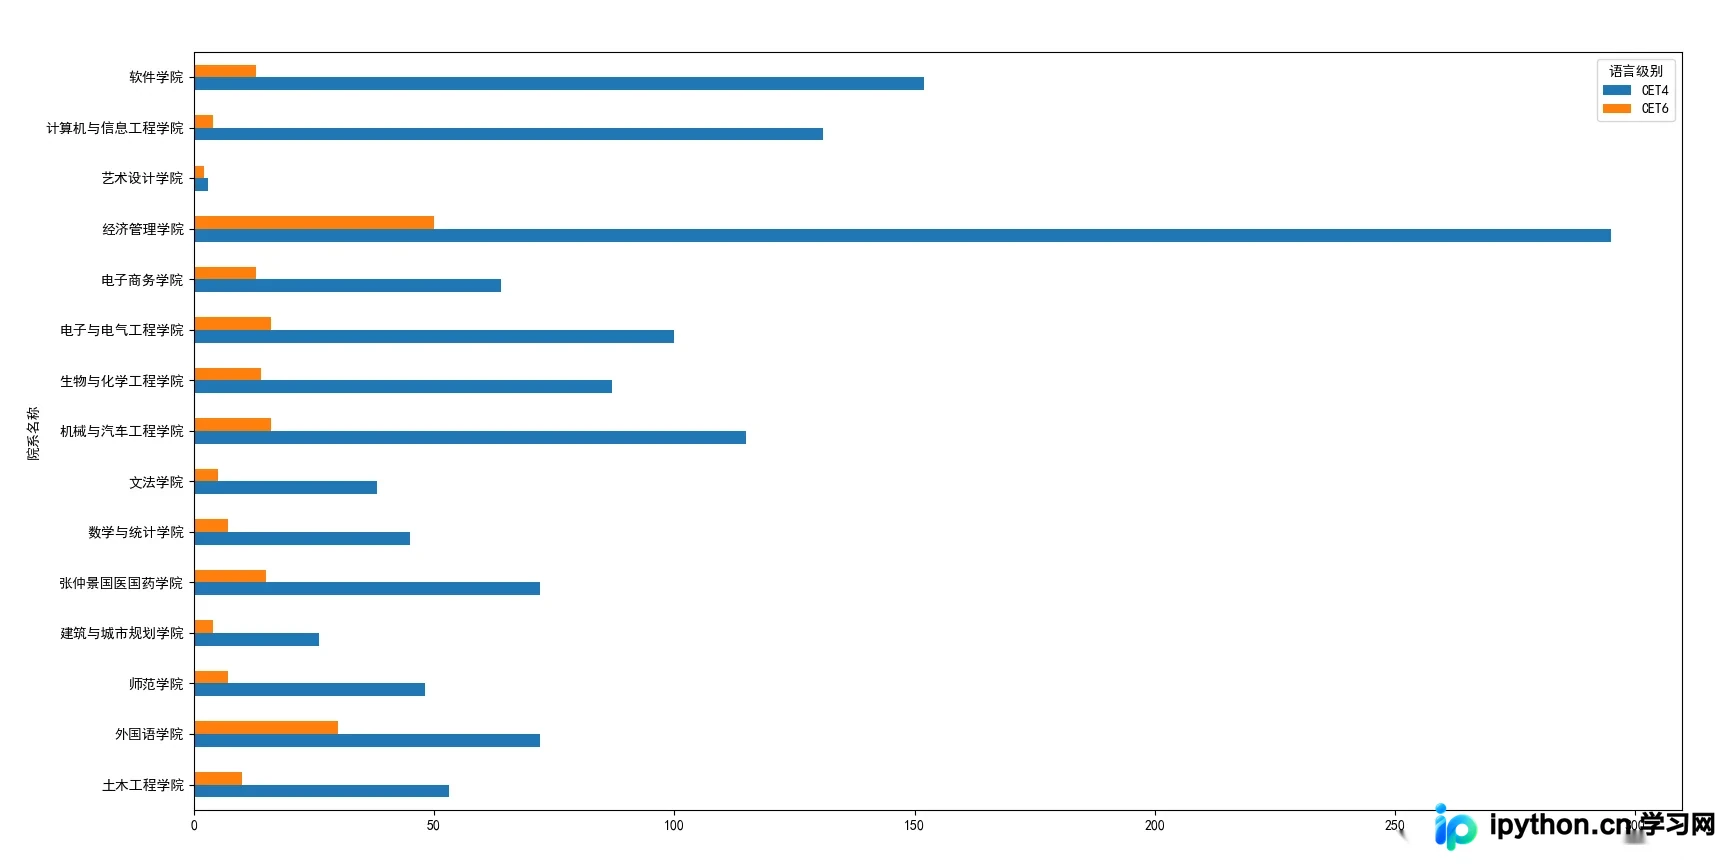
各学院四六级通过人数统计:
3. 具体实现步骤。
(1)导入必要依赖库。
程序主要使用pandas进行数据分组与转换,并调用matplotlib实现绘图功能。
import pandas as pd
import matplotlib.pylab as plt
(2)加载数据文件。
分析数据需先获取源数据,我将整理后的数据保存为sj.xls(Excel格式)。 此步骤通过pandas的read_excel函数读取,生成DataFrame对象。
#加载全部数据
sj = pd.read_excel(r'F:\DataAnalysis\sj.xls')
加载完成后,输出查看数据内容:
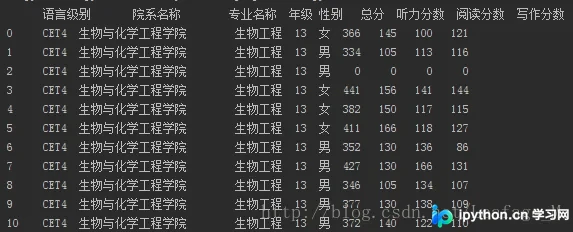
除排版未对齐外,数据结构与预期一致。
(3)统计各学院平均分。
此处实现第一个预期目标:
各学院四六级平均分统计:
需按“院系名称”分组,并区分“CET4”和“CET6”两组。使用groupby生成SeriesGroupBy对象,再调用mean函数(默认沿轴0计算,即符合需求)即可得出平均分。
#按照各个学院进行分组
xymean = sj['总分'].groupby([sj['院系名称'],sj['语言级别']])

#计算各个学院的平均分数
xymean = xymean.mean()
直接输出结果如下:
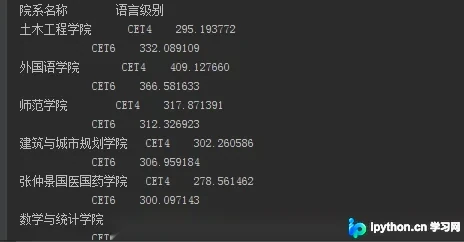
由于院系名称和语言级别构成层次化索引,显示效果不够直观,因此使用unstack将语言级别从行索引转换为列索引。
xymean = xymean.unstack(level='语言级别')
再次输出,结果结构更为清晰:
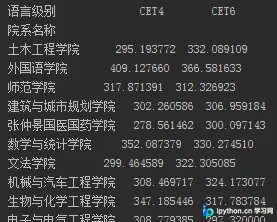
利用pandas内置绘图功能生成图表:
#使用横向柱状图显示
xymean.plot(kind='barh')

#在PyCharm中需要使用,在Ipython环境中如果以--pylab形式打开就不需要
plt.show()
运行代码查看效果:
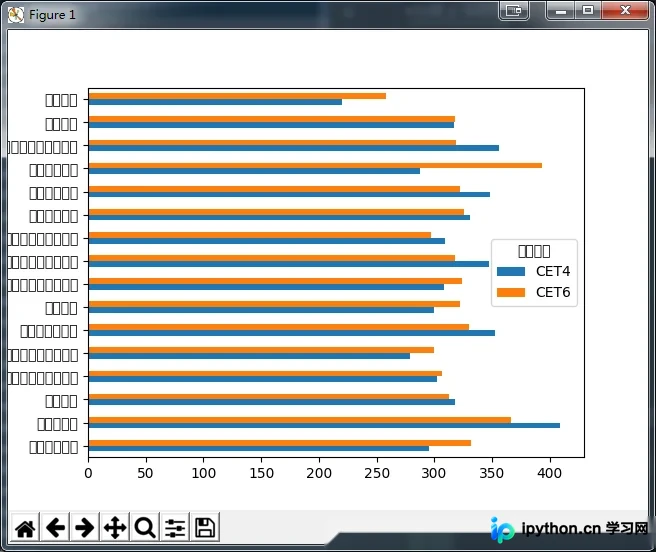
数据显示正常,但中文显示出现乱码问题。经查阅相关社区讨论(如seaborn issue #1009)可解决:
添加以下配置代码即可:
import matplotlib as mpl
mpl.rcParams['font.sans-serif'] = ['SimHei']
mpl.rcParams['font.serif'] = ['SimHei']
再次运行,中文显示恢复正常。
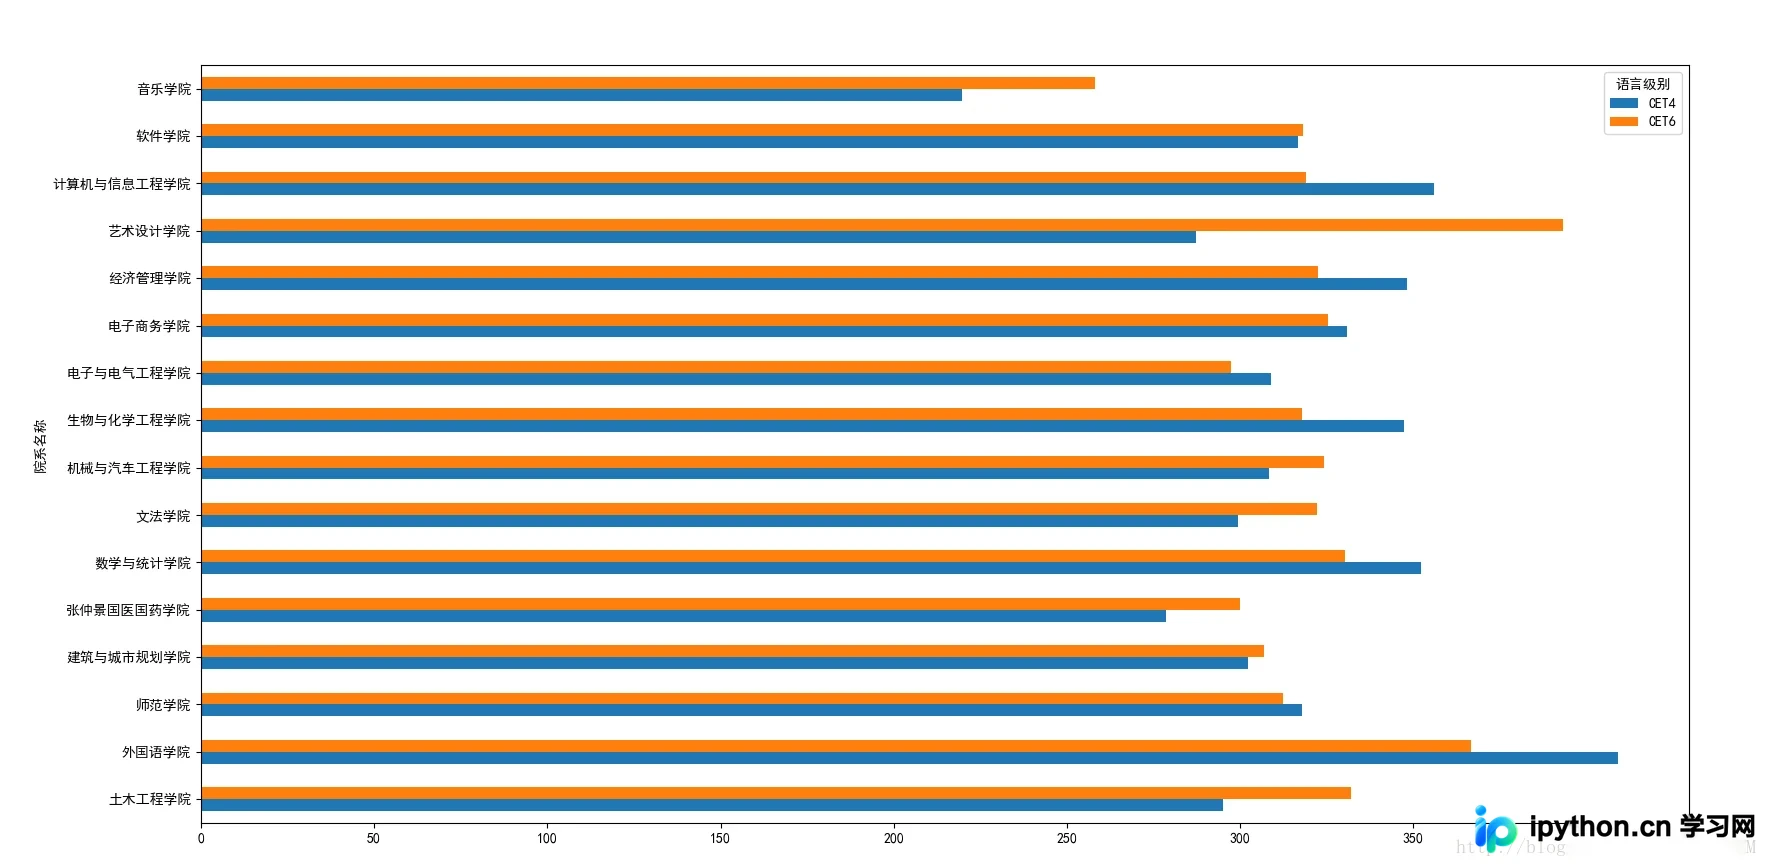
接下来进行通过情况的深入分析。
(4)数据筛选。
在拥有全量数据后,下一步是筛选出所有通过考试的学生记录。
#过滤出过关人数
sjpass = sj[sj['总分'] >= 425]
此时sjpass变量存储了所有通过考试的数据。
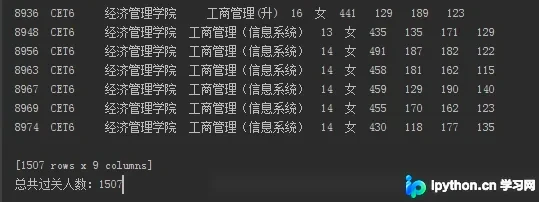
在输出结果末尾可见共有1507行通过记录,也可通过len()或shape[0]方法验证行数。
(5)各学院四六级通过人数统计。
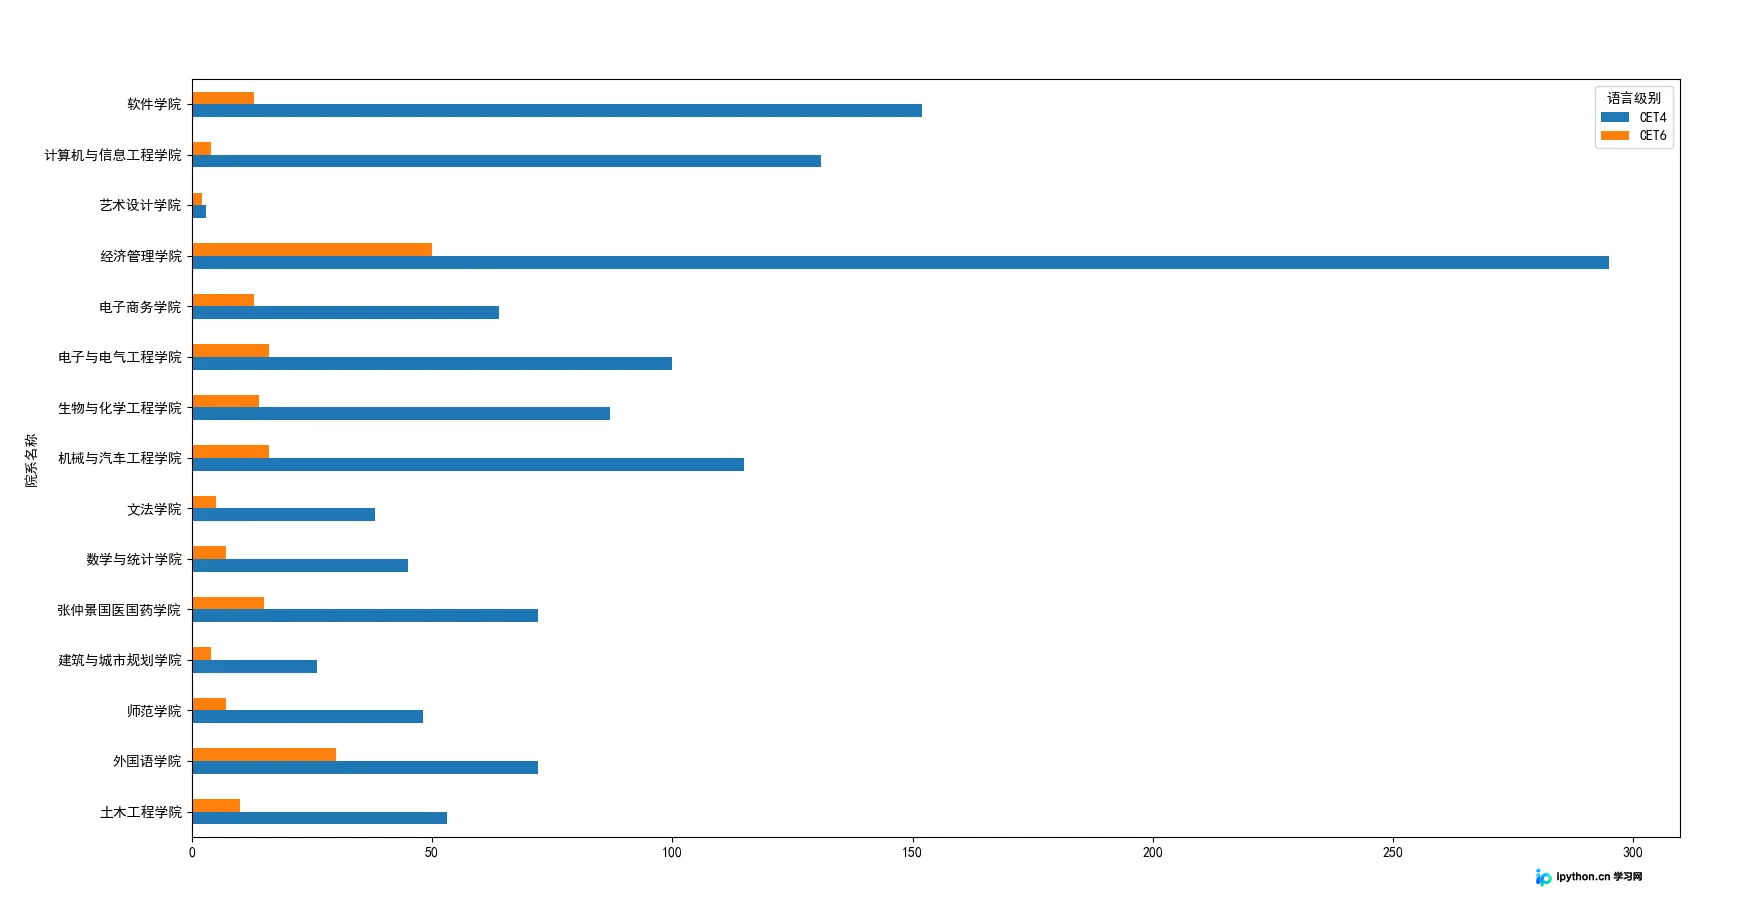
基于通过数据,按预期目标分组。同样依据“院系名称”和“语言级别”对总分进行分组,使用count函数统计人数,最后通过unstack调整结构并绘图展示。
#按照各个学院进行分组
xypass = sjpass['总分'].groupby([sjpass['院系名称'],sjpass['语言级别']])


#计算各个学院的过关总人数
xypass = xypass.count()

#将语言级别作为columns
xypass = xypass.unstack(level='语言级别')

#进行绘图
xypass.plot(kind='barh')
plt.show()
绘图结果如下:
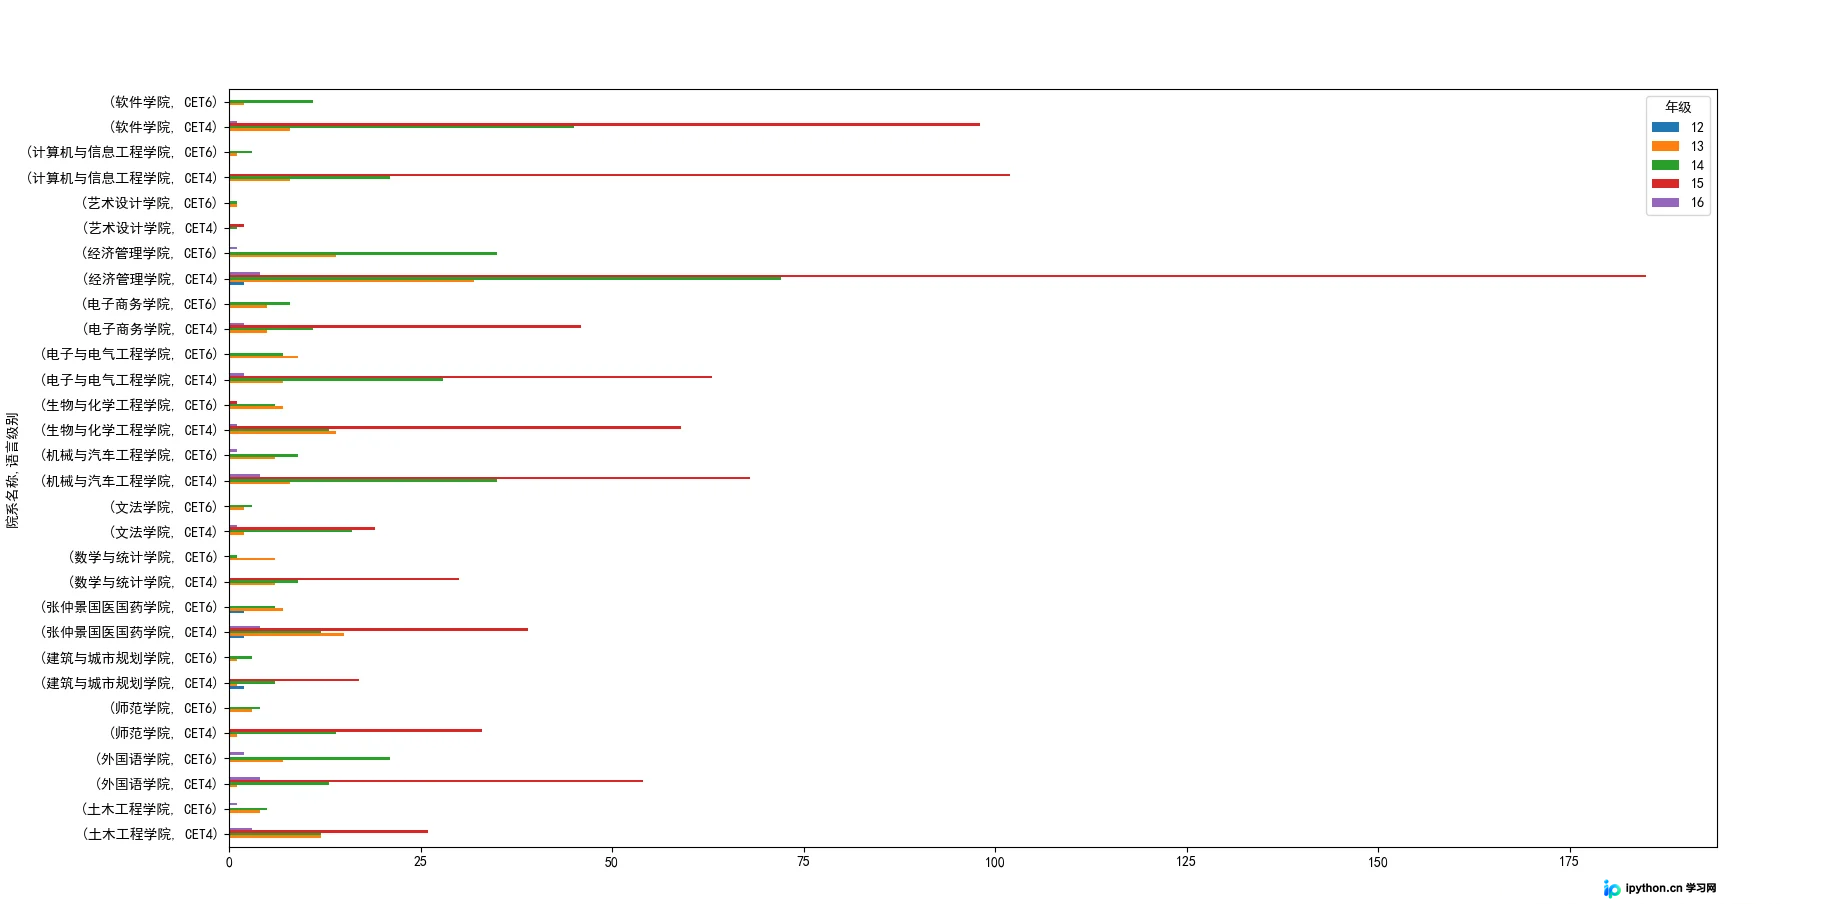
(6)各学院各年级通过人数统计。
此次分组增加“年级”维度。为优化图表美观度,将“年级”转换为列,并对如12年级等无人参考的缺失值用0填充:
#按照各个学院和年级进行分组
xypass = sjpass['总分'].groupby([sjpass['院系名称'],sjpass['语言级别'],sjpass['年级']])

#计算各个学院的过关总人数
xypass = xypass.count()

#将语言级别作为columns,并且将缺失值用0进行填充
xypass = xypass.unstack(level='年级').fillna(0)

xypass.plot(kind='barh')
plt.show()
绘图结果如下:
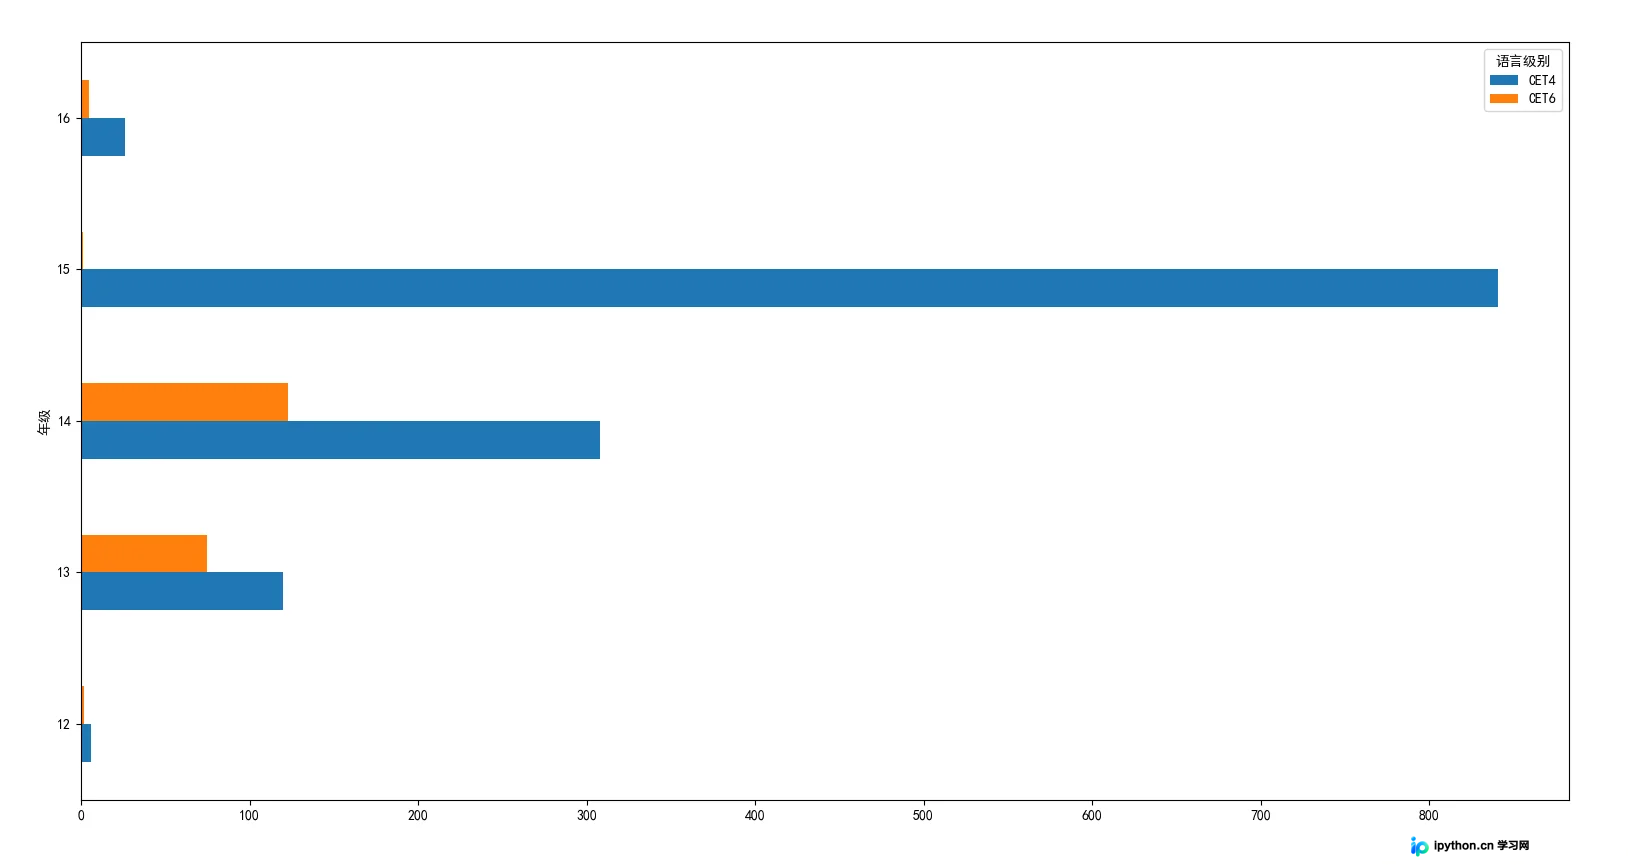
(7)各年级通过人数统计。
直接对年级进行groupby分组:
#-----------------各个年级过关人数------------------
njpass = sjpass['总分'].groupby([sjpass['年级'],sjpass['语言级别']]).count().unstack(level='语言级别')
njpass.plot(kind='barh')
plt.show()
绘图结果如下:
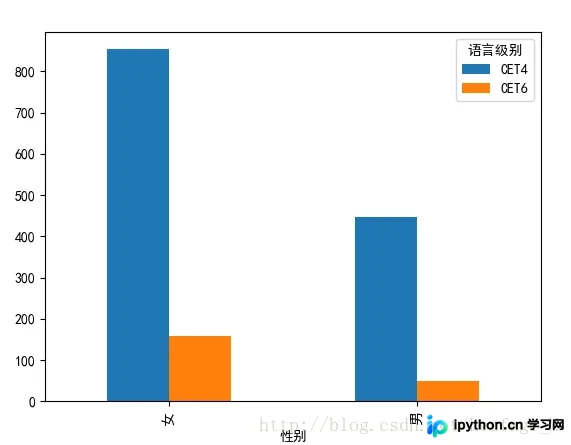
(8)男女生通过人数对比。
对性别和语言级别进行分组统计:
#---------------男生女生过关情况----------------------
nvpass = sjpass['总分'].groupby([sjpass['性别'],sjpass['语言级别']]).count().unstack(level='语言级别')
nvpass.plot(kind='bar')
plt.show()
绘图结果如下:
4. 结果分析与讨论。
从图表结果来看,各学院间存在差异:音乐学院平均分较低,而艺术设计和外国语学院的平均分较高,但其通过人数相对较少,尤其是艺术设计学院,主要受限于该院总人数较少。
四级通过人数显著多于六级。由于我校规定大二方可参加四六级考试,15级学生(大二)在通过人数中占比较大。
此外,数据显示女生的通过率明显高于男生。
完整源码及数据链接:https://github.com/jiajia0/DataAnalysis
本文内容到此结束,希望能为各位的学习提供参考,欢迎继续支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















