


Python 3.6 后字典为何有序?深入解析底层数据结构演变

本文解析Python 3.6后字典保持插入顺序的底层原理。通过对比旧版哈希表与新版的indices与entries分离结构,说明如何通过紧凑存储提升内存利用率并保留插入顺序。文章涵盖数据结构变化、空间节省计算及源码学习资源,帮助开发者深入理解Python字典实现。
字典有序的定义与本质
字典的本质是 hash 表,其核心机制是通过 hash 表利用 key 定位对应的 value 。在平均情况下,查找单个元素仅需 O(1) 的时间复杂度。需要明确的是,字典的“有序”并非指按键或值进行排序,而是指输出键值对时,能否严格遵循插入时的先后顺序。
以无序字典为例,其插入顺序与遍历输出顺序并不一致:
>>> my_dict = dict()
>>> my_dict["name"] = "lowman"
>>> my_dict["age"] = 26
>>> my_dict["girl"] = "Tailand"
>>> my_dict["money"] = 80
>>> my_dict["hourse"] = None
>>> for key,value in my_dict.items():
...     print(key,value)
...
money 80
girl Tailand
age 26
hourse None
name lowman
而在有序字典中,输出结果则表现为:
name lowman
age 26
girl Tailand
money 80
hourse None
Python 3.6 前的无序实现
那么,Python 3.6 之后的版本为何实现了字典有序?
首先回顾 Python 3.6 之前的数据结构,其内部结构如下图所示:
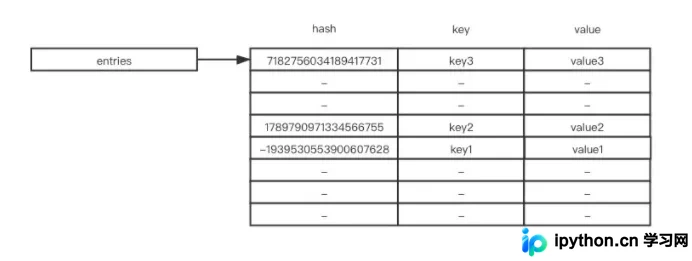
由于不同键的哈希值存在差异,entries表中的顺序实际上是由哈希值大小决定的。遍历时从前往后读取无法还原键值的插入顺序,因此表现为无序状态。
Python 3.6 的内存优化结构
此外,这种结构在存储稀疏哈希表时会浪费大量内存空间。自 Python3.6 起,Python 对此进行了优化,将哈希索引与实际的键值对分开存放,新的数据结构如下所示:
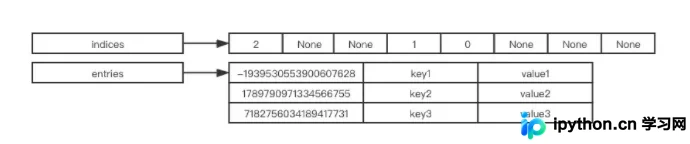
其中,indices 指向一组索引数组,而 entries 则指向原本存储哈希表内容的结构。
可以将 indices 视为简化版的哈希表,而 entries 是一个数组,该数组中的每个元素对应原本应存储的哈希结果,即键和值。
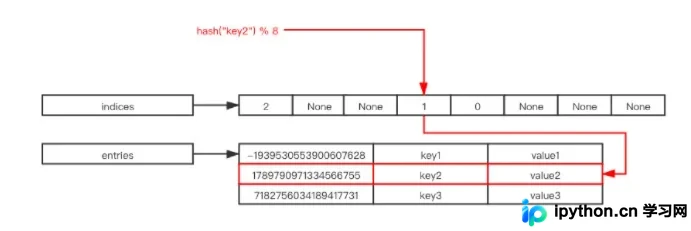
在查找或插入元素时,根据键的哈希值对 indices 数组的长度取模,即可得到对应的数组下标。随后,通过该下标在 entries 中获取具体结果。例如,hash("key2") % 8 的结果为 3,此时 indices[3] 的值为 1,接着在 entries 中找到 entries[1] 即为所求结果:
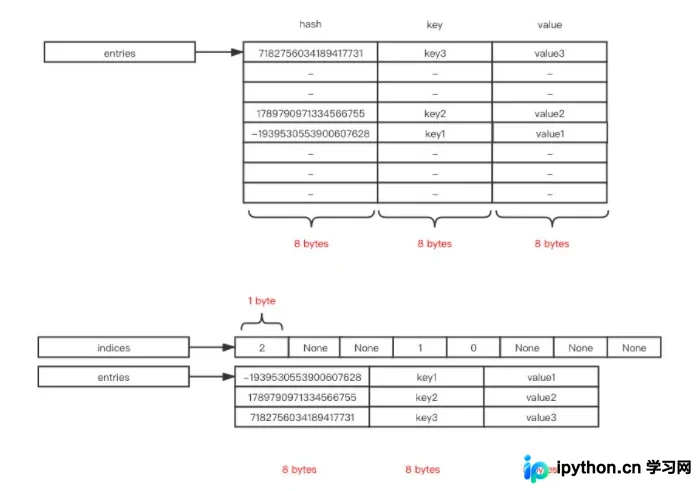
这种设计的优势在于显著提升了空间利用率。以 64 位操作系统为例,每个指针长度为 8 字节,原本需要的空间为 8 * 3 * 8,即 192 字节。
优化后,空间变为 8 * 3 * 3 + 1 * 8,即 80 字节,节省了约 58% 的内存空间,具体对比如下图所示:
此外,由于 entries 是按照插入顺序构建的数组,对字典进行遍历时即可按照插入顺序输出。这也是 Python 3.6 及以后版本中字典对象呈现有序特性的根本原因。
最后:
源码学习推荐
如果你对 Python 解释器的内部实现感兴趣,建议阅读 CPython 的源码。源码之下无秘密,阅读源码是提升技术能力最快的方式。这里推荐一个学习 CPython 的开源仓库 CPython-Internals,该仓库图文注释详尽,是非常有价值的学习资源。
到此这篇关于Python3.6 之后字典是有序的?的文章就介绍到这了,更多相关Python字典有序性内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















