


详解pandas中缺失数据处理的函数

本文深入解析pandas中缺失值的三种表示形式(np.nan、None、pd.NA)及其对数据类型的影响。详细讲解isnull/isna判断、缺失率统计、基于loc的筛选方法,以及fillna填充(含ffill/bfill)、dropna删除和缺失值参与计算的逻辑,提供完整代码示例与参数说明。
本文分享一份关于pandas中缺失值处理的完整操作指南。
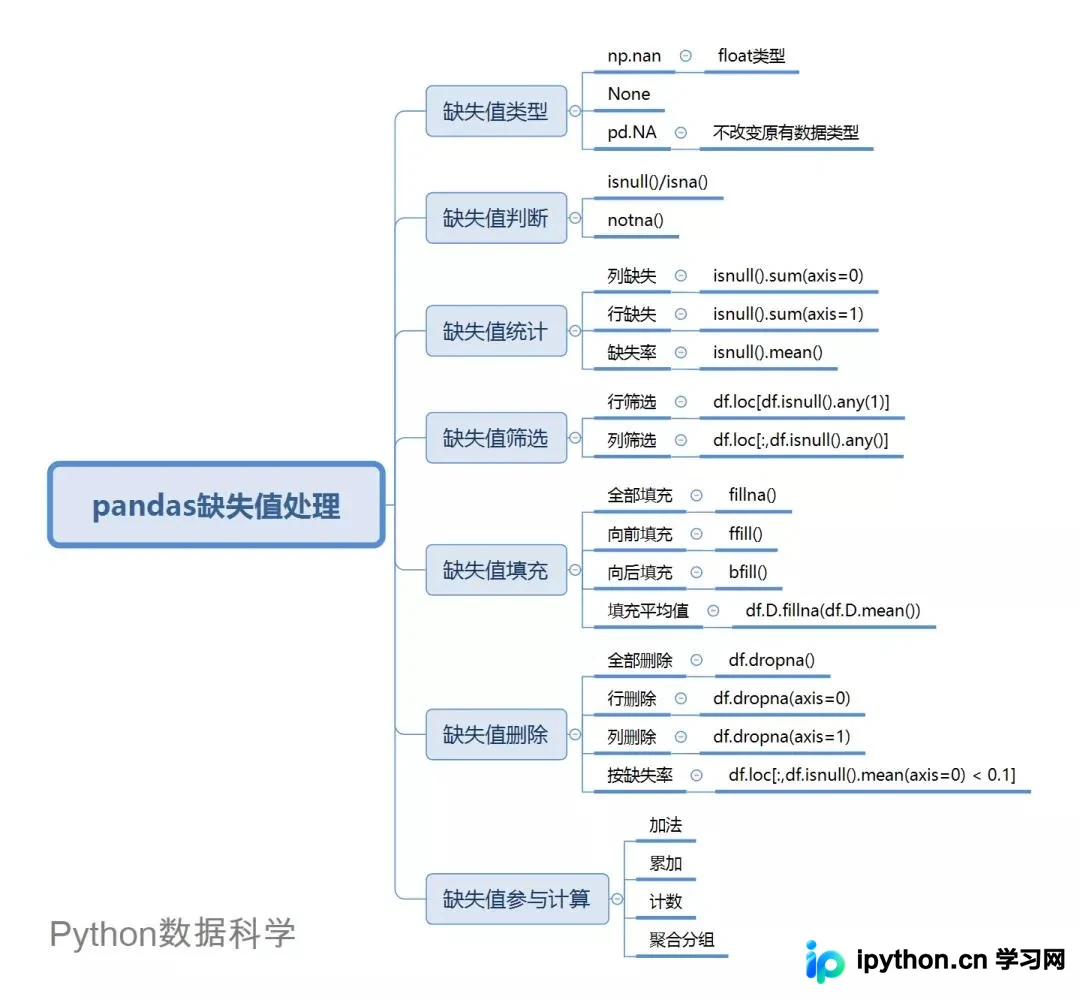
一、缺失值类型
在pandas库中,缺失数据通常显示为NaN。缺失值主要有三种表示方式:np.nan、none以及pd.NA。
1、np.nan
缺失值有一个显著特点(也是常见陷阱):它不等于任何值,甚至不等于自身。如果使用nan与任何其他值进行比较,结果都会返回nan。
np.nan == np.nan
>> False
正因为这一特性,在数据集读入后,无论原始列的数据类型是什么,默认的缺失值都会显示为np.nan。
由于nan在Numpy库中的类型是浮点型,因此包含缺失值的整型列会自动转换为浮点型;而字符型数据因为无法转换为浮点型,只能被归并为object类型(即'0'),原本就是浮点型的列则保持类型不变。
type(np.nan)
>> float
pd.Series([1,2,3]).dtype
>> dtype('int64')
pd.Series([1,np.nan,3]).dtype
>> dtype('float64')
初学者在进行数据处理时,如果遇到object类型往往会感到困惑,不明白这是什么类型。明明导入的是字符型数据,为什么类型变了?其实这正是由缺失值导致的。
此外,还需要介绍一种针对时间序列的缺失值,它是单独存在的,使用NaT表示。这是pandas库的内置类型,可以视为时间序列版的np.nan,同样具有与自身不相等的特性。
s_time = pd.Series([pd.Timestamp('20220101')]*3)
s_time
>> 0 2022-01-01
   1 2022-01-01
   2 2022-01-01
   dtype:datetime64[ns]
-----------------
s_time[2] = pd.NaT
s_time
>> 0 2022-01-01
   1 2022-01-01
   2 NaT
   dtype:datetime64[ns]
2、None
另一种表示方式是None,它比nan稍微好一些,因为它至少可以与自身相等。
None == None
>> True
当传入数值类型时,None会自动变为np.nan。
type(pd.Series([1,None])[1])
>> numpy.float64
只有当传入object类型时,None才会保持不变。因此可以认为,如果不是人工显式命名为None,它基本上不会自动出现在pandas中,所以None大家在实际使用中基本也很少见到。
type(pd.Series([1,None],dtype='O')[1])
>> NoneType
3、NA标量
在pandas 1.0之后的版本中,引入了一个专门表示缺失值的标量pd.NA。它代表空整数、空布尔值和空字符,该功能目前处于实验阶段。
开发者也意识到了这一点:针对不同数据类型采用不同的缺失值表示方式会显得混乱。pd.NA的存在就是为了统一这一标准。pd.NA的目标是提供一个缺失值指示器,可以在各种数据类型中一致使用,而不是分别使用np.nan、None或NaT。
s_new = pd.Series([1, 2], dtype="Int64")
s_new
>> 0   1
   1   2
   dtype: Int64
-----------------
s_new[1] = pd.NaT
s_new
>> 0    1
   1  <NA>
   dtype: Int64
同理,对于布尔型和字符型数据,使用pd.NA不会改变原有数据类型,这样就解决了原来数据动不动就变成object类型的麻烦。
以下是pd.NA的一些常用算术运算和比较运算示例:
##### 算术运算
# 加法
pd.NA + 1
>> <NA>
-----------
# 乘法
"a" * pd.NA
>> <NA>
-----------
# 以下两种其中结果为1
pd.NA ** 0
>> 1
-----------
1 ** pd.NA
>> 1

##### 比较运算
pd.NA == pd.NA
>> <NA>
-----------
pd.NA < 2.5
>> <NA>
-----------
np.log(pd.NA)
>> <NA>
-----------
np.add(pd.NA, 1)
>> <NA>
二、缺失值判断
了解了缺失值的几种形式后,我们需要知道如何判断缺失值。对于一个dataframe而言,判断缺失的主要方法就是isnull()或者isna(),这两个方法会直接返回True和False的布尔值。这可以应用于整个dataframe或者某个特定的列。
df = pd.DataFrame({
      'A':['a1','a1','a2','a3'],
      'B':['b1',None,'b2','b3'],
      'C':[1,2,3,4],
      'D':[5,None,9,10]})
# 将无穷设置为缺失值
pd.options.mode.use_inf_as_na = True
1、对整个dataframe判断缺失
df.isnull()
>> A B C D
0 False False False False
1 False True False True
2 False False False False
3 False False False False
2、对某个列判断缺失
df['C'].isnull()
>> 0    False
   1    False
   2    False
   3    False
Name: C, dtype: bool
如果想获取非缺失值,可以使用notna(),使用方法与上述相同,但结果相反。
三、缺失值统计
1、列缺失
通常我们会对一个dataframe的列进行缺失统计,查看每个列有多少缺失值。如果缺失率过高,再进行删除或者插值等操作。那么直接在上面的isnull()返回的结果上应用.sum()即可,axis默认等于0,0代表列,1代表行。
## 列缺失统计
isnull().sum(axis=0)
2、行缺失
但在很多情况下,我们也需要对行进行缺失值判断。例如,如果一行数据中所有值都缺失,将该样本送入模型会造成很大干扰。因此,行列两个维度的缺失率通常都要查看并统计。
操作很简单,只需要在sum()中设置axis=1即可。
## 行缺失统计
isnull().sum(axis=1)
3、缺失率
有时我们不仅想知道缺失的数量,更想知道缺失的比例,即缺失率。正常思维可能会想到用上面求得的数值再除以总行数。但其实这里有个小技巧可以一步实现。
## 缺失率
df.isnull().sum(axis=0)/df.shape[0]

## 缺失率(一步到位)
isnull().mean()
四、缺失值筛选
筛选需要配合loc使用,对于行和列的缺失筛选如下:
# 筛选有缺失值的行
df.loc[df.isnull().any(1)]
>> A B C D
1 a1 None 2 NaN
-----------------
# 筛选有缺失值的列
df.loc[:,df.isnull().any()]
>> B D
0 b1 5.0
1 None NaN
2 b2 9.0
3 b3 10.0
如果要查询没有缺失值的行和列,可以对表达式使用取反~操作:
df.loc[~(df.isnull().any(1))]
>> A B C D
0 a1 b1 1 5.0
2 a2 b2 3 9.0
3 a3 b3 4 10.0
上面使用了any判断只要有缺失就进行筛选,也可以使用all判断是否全部缺失。同样可以对行里进行判断,如果整列或者整行都是缺失值,那么这个变量或者样本就失去了分析意义,可以考虑删除。
五、缺失值填充
一般我们对缺失值有两种处理方法:一种是直接删除,另一种是保留并填充。下面先介绍填充的方法fillna。
# 将dataframe所有缺失值填充为0
df.fillna(0)
>> A B C D
0 a1 b1 1 5.0
1 a1 0 2 0.0
2 a2 b2 3 9.0
3 a3 b3 4 10.0
--------------
# 将D列缺失值填充为-999
df.D.fillna('-999')
>> 0       5
   1    -999
   2       9
   3      10
Name: D, dtype: object
方法很简单,但使用时需要注意一些参数。
inplace:可以设置
fillna(0, inplace=True)来让填充生效,原dataFrame被填充。methond:可以设置
methond方法来实现向前或者向后填充,pad/ffill为向前填充,bfill/backfill为向后填充,比如df.fillna(methond='ffill'),也可以简写为df.ffill()。
df.ffill()
>> A B C D
0 a1 b1 1 5.0
1 a1 b1 2 5.0
2 a2 b2 3 9.0
3 a3 b3 4 10.0
原缺失值都会按照前一个值来填充(例如B列1行,D列1行)。
除了用前后值来填充,也可以用整个列的均值来填充,比如对D列的其他非缺失值的平均值8来填充缺失值。
df.D.fillna(df.D.mean())
>> 0     5.0
   1     8.0
   2     9.0
   3    10.0
Name: D, dtype: float64
六、缺失值删除
删除缺失值的情况多样,比如是全删除还是删除较高缺失率的列,这要看自己的容忍程度。真实的数据必然存在缺失,这是无法避免的。而且缺失在某些情况下也代表了一定的含义,要视情况而定。
1、全部直接删除
# 全部直接删除
df.dropna()
>> A B C D
0 a1 b1 1 5.0
2 a2 b2 3 9.0
3 a3 b3 4 10.0
2、行缺失删除
# 行缺失删除
df.dropna(axis=0)
>> A B C D
0 a1 b1 1 5.0
2 a2 b2 3 9.0
3 a3 b3 4 10.0
3、列缺失删除
# 列缺失删除
df.dropna(axis=1)
>> A C
0 a1 1
1 a1 2
2 a2 3
3 a3 4
-------------
# 删除指定列范围内的缺失,因为C列无缺失,所以最后没有变化
df.dropna(subset=['C'])
>> A B C D
0 a1 b1 1 5.0
1 a1 None 2 NaN
2 a2 b2 3 9.0
3 a3 b3 4 10.0
4、按缺失率删除
这个可以考虑用筛选的方法来实现,比如要删除列缺失大于0.1的(即筛选小于0.1的)。
df.loc[:,df.isnull().mean(axis=0) < 0.1]
>> A C
0 a1 1
1 a1 2
2 a2 3
3 a3 4
-------------
# 删除行缺失大于0.1的
df.loc[df.isnull().mean(axis=1) < 0.1]
>> A B C D
0 a1 b1 1 5.0
2 a2 b2 3 9.0
3 a3 b3 4 10.0
七、缺失值参与计算
如果不对缺失值处理,那么缺失值会按照什么逻辑进行计算呢?
下面我们一起看一下各种运算下缺失值的参与逻辑。
1、加法
df
>>A B C D
0 a1 b1 1 5.0
1 a1 None 2 NaN
2 a2 b2 3 9.0
3 a3 b3 4 10.0
---------------
# 对所有列求和
df.sum()
>> A    a1a1a2a3
   C          10
   D          24
可以看到,加法是会忽略缺失值的。
2、累加
# 对D列进行累加
df.D.cumsum()
>> 0     5.0
   1     NaN
   2    14.0
   3    24.0
Name: D, dtype: float64
---------------
df.D.cumsum(skipna=False)
>> 0    5.0
   1    NaN
   2    NaN
   3    NaN
Name: D, dtype: float64
cumsum累加会忽略NA,但值会保留在列中,可以使用skipna=False跳过有缺失值的计算并返回缺失值。
3、计数
# 对列计数
df.count()
>> A    4
   B    3
   C    4
   D    3
dtype: int64
缺失值不进入计数范围里。
4、聚合分组
df.groupby('B').sum()
>> C D
B
b1 1 5.0
b2 3 9.0
b3 4 10.0
---------------
df.groupby('B',dropna=False).sum()
>> C D
B
b1 1 5.0
b2 3 9.0
b3 4 10.0
NaN 2 0.0
聚合时会默认忽略缺失值,如果要缺失值计入到分组里,可以设置dropna=False。这个用法和其他比如value_counts是一样的,有的时候需要看缺失值的数量。
五、源码
所有数据和代码可在我的GitHub获取:
https://github.com/xiaoyusmd/PythonDataScience
到此这篇关于详解pandas中缺失数据处理的函数的文章就介绍到这了,更多相关pandas缺失数据处理内容请搜索本站以前的文章或继续浏览下面的相关文章,希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















