


Python数据结构与算法之跳表详解

本文深入解析Python中跳表(Skip List)的数据结构与算法实现。跳表通过构建多级索引链表,将查找、插入和删除操作的时间复杂度从O(n)优化至O(log n)。文章详细阐述了跳表的基本概念、与普通链表的差异,并提供了从节点类定义、初始化到查找、插入、删除及打印等完整功能的Python代码实现与测试示例,帮助开发者掌握这一高效有序链表结构。
0. 学习目标
在单链表或双链表等常规链表中,查找、插入和删除操作均需从头结点开始遍历,导致时间复杂度为O(n)。跳表是一种带有附加指针的链表结构,利用这些额外指针跳过部分中间节点,从而显著提升查找、插入和删除操作的效率。本节将详细介绍跳表的相关概念及其具体实现方法。
通过本节学习,应掌握以下内容:
- 跳表的基本概念及其与普通链表的区别
- 跳表及其操作的实现
1. 跳表的基本概念
跳表 (Skip List) 是一种支持快速查找、插入和删除操作的有序链表(即数据项按特定顺序排列的链表)。其核心思想是通过更大的跨度遍历链表,从而跳过中间节点,提高操作效率。
1.1 跳表介绍
首先,回顾在单链表中查找数据元素的过程。即使链表中的数据已排序,仍需从头结点开始遍历链表。
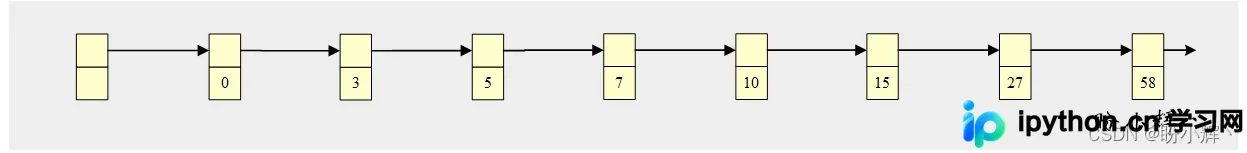
例如,在上述单链表中查找值 15,查找路径为:0-->3-->5 -->7-->10-->15。
为了提高查找效率,可以抽取链表的一部分节点建立“索引”链,称为“索引层”或简称“索引”:
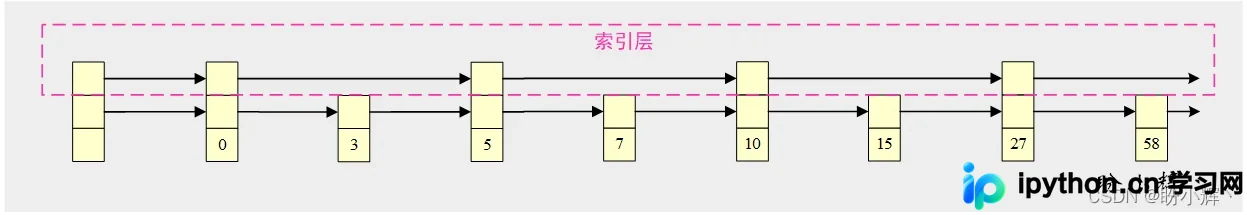
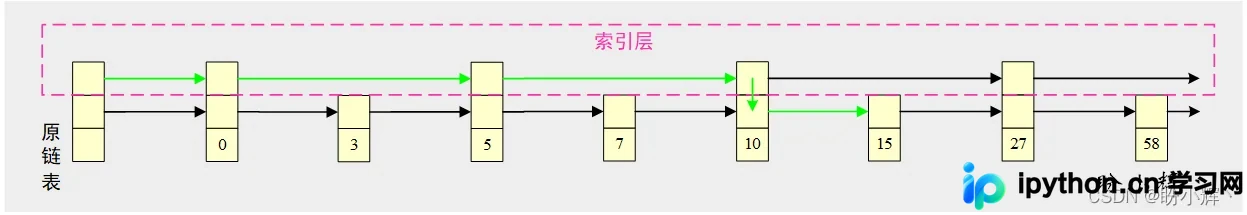
此时查找 15,先在索引层遍历。当扫描到值为 10 的节点时,由于下一节点值为 27,可知 15 位于这两个节点之间,随后回到原链表遍历即可找到值为 15 的节点。遍历过程如图中绿色箭头所示:
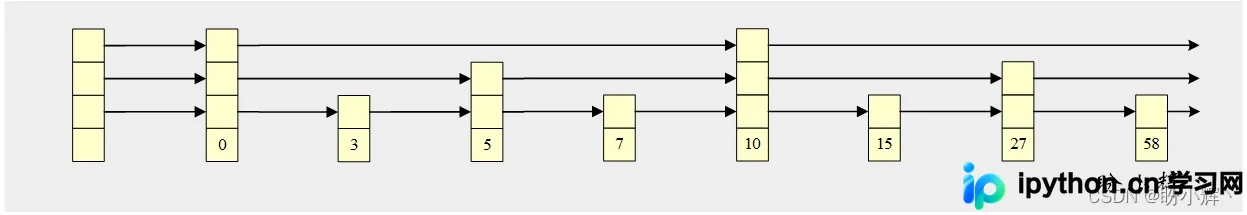
建立索引链减少了需要遍历的节点数。为进一步减少遍历节点数,可对索引链再添加索引,跳表即是对链表叠加多级索引的数据结构。
1.2 跳表的性能
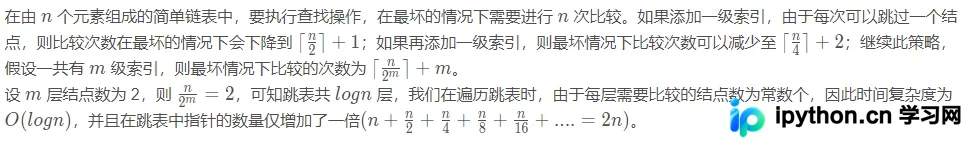
1.3 跳表与普通链表的异同
可将跳表理解为排序后的链表,但与普通链表相比,存在以下不同点:
- 普通链表节点仅含一个 next 指针,而跳表节点包含多个 next 指针;
- 给定节点的 next 指针数量是随机确定的。
跳表中节点的每个 next 指针称为一层,节点中的层数称为节点的大小,决定了节点在链表中的层级。在普通有序链表中,插入、删除和查找操作需依次遍历链表,时间复杂度均为O(n);跳表允许遍历时跳过部分中间节点,使每个操作的时间复杂度降为O(㏒n)。
2. 跳表的实现
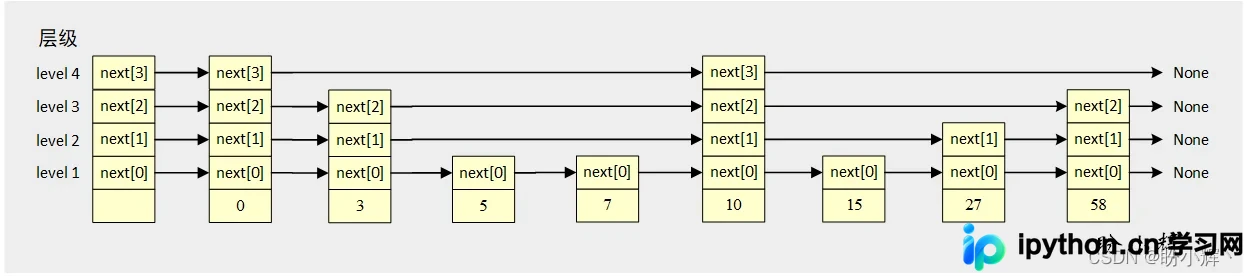
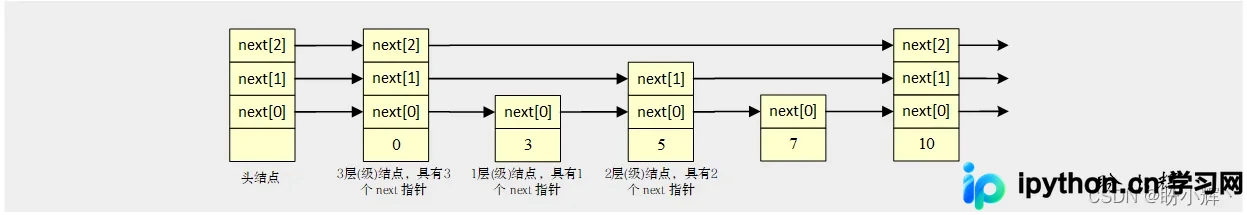
跳表中每个数据元素由一个节点表示,节点层级在插入时随机选择,与数据结构中数据元素数量无关。第i级节点包含i个next指针(实现时使用大小为i的数组 next 存储这i个next指针),因此无需在节点中存储层级信息,而是使用最大层数 max_level 来限制层级上限。跳表的头节点拥有从 1 级到 max_level 级的 next 指针。
2.1 跳表结点类
跳表节点示意图如下所示,每个节点均有一组用于指向其他层级节点的指针域列表 next:
class Node:
    def __init__(self, data, level=0):
        self.data = data
        self.next = [None] * level

    def __str__(self):
        return "Node({}, {})".format(self.data, len(self.next))
next 数组用于保存指向不同层级节点的指针,其中每个元素即为一个 next 指针;data 变量用于存储数据。通过重载 __str__ 方法便于打印节点对象,len(self.next) 可用于表示节点中的层数。
2.2 跳表的初始化
跳表初始化即建立一个空的带头节点的跳表,其表长 length 初始化为 0。此时链表中无元素节点,仅有一个头节点:
class SkipList:
    def __init__(self, max_level=8):
        self.max_level = max_level
        node = Node(Node, max_level)
        self.head = node
        self.length = 0
创建跳表 SkipList 对象的时间复杂度为O(1)。
2.3 获取跳表长度
求取跳表长度只需重载 __len__ 从对象返回 length 的值,因此时间复杂度为O(1):
    def __len__(self):
        return self.length
2.4 读取指定位置元素
由于跳表中每个节点的层级在插入时随机选择,读取指定位置的数据元素与单链表类似,需顺序遍历第0层节点,操作复杂度为O(n)。如果索引不在可接受的索引范围内,将引发 IndexError 异常:
    def __getitem__(self, index):
        if index > self.length - 1 or index < 0:
            raise IndexError("UnrolledLinkedList assignment index out of range")
        else:
            count = 0
            node = self.head.next[0]
            while count < index:
                node = node.next[0]
                count += 1
            return node.data
2.5 查找指定元素
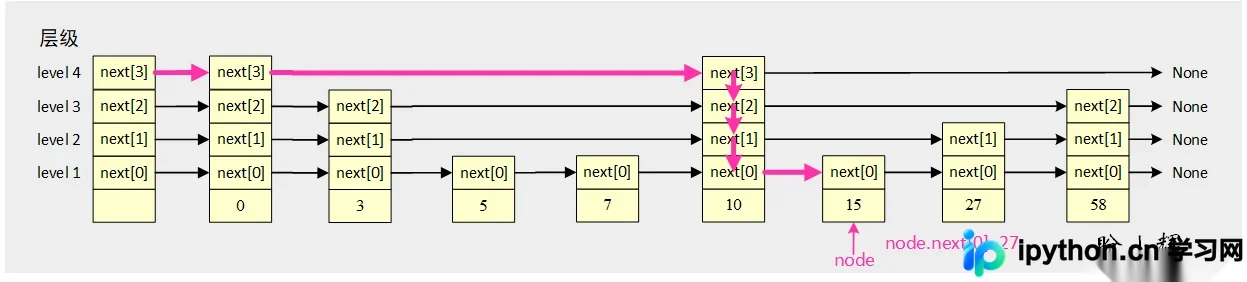
跳表的查找操作从最上层开始。若待查元素 value 小于当前层的后继节点的 data,则平移至当前层的后继节点;否则下移进入下一层,继续比较,直至第一层。
    def locate(self, value):
        node = self.head
        # 由于索引从0开始,因此第i层级的索引为i-1
        level = self.max_level - 1
        while level >= 0:
            while node.next[level] != None and node.next[level].data < value:
                # 平移到当前层的后继结点
                node = node.next[level]
            # 下移进入下一层
            level -= 1
        if node.next[0].data == value:
            return node.next[0]
        else:
            raise ValueError("{} is not in skip list".format(value))
2.6 在跳表中插入新元素
与普通链表不同,在跳表中插入新元素不能指定位置(需保证有序性),必须通过查找确定新数据元素的插入位置。
插入元素前,首先需确定该元素所占据的层数 level k,这是通过算法随机生成的。此举可减少算法实现的复杂度,同时保证跳表性能。
    def random_level(self, max_level):
        num = random.randint(1, 2**max_level -1)
        lognum = math.log(num, 2)
        level = int(math.floor(lognum))
        return max_level - level
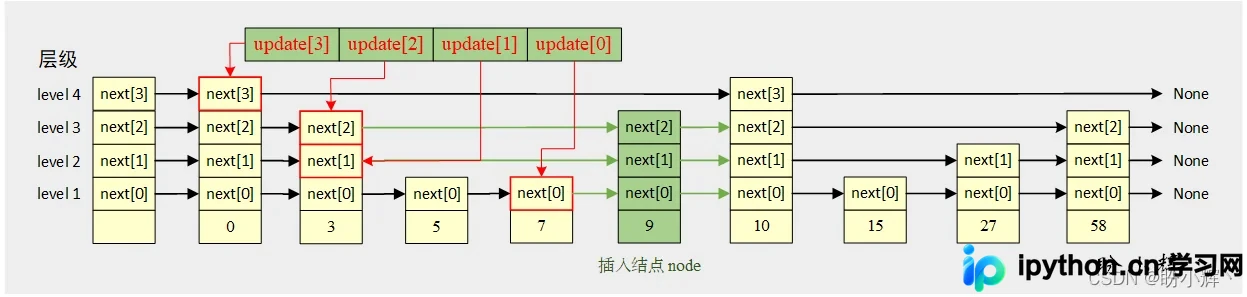
随后需在 level 1, level 2, ..., level k 各层的链表中都插入新元素。为此,在查找插入位置时需维护一个列表 update。update 中的每个元素 update[i] 指向 level i 中小于插入元素 data 的最右边节点(即插入位置的左侧),如下图所示,插入元素 data = 9,随机层数 k=3:
    def update_list(self, data):
        update = [None] * self.max_level
        node = self.head
        level = self.max_level - 1
        while level >= 0:
            while node.next[level] != None and node.next[level].data < data:
                node = node.next[level]
            update[level] = node
            level -= 1
        return update
维护 update 列表的过程与查找元素类似。根据 update 列表可判断跳表中是否已存在元素 data,若不存在则将其插入跳表中:
    def insert_node(self, data):
        # 产生随机 level,并构造结点
        level = self.random_level(self.max_level)
        node = Node(data, level)
        # 获取 update 列表
        update = self.update_list(data)
        # 插入结点
        if len(update) == 0 or update[0].next[0] == None or update[0].next[0].data != data:
            self.length += 1
            for i in range(level):
                node.next[i] = update[i].next[i]
                update[i].next[i] = node
2.7 删除跳表中指定元素
删除指定元素与插入操作类似:
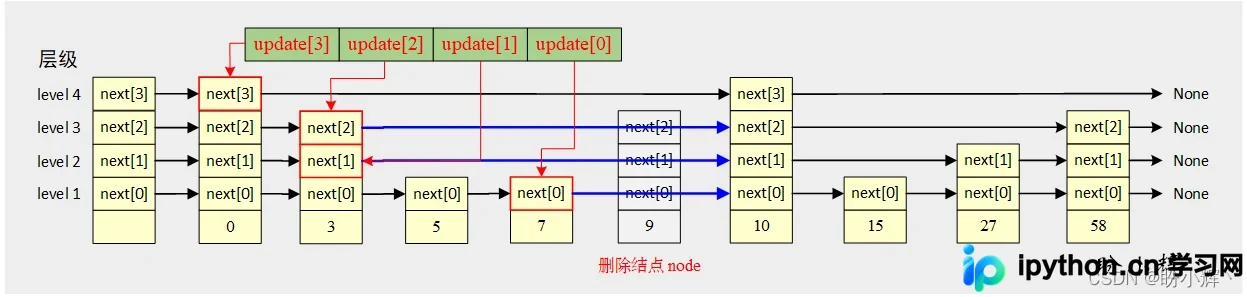
    def delete_node(self, data):
        # 获取 update 列表
        update = self.update_list(data)
        if len(update) > 0:
            node = update[0].next[0]
            # 删除指定元素结点
            if node != None and node.data == data:
                self.length -= 1
                for i in range(len(node.next)):
                    update[i].next[i] = node.next[i]
                del node
2.8 其它一些有用的操作
1.跳表指定层元素输出
将跳表指定层转换为字符串以便打印,编写 print_level 方法打印指定层中数据元素:
def get_level(self, level):
        """辅助函数,用于根据给定层构造结果字符串"""
        node = self.head.next[level]
        result = ''
        while node:
            result = result + str(node.data) + '-->'
            node = node.next[level]
        result += 'None'
        return result

    def print_level(self, level):
        print('level {}'.format(level))
        result = self.get_level(level)
        print(result)
2.跳表各层元素输出
可借助上述辅助函数 get_level,使用 str 函数调用对象上的 __str__ 方法创建适合打印的字符串表示:
    def __str__(self):
        result = ''
        for i in list(range(self.max_level))[self.max_level-1:0:-1]:
            result = result + self.get_level(i) + '\n'
        result += self.get_level(0)
        return result
3. 跳表应用
接下来,我们将测试上述实现的链表,以验证操作的有效性。
3.1 跳表应用示例
首先初始化一个跳表 sl,并在其中插入若干元素:
sl = SkipList(4)
for i in range(0, 30, 3):
    sl.insert_node(i)
可直接打印跳表中的数据元素、链表长度等信息:
print('跳表 sl 各层元素为:')
print(sl)
print('跳表 sl 长度为:', len(sl))
print('跳表 sl 第 2 个元素为:', sl[2])
以上代码输出如下:
跳表 sl 各层元素为:
9-->None
0-->9-->18-->None
0-->9-->18-->27-->None
0-->3-->6-->9-->12-->15-->18-->21-->24-->27-->None
跳表 sl 长度为: 10
跳表 sl 第 2 个元素为: 6
接下来,演示在添加/删除元素、以及如何查找指定元素等操作:
# 插入元素
sl.insert_node(14)
print('在跳表 sl 中插入数据 14 后:')
print(sl)
# 删除元素
sl.delete_node(14)
print('删除跳表 sl 中数据 14 后:')
print(sl)
# 查找数据元素 15
print('查找跳表 sl 中数据元素 15:', sl.locate(15))
以上代码输出如下:
在跳表 sl 中插入数据 14 后:
9-->None
0-->9-->18-->None
0-->9-->14-->18-->27-->None
0-->3-->6-->9-->12-->14-->15-->18-->21-->24-->27-->None
删除跳表 sl 中数据 14 后:
9-->None
0-->9-->18-->None
0-->9-->18-->27-->None
0-->3-->6-->9-->12-->15-->18-->21-->24-->27-->None
查找跳表 sl 中数据元素 15: Node(15, 1)
以上就是Python数据结构与算法之跳表详解的详细内容,更多关于Python跳表的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















