


Python爬取CCTV今日说法数据实战:API接口与Excel存储

发布时间:2026-10-15 |
2人浏览过
本文介绍使用Python爬取CCTV《今日说法》节目数据的方法。通过调用CCTV视频API接口获取每期节目的时间与简介,利用requests库发起请求,并结合xlwt库将结果保存为Excel文件。文章提供了完整的代码示例,展示了如何解析JSON数据并处理分页逻辑,适合希望学习基础爬虫技术的数据爱好者参考。
实验目的
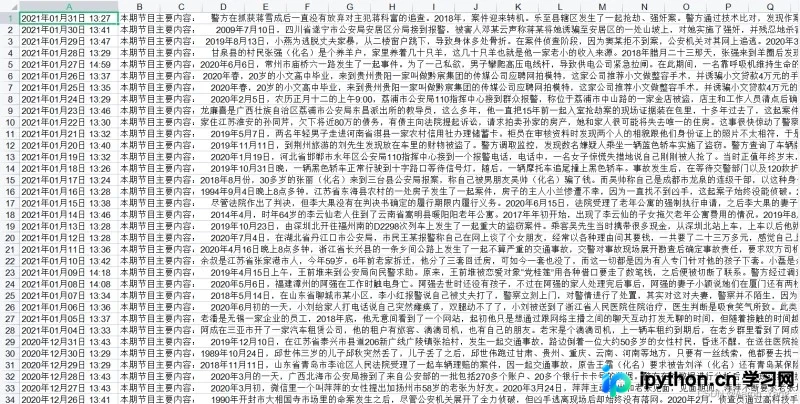
本次实验的核心目标是获取2021年《今日说法》每一期节目的主要内容及播出时间。目标网站的地址为:http://tv.cctv.com/lm/jrsf/index.shtml。由于撰写时的具体思路已部分模糊,此处先展示相关代码,后续若有时间再补充详细解释。
代码
import xlwt
import re

import requests


# url = "https://tv.cctv.com/lm/jrsf/index.shtml"

def get_data(page):
    url = 'https://api.cntv.cn/NewVideo/getVideoListByColumn?id=TOPC145146466500891' \
          '4&n=1000&sort=desc&p={pageNo}&mode=0&serviceId=tvcctv&cb=Callback'.format(pageNo=page)
    headers = {
        'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 '
                      '(KHTML, like Gecko) Chrome/92.0.4515.131 Safari/537.36'
    }
    response = requests.get(url=url, headers=headers)
    return response.text
    # print(response.text)


if __name__ == "__main__":

    headers = {
        'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 '
                      '(KHTML, like Gecko) Chrome/92.0.4515.131 Safari/537.36'
    }

    book = xlwt.Workbook(encoding='utf-8', style_compression=0)
    sheet = book.add_sheet('今日说法', cell_overwrite_ok=True)

    count = 0
    for page in range(1,5):
        page_content = get_data(page)
        obj = re.compile(r'url":"(.*?.shtml)"', re.S)
        imgUrl = re.findall(obj, page_content.replace('\\', ''))
        for i in range(len(imgUrl)):
            resp = requests.get(url=imgUrl[i], headers=headers)
            resp.encoding = 'utf-8'

            obj2 = re.compile(r'更新时间:</em>(.*?)</p>', re.S)
            time = re.findall(obj2, resp.text)
            obj3 = re.compile(r'视频简介:</em>(.*?)</p>', re.S)
            jianjie = re.findall(obj3, resp.text)
            content = []
            content.append(time)
            content.append(jianjie)
            for j in range(2):
                sheet.write(count, j, content[j])
                count+=1

    book.save("./data_5.xls")
实验结果
总结
至此,关于使用Python爬取《今日说法》每期数据的介绍已告一段落。如需了解更多相关Python爬取《今日说法》的内容,建议搜索本站历史文章或继续浏览下方的相关文章。希望大家今后能多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















