


Python正则表达式入门:常用符号与实战技巧详解

本文系统梳理Python中正则表达式的核心用法,涵盖re模块引入、常用元字符(如\d, \w, \s)及量词(+, *, ?)的具体含义。通过实例解析如何提取连续数字、识别单词边界及处理特殊字符,并演示利用search函数结合切片操作完整提取字符串中所有单词的实战方法,适合Python初学者快速掌握文本处理技能。
Python正则表达式基础与re模块
1.正则表达式
正则表达式主要用于字符串的匹配与查找,在从网络爬取数据等场景中应用广泛。在Python中使用正则表达式前,需先导入re模块,且正则表达式字符串通常以r前缀引导,例如:
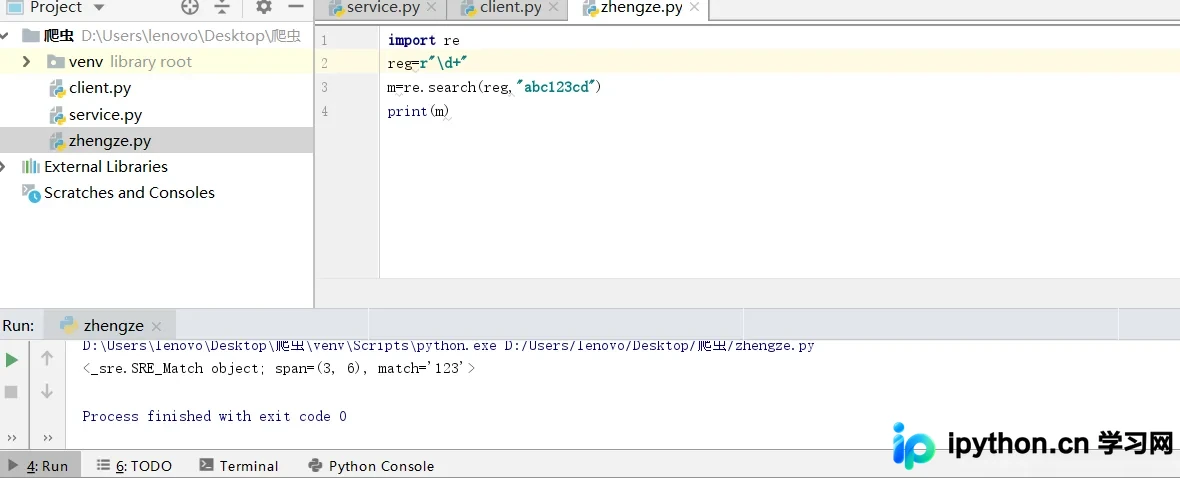
其中**r“\d+”**表示匹配连续的一个或多个数字。使用re模块中的search函数在字符串"abc123cd"中搜索连续数值,成功匹配到"123"并返回一个匹配对象,具体结果如上所示。
常用元字符与量词详解
2.字符"\d"用于匹配0到9之间的任意单个数字。
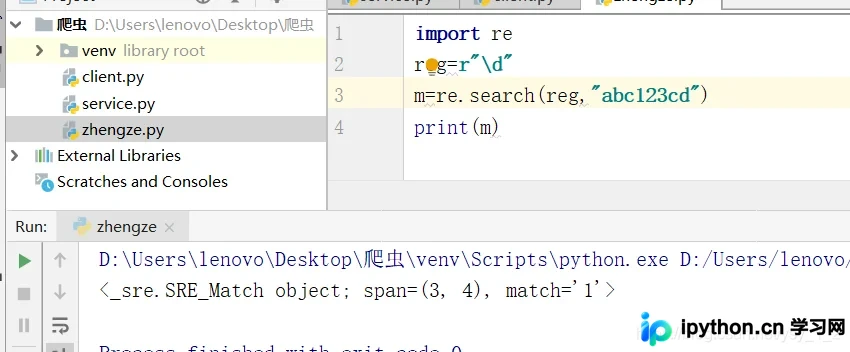
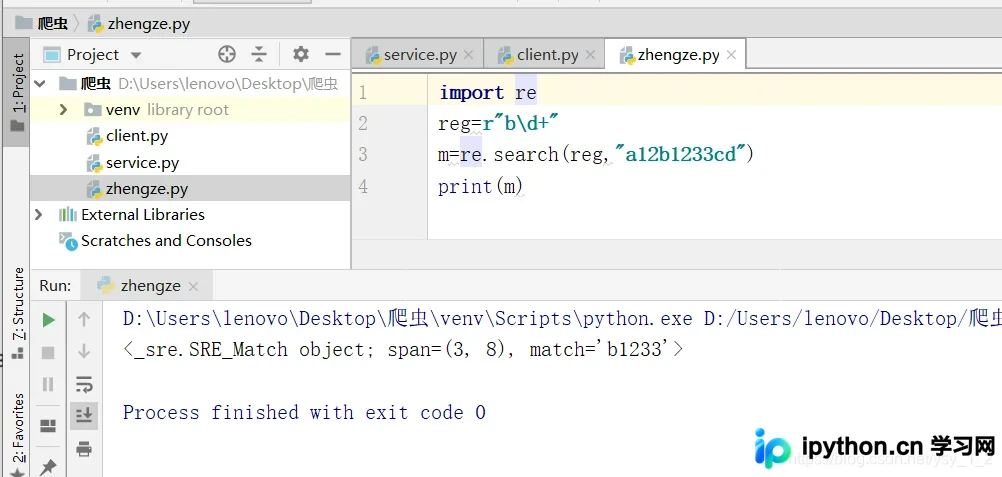
3.字符"+"表示重复前面的匹配字符一次或多次。
注意:**r“b\d+”**要求第一个字符必须匹配"b",随后跟随连续多个数字。因此该模式能匹配"b1233",却无法匹配"a12"。
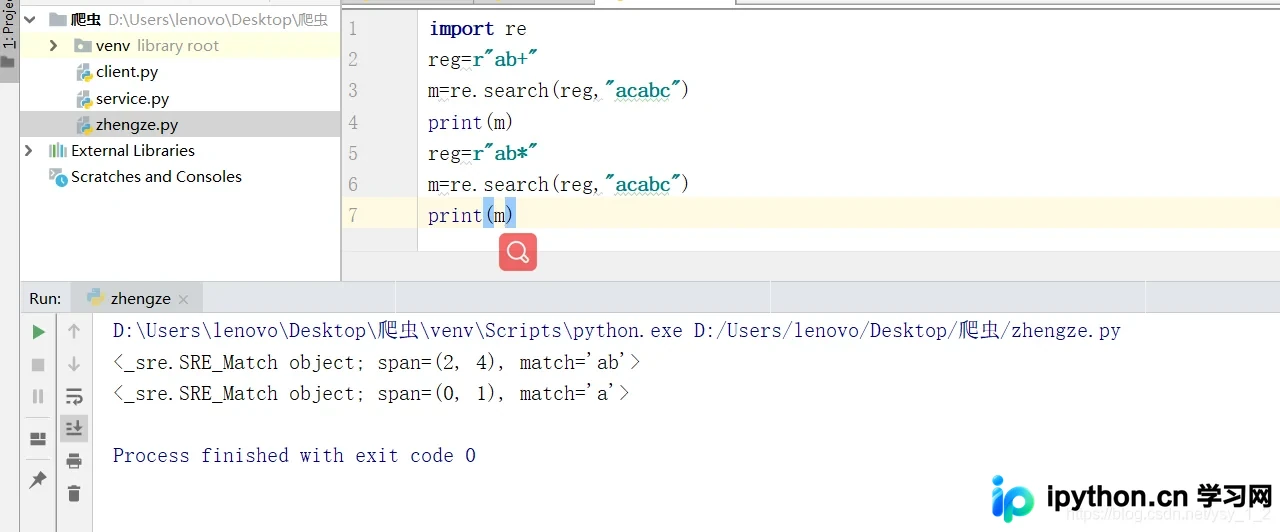
4.字符"*"表示重复前面的匹配字符零次或多次。
“*”与“+”类似但存在区别,例如:
可见r"ab+“匹配的是"ab”,而r"ab*“匹配的是"a"。这是因为“*”允许"b"重复零次,而“+”强制要求"b"至少出现一次。
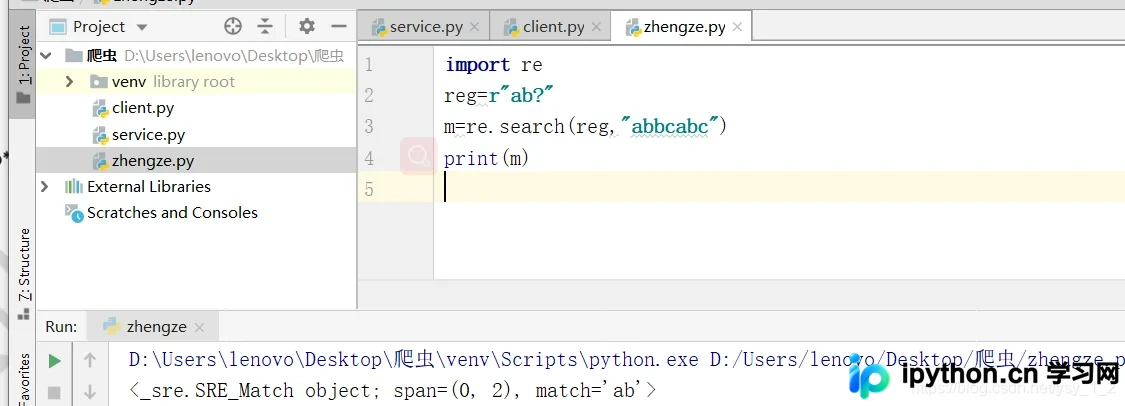
5.字符"?"表示重复前面的匹配字符零次或一次。
匹配结果为"ab",此处"b"重复了一次。
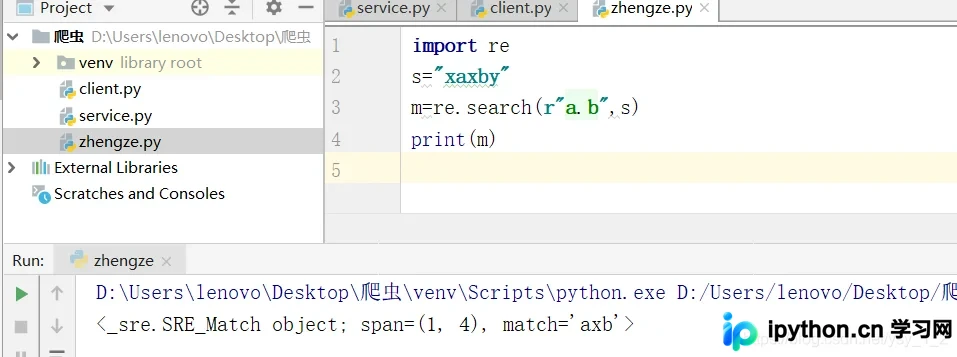
6.字符"."代表除换行符(\n)以外的任意单个字符,除非特别声明。
结果中“.”成功代表了字符"x"。
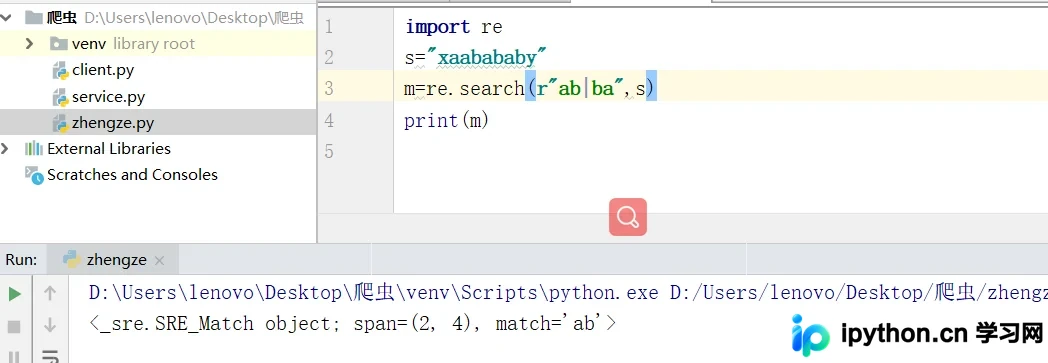
7."|"符号用于将左右两侧分为两个独立的匹配部分。
结果中匹配"ab"或"ba"均可成功。
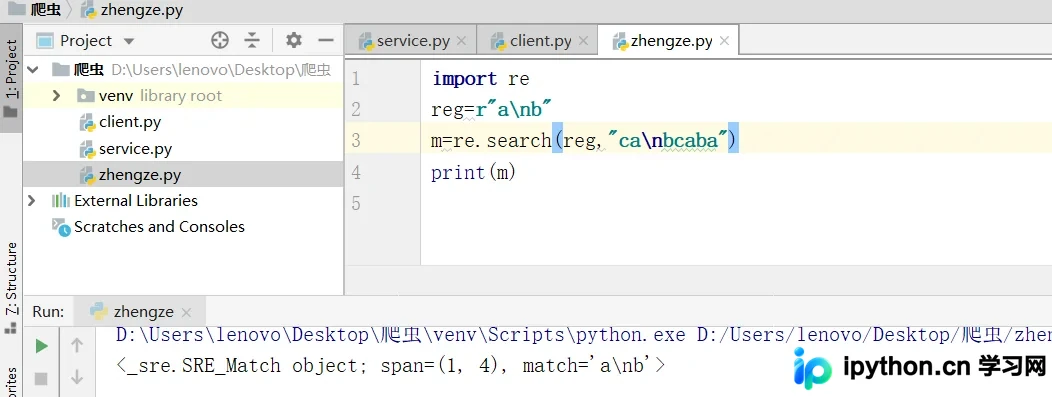
8.特殊字符需使用反斜杠"\"引导,例如"\r"、"\n"、"\t"分别表示回车、换行和制表符,而"\\"表示反斜线本身。
特殊字符与边界匹配
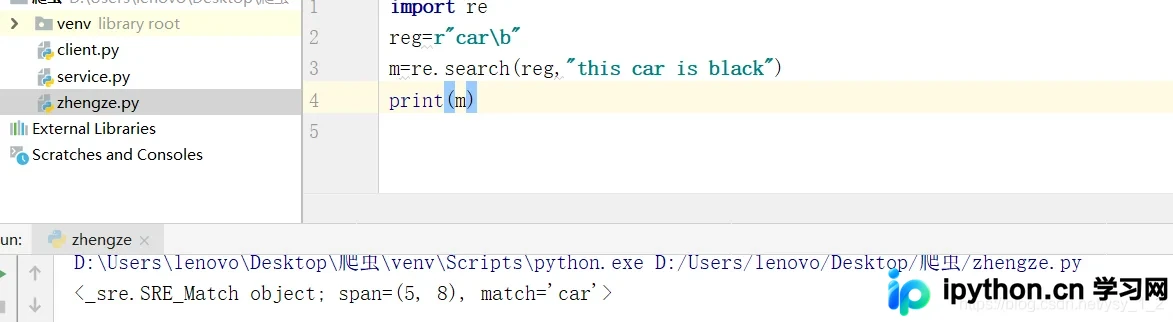
9.字符"\b"表示单词边界,即单词结尾,包括各种空白字符或字符串末尾。
结果匹配"car",因为"car"后面紧跟着一个空格。
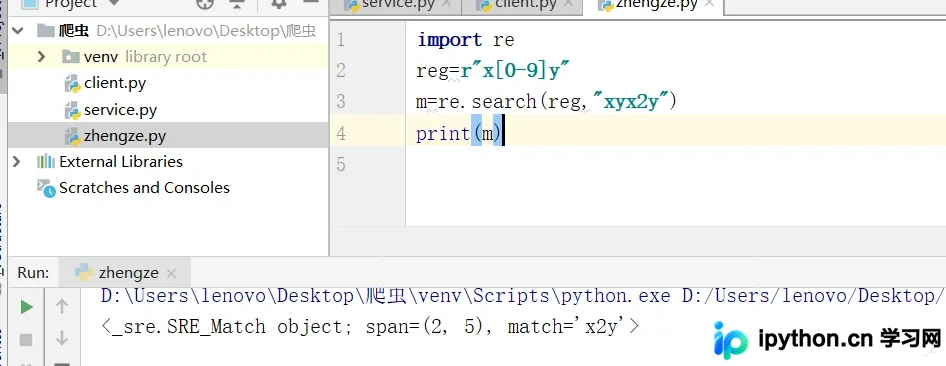
10."[]"内的字符表示任选其一,若字符在ASCII码中连续,可使用"-"连接,例如[0-9]表示0-9中的任意数字,[A-Z]表示A-Z中的任意大写字母,[0-9A-z]表示0-9的数字或A-z的大写字母。
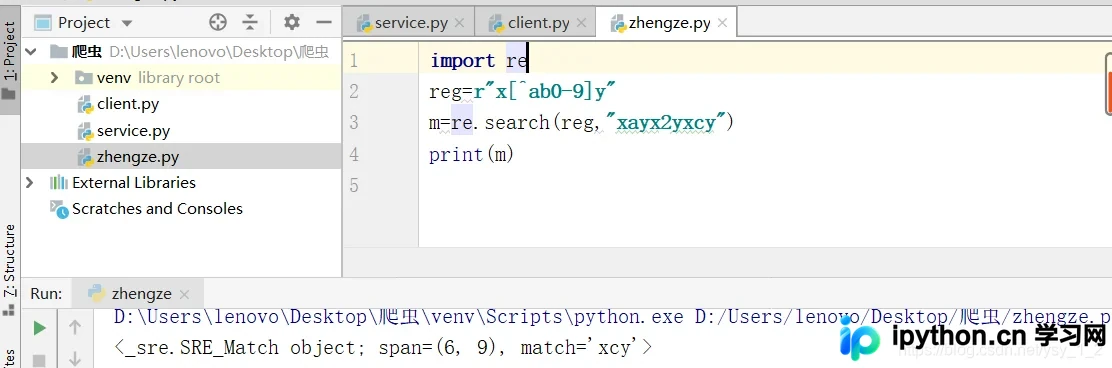
11."^"若出现在[]的第一个字符位置,表示取反,例如[^ab0-9]表示既不是a、b,也不是0-9的数字。
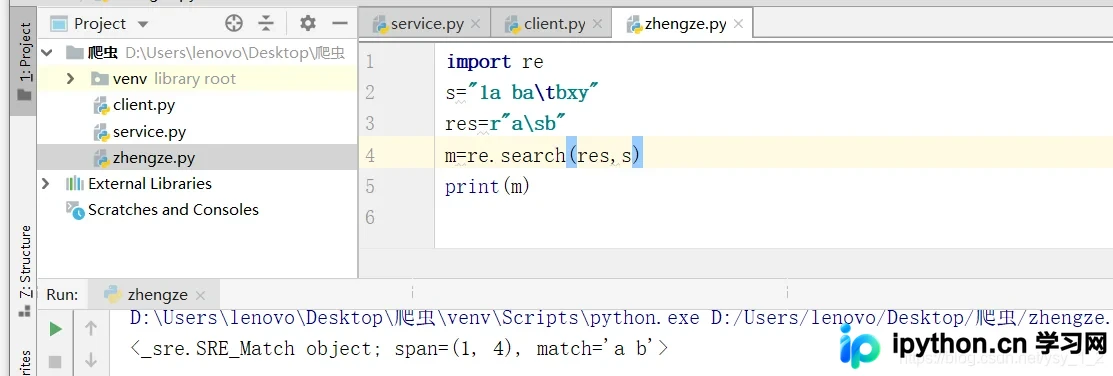
12."\s"匹配任何空白字符,等价于"[\r\n\x20\t\f\v]"。
13."\w"匹配包括下划线在内的单词字符,等价于"[a-zA-Z0-9]"。
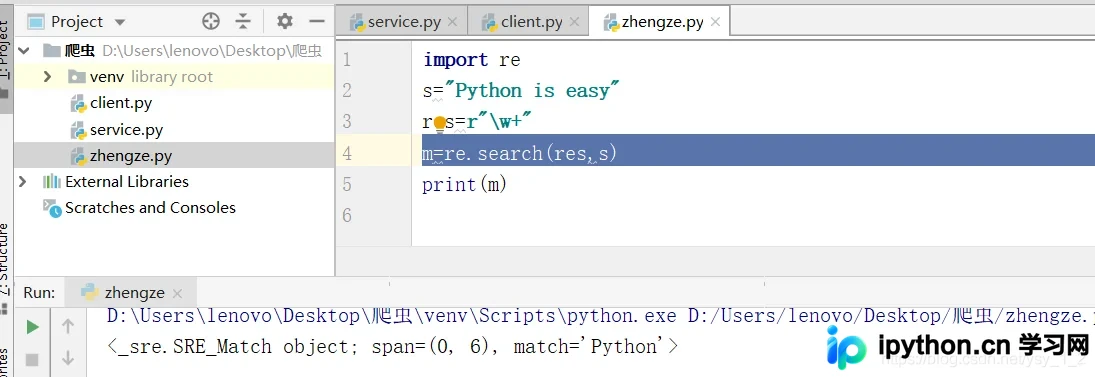
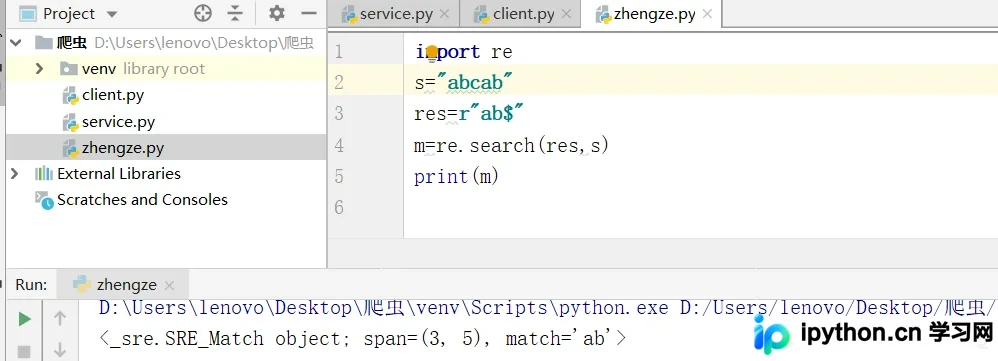
14."$"字符用于匹配字符串的结尾位置。
分组与字符串查找实战
匹配结果是最后一个"ab",而非第一个"ab"。
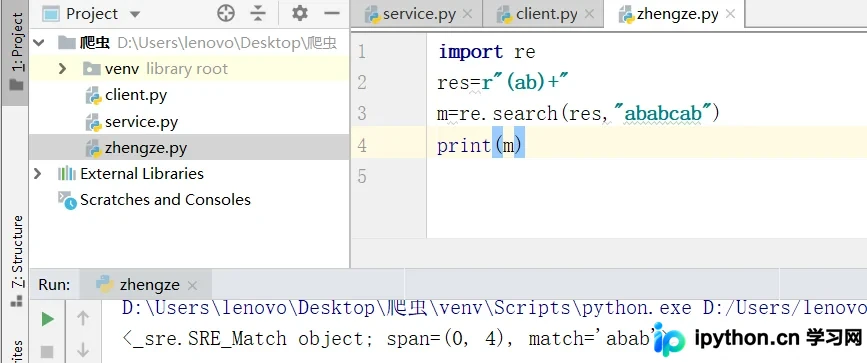
15.使用括号(…)可将内容视为一个整体,常与"+"、"*"、"?"连用,对括号内的部分进行重复操作。
结果匹配"abab",其中“+”对"ab"进行了重复。
16.查找匹配字符串
正则表达式re库的search函数利用正则表达式对目标字符串进行匹配,若未匹配成功则返回None,成功则返回一个匹配对象。通过调用匹配对象的start()函数可获取匹配字符的起始位置,调用end()函数可获取结束位置。虽然search仅返回第一次匹配结果,但通过连续调用search函数即可找到字符串中所有匹配项。
匹配找出英文句子中所有单词
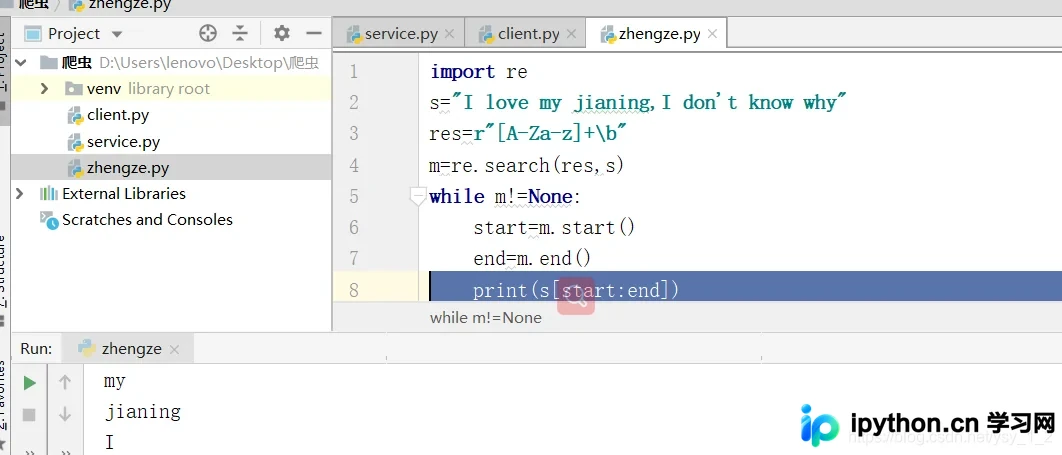
我们可以使用正则表达式r“[A-Za-z]+\b”来匹配单词,该表达式表示匹配由大小写字母组成的连续字符序列(通常为一个单词),随后"\b"表示单词边界。
程序在匹配到一个单词后,通过m.start()和m.end()获取单词的起始和结束位置,利用s[start:end]截取该单词。随后程序再次对剩余字符串s=s[end:]进行匹配,即处理字符串的后半段,直至匹配完毕,从而找出每个单词。
总结
到此这篇关于python常用正则表达式的文章就介绍到这了,更多相关python正则表达式内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















