


Python将DataFrame数据写入MySQL数据库的两种方法及to_sql详解

本文介绍利用Python将大型CSV数据文件高效写入MySQL数据库的方法。重点解析pd.io.sql.to_sql()函数的使用,包括create_engine连接参数配置及if_exists选项(append、fail、replace)的区别。通过上海公交卡数据实例,展示如何避免内存拥堵并实现数据持久化存储。
Python数据写入MySQL背景与方案对比
背景介绍:
本文以上海市2016年9月1日的公共交通卡刷卡记录数据为例进行演示。
具体数据形态如图所示:

为了挖掘上海市通勤规律,需要处理源文件。由于原始CSV文件体积超过800MB,直接使用Python读取会导致运行缓慢且界面卡顿。因此,计划将数据导入MySQL数据库中进行后续处理。以往通常通过workbench进行可视化操作导入,本次尝试通过代码自动化实现,重点探讨如何将CSV文件通过Python导入数据库。通常,Python将数据框写入数据库主要有两种实现路径。
第一种方法是利用insert into命令逐条插入数据:
这种方式的优势在于可以边抓取数据边插入,整体流程衔接紧密,且能避免一次性将海量数据载入数据库引发拥堵问题。
第二种方法是使用pd.io.sql.to_sql(),将整个数据框以追加模式一次性写入数据库。
本文主要深入探讨第二种方法的具体实现。
核心代码实现与参数详解
具体实现代码如下:
import pandas as pd  #导入数据分析模块
import pymysql #导入数据库接口模块
from sqlalchemy import create_engine
data=pd.read_csv(r"D:\数据\yikatongchengkeshuakashuju\201608\SPTCC20160901.csv",engine='python',header=None) #读取数据encoding='mbcs',
data.columns=["卡号","日期","时间","站点","交通方式","费用","是否有优惠"] #由于原csv文件没有表头,这里添加表头
#print(data.head()) #测试

db=pymysql.connect("localhost","root","123456","metro_sh",charset="utf8") #链接数据库metro_sh
cursor=db.cursor() #获取游标
cursor.execute("drop table if exists metro_sh_20160901") #以重新写入的方式导入数据表
connect=create_engine("mysql+pymysql://root:123456@localhost:3306/metro_sh?charset=utf8")
pd.io.sql.to_sql(data,"metro_sh_20160901",connect,schema="metro_sh",index=False,if_exists="append")
执行结果截图如下:
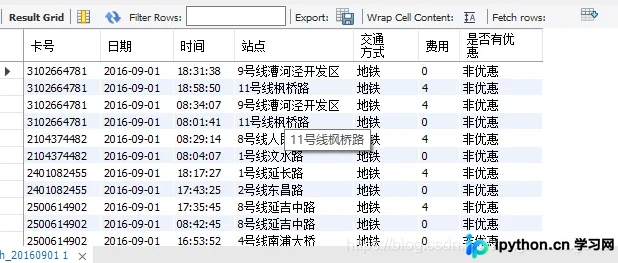
代码关键部分解读:
关于create_engine()函数的参数配置说明:
连接字符串格式为create_engine(mysql+mysqldb://用户名:密码@localhost:端口/数据库名?编码)。在设置数据库编码时,建议保持与pd.read_csv()中encoding参数的一致性,以确保数据读取和写入的编码匹配。
关于pd.io.sql.to_sql()函数的参数配置说明:
函数调用格式为(数据框, ‘表名’, con=连接对象, schema=‘数据库名’, if_exists=‘操作策略’)。其中,if_exists参数决定了当目标表已存在时的处理策略,可选值包括append、fail和replace。
append:若目标表已存在,则将新数据追加到现有数据之后。fail:若目标表已存在,则拒绝写入操作并报错。replace:若目标表已存在,则先删除该表,再重新创建并写入数据。
该方法存在一个明显的局限性:
由于采用整体写入策略,内存消耗较大。如果服务器内存充足,可以尝试此方法;否则需考虑分批处理。
方法优缺点总结
以上就是关于Python将数据框写入MySQL数据库的详细教程,更多相关技术内容可查阅本站往期文章或继续关注后续更新,感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















