


Python re模块正则表达式核心用法与实战指南

本文详解Python中re模块的正则表达式应用。涵盖元字符使用、compile预编译优化、match与search匹配差异、findall/finditer查找、sub/subn替换及split分割。重点解析group与groups分组提取技巧,结合代码示例展示常用函数的高级用法与标志参数设置。
一、基础概述
正则表达式并非Python独有,而是一门小型且高度专业化的编程语言,是众多编程语言中基础且关键的一部分。在Python生态中,主要通过内置的re模块来调用和实现正则表达式的功能。
在底层实现上,正则表达式模式会被编译成一系列字节码,随后由C语言编写的匹配引擎执行。了解其工作原理后,我们来看看正则表达式通常应用于哪些场景?
首先,用于为需要匹配的字符串集合制定特定的规则;
该字符串集合可以涵盖电子邮件地址、互联网网址、电话号码,或是根据具体业务需求自定义的任何字符串集合;
其次,用于验证某个字符串是否符合预先定义的匹配规则;
第三,用于在字符串中定位并提取符合该规则的内容部分;
此外,还广泛应用于文本的修改、切割等复杂的文本处理任务中;
......
二、元字符与特殊符号解析
本节介绍常见的元字符,它们赋予了正则表达式强大的匹配能力和灵活性。表2-1列出了使用频率较高的符号和字符及其含义。
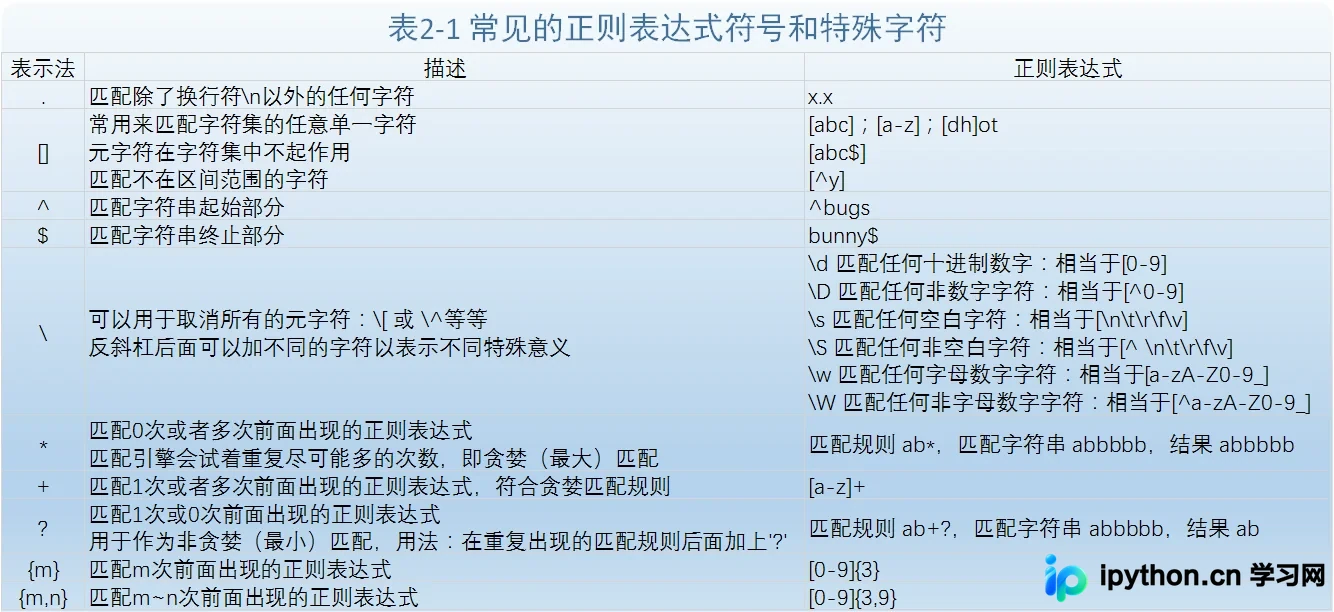
三、正则表达式核心函数与方法
1、利用compile()函数进行正则预编译
鉴于Python代码最终需转换为字节码并在解释器中运行,对于代码中频繁使用的正则表达式进行预编译处理,能够显著提升执行效率。
值得注意的是,re模块中的大多数函数,以及已编译的正则表达式对象和匹配对象的方法,在命名和功能上具有高度的一致性。
具体示例如下:
>>> import re
>>> r1 = r'bugs'       # 字符串前加"r"反斜杠就不会被任何特殊方式处理,这是个习惯,虽然这里没用到
>>> re.findall(r1, 'bugsbunny')    # 直接利用re模块进行解释性地匹配
['bugs']
>>>
>>> r2 = re.compile(r1)      # 如果r1这个匹配规则你会经常用到,为了提高效率,那就进行预编译吧
>>> r2          # 编译后的正则对象
<_sre.SRE_Pattern object at 0x7f5d7db99bb0>
>>>
>>> r2.findall('bugsbunny')     # 访问对象的findall方法得到的匹配结果与上面是一致的
['bugs']         # 所以说,re模块中的大多数函数和已经编译的正则表达式对象和正则匹配对象的方法同名并且具有相同的功能
re.compile()函数支持接收可选的标志参数,常用于实现特定的特殊功能或语法变更。这些标志参数同样适用于re模块中的大多数其他函数,且多个标志可以通过操作符(|)进行合并使用。
具体示例如下:
>>> import re
>>> r1 = r'bugs'
>>> r2 = re.compile(r1,re.I) # 这里选择的是忽略大小写的标志,完整的是re.IGNORECASE,这里简写re.I
>>> r2.findall('BugsBunny')
['Bugs']<br><br># re.S 使.匹配换行符在内的所有字符<br># re.M 多行匹配,英雄^和$<br># re,X 用来使正则匹配模式组织得更加清晰
关于完整的标志参数列表及其详细用法,建议参考Python官方文档获取最新信息。
2、正则表达式的实际应用场景
re模块提供了访问正则表达式引擎的接口,以下将具体介绍几个常用且核心的函数与方法。
匹配对象及group()与groups()方法解析
在处理正则表达式时,除了正则表达式对象外,还会生成另一种对象类型:匹配对象。这些对象由成功调用match()或search()函数后返回。匹配对象主要包含两个关键方法:group()和groups()。
group()方法用于返回整个匹配结果,或根据指定要求返回特定的子组;groups()方法则返回一个包含所有(或唯一)子组的元组。若未定义子组,当group()返回完整匹配时,groups()将返回一个空元组。后续示例将演示这些方法的具体用法。
使用match()方法进行字符串匹配
match()函数从字符串的起始位置开始尝试匹配模式。若匹配成功,返回一个匹配对象;若失败,则返回None。此时,可通过匹配对象的group()方法查看具体的匹配内容。
代码示例如下:
>>> m = re.match('bugs', 'bugsbunny')  # 模式匹配字符串
>>> if m is not None:      # 如果匹配成功,就输出匹配内容
...  m.group()
...
'bugs'<br>>>> m<br><_sre.SRE_Match object at 0x7f5d7da1f168> # 确认返回的匹配对象
使用search()在字符串中查找模式
search()的工作机制与match()类似,但关键区别在于:search()会在给定字符串中搜索第一次出现的匹配项,即匹配可以发生在字符串的任意位置,而不仅限于起始部分。因此,search()的适用范围比match()更为广泛。
具体示例:
>>> m = re.search('bugs', 'hello bugsbunny')
>>> if m is not None:
...  m.group()
...
'bugs'
使用findall()和finditer()查找所有出现位置
findall()用于查找字符串中所有(非重复)匹配正则表达式的模式,并返回一个包含匹配结果的列表;finditer()与findall()的区别在于,它返回一个迭代器。对于每一次匹配,迭代器都会返回一个对应的匹配对象。
>>> m = re.findall('bugs', 'bugsbunnybugs')
>>> m
['bugs', 'bugs']
>>> m = re.finditer('bugs', 'bugsbunnybugs')
>>> m.next()         # 迭代器用next()方法返回一个匹配对象
<_sre.SRE_Match object at 0x7f5d7da71a58>  # 匹配用group()方法显示出来
>>> m.next().group()
'bugs'
使用sub()和subn()进行搜索与替换
这两个函数均用于将字符串中符合正则表达式的部分进行替换。sub()返回替换后的字符串,可指定替换次数,默认替换所有匹配项;subn()的功能与sub()相同,但额外返回一个表示替换总数的整数。最终,subn()返回一个包含两个元素的元组:替换后的字符串和替换总数。
具体示例:
>>> r = 'a.b'
>>> m = 'acb abc aab aac'
>>> re.sub(r,'hello',m)
'hello abc hello aac'<br>>>> re.subn(r,'hello',m)<br>('hello abc hello aac', 2)
虽然Python字符串内置了replace()方法,但在需要模糊搜索和灵活替换的场景下,sub()方法提供了更强的控制能力。
使用split()分割字符串
Python字符串同样拥有split()方法,但它无法处理基于正则表达式的分割。在re模块中,split()函数利用正则表达式模式作为分隔符,将字符串分割为列表,并返回分割后的成功匹配列表。
具体示例:
>>> s = '1+2-3*4'
>>> re.split(r'[\+\-\*]',s)
['1', '2', '3', '4']
分组技术
在匹配过程中,若仅需提取特定信息或对提取内容进行分类,需对正则匹配模式进行分组。实现方式非常简单,只需在目标部分添加括号()即可。
具体示例:
>>> m = re.match('(\w{3})-(\d{3})','abc-123')
>>> m.group()  # 完整匹配
'abc-123'
>>> m.group(1)  # 子组1
'abc'
>>> m.group(2)  # 子组2
'123'
>>> m.groups()  # 全部子组
('abc', '123')
从上述示例可见,group()通常用于以常规方式显示所有匹配部分,但也可用于获取各个匹配的子组。若需获取包含所有匹配字符串的元组,可使用groups()方法。
以上内容为Python re模块正则表达式的详细解析,旨在帮助读者掌握核心用法。如有任何疑问,欢迎留言交流,小编将及时回复。感谢大家对本站的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















