


Python爬虫实战:从页面解析到基金基本信息抓取

本文详细讲解如何使用Python爬虫获取基金基本信息。针对XPath定位失效的情况,文章演示了如何利用BeautifulSoup库解析HTML页面,通过定位table和td标签提取基金公司、经理、成立时间等关键数据,并展示最终代码实现与结果输出。
1 前言
在上一篇关于Python爬虫获取基金列表的文章中,我们已经介绍了如何从基金网站抓取基金列表信息。本节将继续深入,分享如何进一步抓取并展示基金的基本详细信息。我们需要获取的数据包括基金公司、基金经理、创建时间、追踪标的以及持仓明细等核心内容。
2 如何抓取基本信息
# 在这里我就直接贴地址了,这个地址的获取是从基金列表跳转,然后点基金概况就可以获取到了。
http://fundf10.eastmoney.com/jbgk_005585.html
基金的详情页面与基金的基本信息页面通常包含丰富的数据。
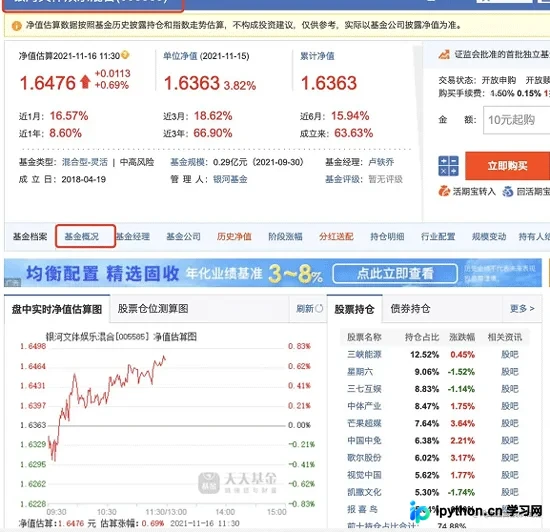
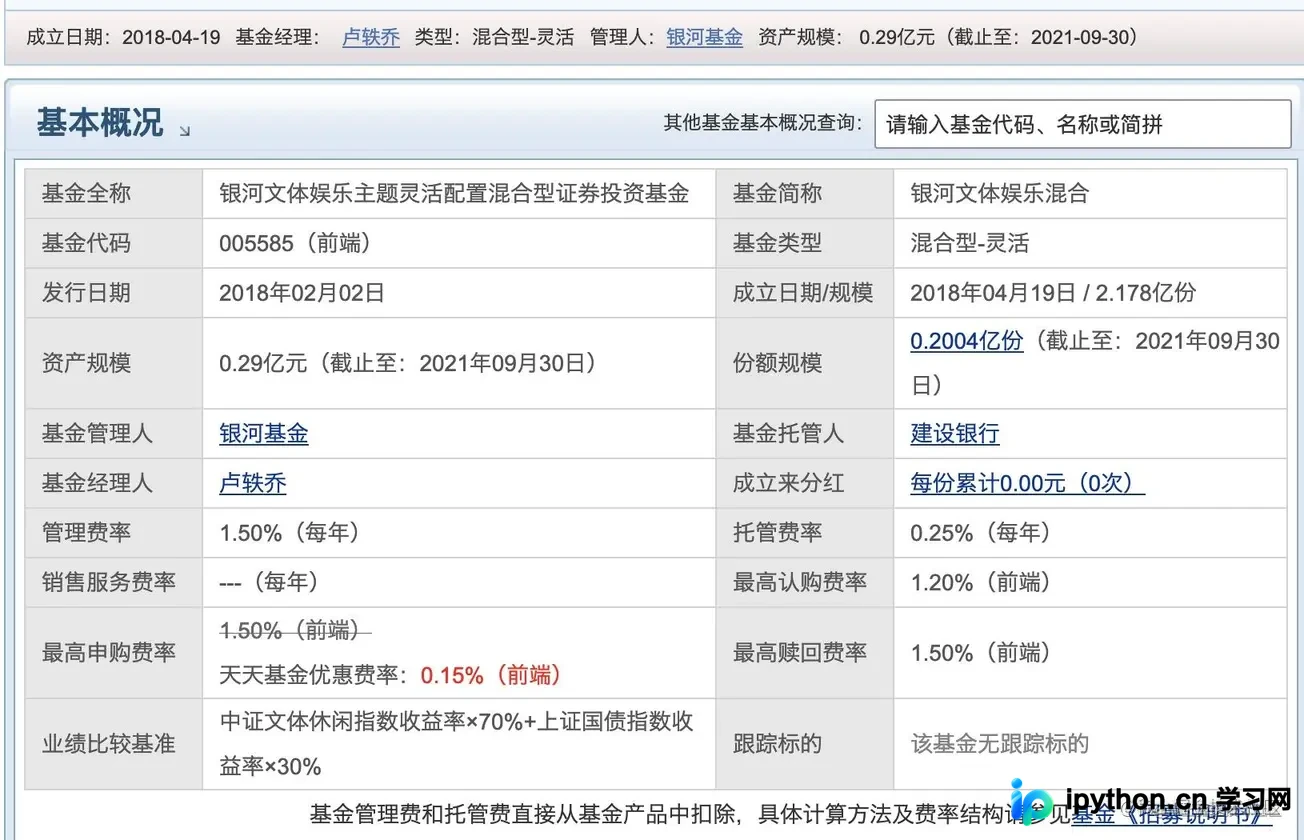
当前的任务是将基金的基本概况数据抓取下来。遗憾的是,这项工作无法像上一次那样直接通过接口调用获取结果,而是需要解析页面HTML,通过定位特定元素来提取所需信息。为此,我们需要使用XPath来获取目标元素。
3 xpath 获取数据
在解析HTML数据时,我们通常首选XPath来获取页面数据。那么具体该如何使用呢?首先需要安装相关的类库。
# 安装 lxml
pip install lxml
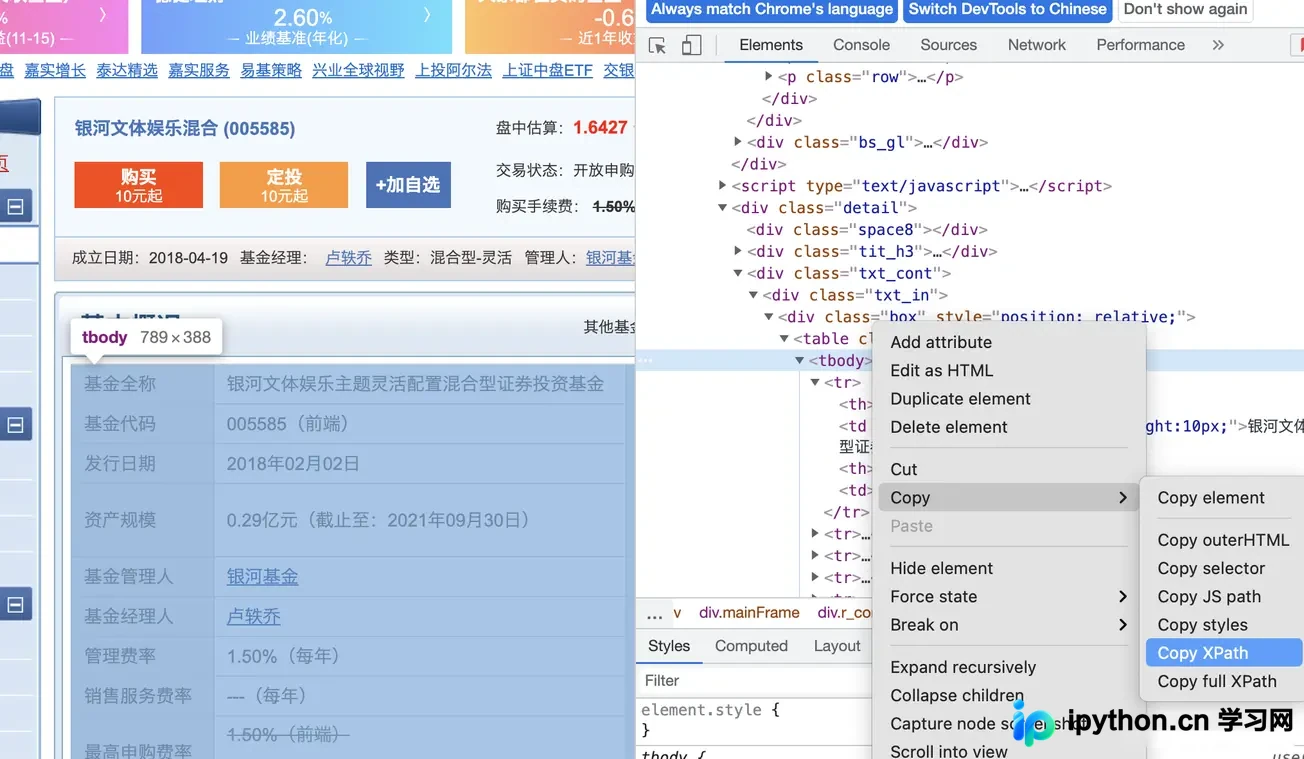
使用浏览器打开目标页面,点击[检查]功能,选中基金基本信息区域,如图所示选择[copy XPath],即可获取到数据所在表格的位置。
from lxml import etree
# ...
# 将返回的数据结果进行解析,形成 html 文档
html = etree.HTML(resp_body)
result = etree.tostring(html, pretty_print=True)
# 打印获取到的结果
print(result)
# 抓取数据的位置,这个地方的数据是通过浏览器的 xpath 定位来确定的
table_body = html.xpath('//*[@id="bodydiv"]/div[8]/div[3]/div[2]/div[3]/div/div[1]/table/tbody')
# 打印数据结果
print(table_body)
按常理推断,这里应该能获取到基金基本信息的结果,但出乎意料的是,获取到的结果竟然为空,令人百思不得其解。起初我怀疑是API使用不够熟练导致无法正确获取,直到仔细研究返回的页面源码,才发现根本没有 tbody 这个元素。这可能是因为浏览器渲染后导致的结果,也就是说,通过 xpath 来定位元素位置以获取数据的路径可能行不通。事实上确实如此,基金基本信息的数据实际上是放在页面的 scripts 标签里面的,因此这条路径确实行不通。XPath通常配合Selenium进行页面自动化测试,这方面的研究留待后续进行。
4 bs4 获取数据
既然直接获取页面元素的方式行不通,那么只能解析返回的页面来获取数据。对于 java 语言,可以使用 joup 来解析获取数据,但是对于 python 该如何操作呢?这就需要使用 bs4 来解决。安装方式如下:
# 简称bs4,python解析html非常好用的第三方类库
pip install beautifulsoup4
其主要使用的解析方法如下图所示。接下来我们使用lxml来解析HTML数据,如果使用 html5lib 的话,需要先进行安装才能使用 pip install html5lib。
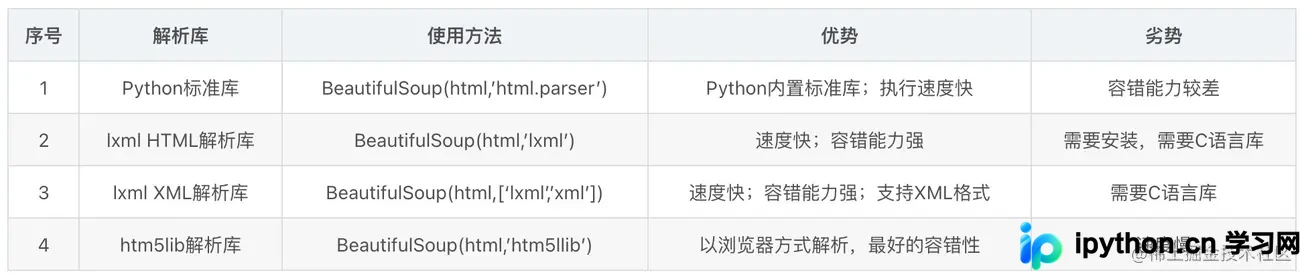
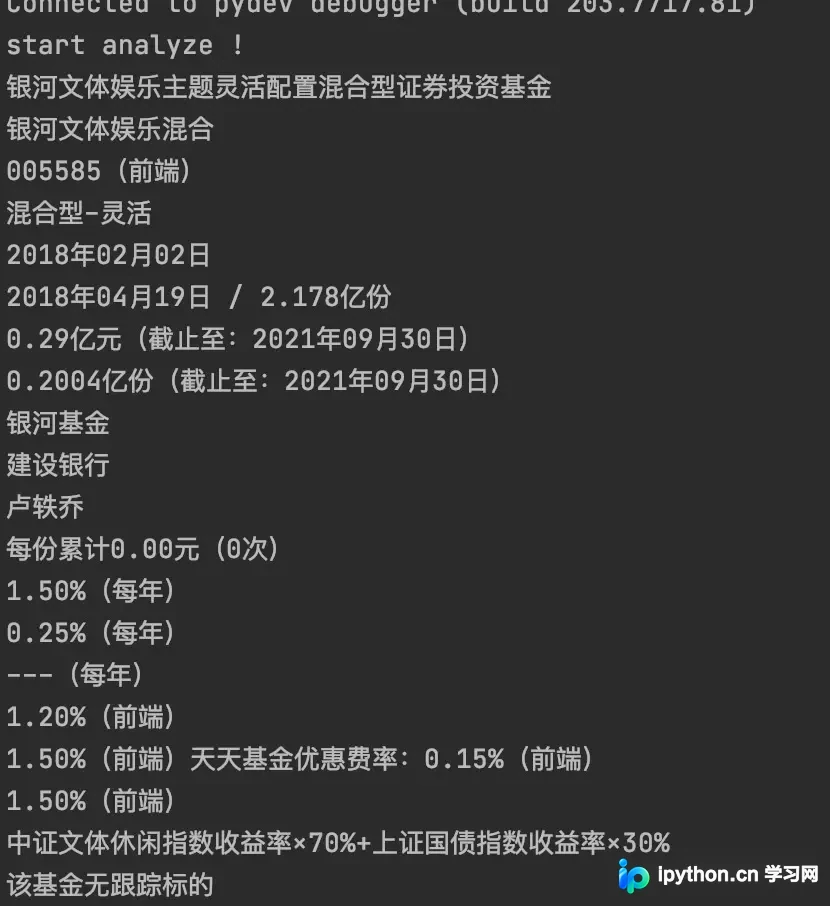
解析数据的思路如下:我们看到浏览器返回的结果包含 table>tr>td 这样的结构。我们先获取到基金对应信息的 table,然后获取到 table 中的 td。由于这个表格展示内容是固定的,我们选取对应的数据下标即可获取对应的数据。
# 解析返回的报文
soup = BeautifulSoup(resp_body, 'lxml')
# 获取数据的table标签所有数据
body_list = soup.find_all("table")
# 基金信息对应的是第二个
basic_info = body_list[1]
# 打印结果并循环输出td的内容
print(basic_info)
td_list = basic_info.find_all("td")
for node in td_list:
print(node.get_text())这里涉及两个方法:find_all 和 get_text。第一个是元素选择器,可以根据标签class进行搜索;第二个是获取元素中的内容。
5 最终结果展现
经过不断的尝试,最终的最简版代码如下所示:
from lxml import etree
import requests
from prettytable import PrettyTable
import datetime
# 使用BeautifulSoup解析网页
from bs4 import BeautifulSoup
# 获取基金基本信息
def query_fund_basic(code):
    # http://fundf10.eastmoney.com/jbgk_005585.html
    response = requests.get("http://fundf10.eastmoney.com/jbgk_{}.html".format(code))
    resp_body = response.text
    soup = BeautifulSoup(resp_body, 'lxml')
    body_list = soup.find_all("table")
    basic_info = body_list[1]
    # print(basic_info)
    tr_list = basic_info.find_all("td")
    # 暂存一下列表
    tmp_list = []
    tmp_list.append(tr_list[2].get_text().replace("(前端)", ""))
    tmp_list.append(tr_list[1].get_text())
    tmp_list.append(tr_list[8].get_text())
    tmp_list.append(tr_list[10].get_text())
    tmp_list.append(tr_list[5].get_text().split("/")[0].strip())
    tmp_list.append(tr_list[5].get_text().split("/")[1].strip().replace("亿份", ""))
    tmp_list.append(tr_list[3].get_text())
    tmp_list.append(tr_list[18].get_text())
    tmp_list.append(tr_list[19].get_text())
    return tmp_list
if __name__ == '__main__':
    print("start analyze !")
    code_list = ["005585", "000362"]
    # 需要关注的基本信息如右所示 基金代码 基金名称 基金公司 基金经理 创建时间
    # 基金份额 基金类型 业绩基准 跟踪标的
    head_list = ["code", "name", "company", "manager", "create_time",
    "fund_share", "fund_type", "comp_basic", "idx_target"]
     # 生成表格对象
    tb = PrettyTable()
    tb.field_names = head_list  # 定义表头
    for node in code_list:
       tb.add_row(query_fund_basic(node))
    # 输出表格
    print(tb)
    reslt = str(tb).replace("+", "|")
    print(reslt)
最终打印的结果如下所示,看起来非常直观:
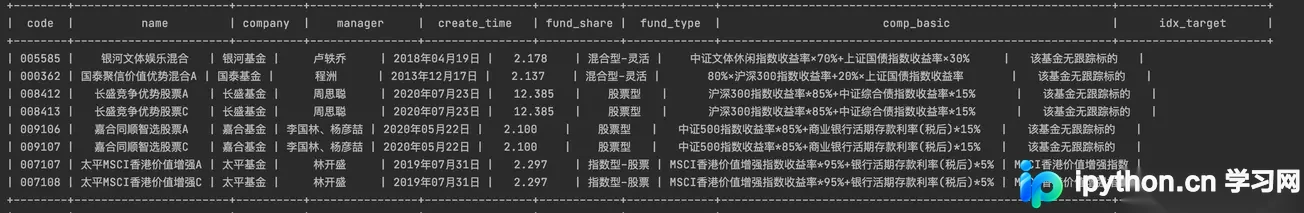
接下来,我们将利用数据库存储基金的基本信息,并基于此抓取基金的变动信息进行分析,距离激动人心的时刻已经很近了。
到此这篇关于Python爬虫获取基金基本信息的文章就介绍到这了,更多相关Python获取信息内容请搜索本站以前的文章或继续浏览下面的相关文章,希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















