


Python自动化办公:使用python-docx读取Word文档内容

本文介绍如何使用Python的python-docx库实现Word文档的自动化读取。通过解析Document对象,获取段落(Paragraph)和表格(Table)内容,提取其中的文本字符串。文章涵盖库的安装、核心概念解析以及具体的代码示例,帮助开发者快速掌握Word文件内容提取技巧。
前言
在前面的章节中,我们已经掌握了普通文件的基本操作,包括文件的创建、复制、粘贴、重命名以及删除等。此外,我们还练习了如何查找文件以及根据内容搜索文件的方法。
接下来的章节将重点介绍针对特殊类型文件的自动化操作,例如Word、Excel和PPT文件。尽管这些文件类型较为特殊,但它们在实际工作场景中极为常见且使用频繁。
现在,让我们正式进入Word文件自动化操作的学习阶段。
本章涉及的新模块
python-docx
pdfkit
pydocx
利用Python批量读取文件
Word处理利器:python-docx
python-docx是一个用于创建和修改微软Word文档的Python库,提供了完整的Word操作功能,是目前最常用的Word处理工具之一。
在使用该库之前,需要理解以下几个核心概念:
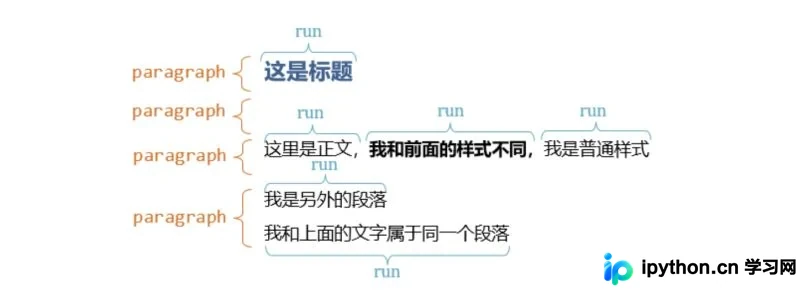
- Document:代表一个Word文档对象。与VBA中的Worksheet不同,Document是独立的,打开不同的Word文档会生成不同的Document对象,它们之间互不影响。
- Paragraph:代表段落。一个Word文档由多个段落组成。在文档中输入回车键会创建新段落,而Shift+回车则不会分段。
- Run:表示节段。每个段落由多个Run组成,具有相同样式的连续文本构成一个Run,因此一个Paragraph对象包含一个Run列表。
如下图所示的Word文档结构示意图:
Word文档的结构划分如下所示:
python-docx安装指南
安装步骤如下:
使用pip安装python-docx。如果下载速度较慢,可以更换为国内镜像源(如下所示):
pip install -i https://pypi.tuna.tsinghua.edu.cn/simple python-docx
导入模块的方法:
import docx from docx import …
python-docx中的Document对象详解
导入包与模块的具体方式:
from docx import Document具体使用方法如下:
Document(word文件地址)
返回值说明:
返回Word文件对象
python-docx:读取段落内容
要读取Word文档,核心在于提取段落和表格内容。无论是段落还是表格,其内部数据均为字符串,我们的目标就是读取这些字符串内容。
首先介绍段落内容的读取方式:
数据来源说明:
document_obj.paragraphs:通过Document对象的paragraphs属性返回段落列表;如果Word文件包含多个段落,则会生成多个段落对象。
使用方法:
通过循环遍历每个段落对象,并调用其text属性获取文本。
演示案例脚本如下:
# coding:utf-8

import os
from docx import Document

path = os.path.join(os.getcwd(), 'test_file/文本.docx')
print("\'文本.docx\' 的路径为:", path)     # 调试路径

doc = Document(path)

for p in doc.paragraphs:
    print(p.text)
运行结果如下:(注:此处文本仅为演示用途,本人并非培训机构!)
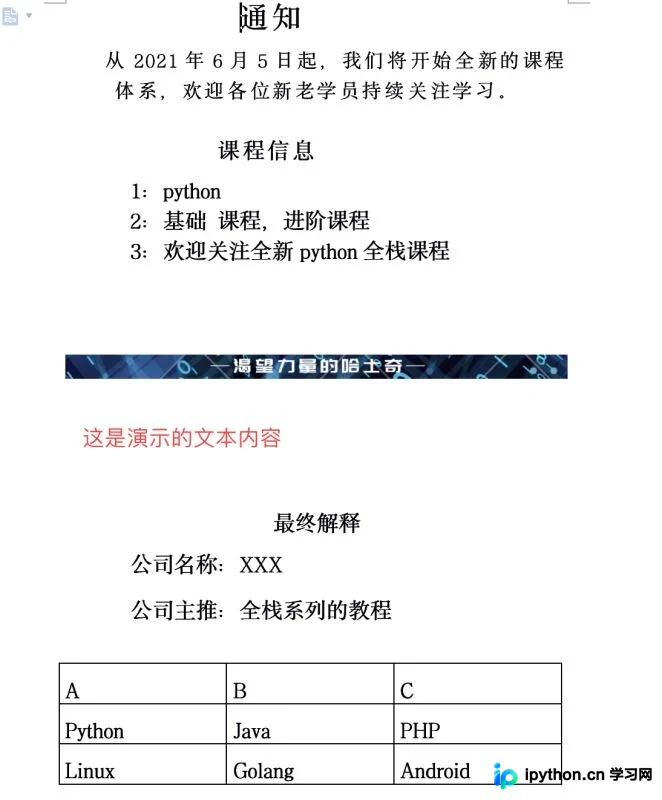
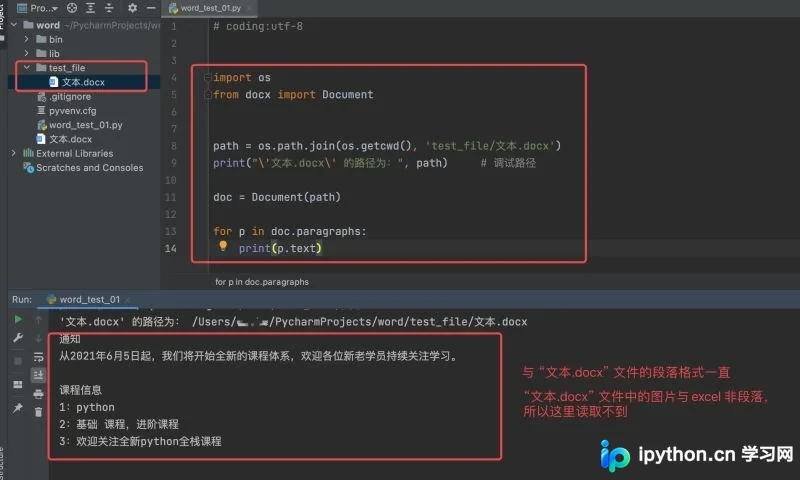
python-docx:读取表格内容
接下来介绍如何读取Word文件中的表格内容:
数据来源说明:
document_obj.tables:通过Document对象的tables属性返回表格列表,其中包含各个表格对象。
使用方法:
同样通过循环遍历,获取行与列的具体内容。
返回值说明:
每个表格字段(字符串)
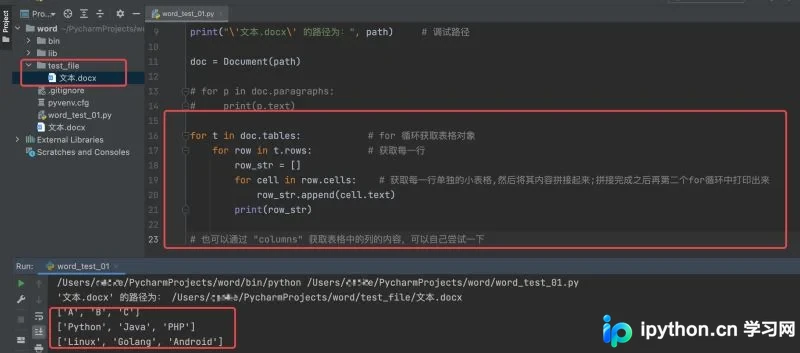
演示案例代码如下:
# coding:utf-8

import os
from docx import Document

path = os.path.join(os.getcwd(), 'test_file/文本.docx')
print("\'文本.docx\' 的路径为:", path)     # 调试路径

doc = Document(path)

# for p in doc.paragraphs:
#     print(p.text)

for t in doc.tables:            # for 循环获取表格对象
    for row in t.rows:          # 获取每一行
        row_str = []
        for cell in row.cells:    # 获取每一行单独的小表格,然后将其内容拼接起来;拼接完成之后再第二个for循环中打印出来
            row_str.append(cell.text)
        print(row_str)

# 也可以通过 "columns" 获取表格中的列的内容,可以自己尝试一下
运行结果如下:
至此,关于Python自动化办公中Word文件内容读取的介绍就到这里。如需了解更多Python读取Word内容的相关信息,请搜索本站历史文章或继续浏览后续相关文章,希望大家今后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















