


Python读取XML节点与属性值实战:解析ElementTree用法

发布时间:2026-10-15 |
6人浏览过
本文通过Python面试题案例,演示如何使用xml.etree.ElementTree模块读取XML文件。重点讲解parse函数加载文档及iterfind方法遍历子节点,结合findtext与get方法获取节点文本及属性值,实现数据的高效提取与分析。
面试题
假设存在一个名为test.xml的文件,任务要求提取该文件中products节点下所有子节点的文本内容,同时获取这些子节点对应的属性值。
test.xml文件内容如下:
<!-- products.xml -->
<root>
    <products>
        <product uuid='1234'>
            <id>10000</id>
            <name>苹果</name>
            <price>99999</price>
        </product>
        <product uuid='1235'>
            <id>10001</id>
            <name>小米</name>
            <price>999</price>
        </product>
        <product uuid='1236'>
            <id>10002</id>
            <name>华为</name>
            <price>9999</price>
        </product>
    </products>
</root>
解析思路
# coding=utf-8
from xml.etree.ElementTree import parse
doc = parse('./products.xml')
print(type(doc))

for item in doc.iterfind('products/product'):
    id = item.findtext('id')
    name = item.findtext('name')
    price = item.findtext('price')
    uuid = item.get('uuid')
    print('uuid={}, id={}, name={}, price={}'.format(uuid, id, name, price), end='\n----------\n')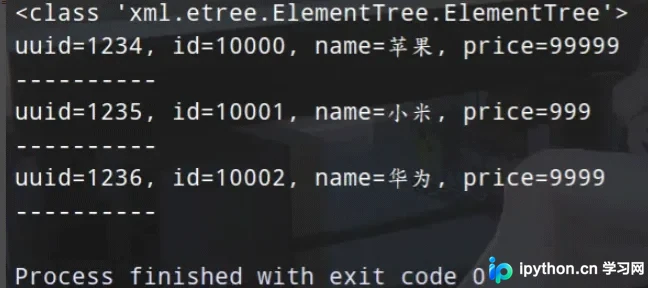
- 利用parse函数可加载XML文档,该函数返回一个ElementTree类型的对象。借助该对象的iterfind方法,能够对XML中指定的节点路径进行迭代遍历。
- XML结构具有高度灵活性,便于在各类应用程序中读写数据,因此它迅速成为数据交换的通用标准语言。尽管其他软件支持多种数据交换格式,但这并不妨碍支持XML的应用程序轻松与Windows、Linux或其他平台产生的信息进行整合。程序可以方便地将XML数据加载至内存中进行解析,最终以XML格式输出处理结果。
- 值得注意的是,这种数据格式与我们在爬虫抓取数据时遇到的未经处理的原始数据格式极为相似,甚至读取操作的逻辑也几乎一致。感兴趣的朋友可以进一步查阅这两种数据格式的背景资料以加深理解。
以上就是关于Python读取XML节点及属性值方法的详细介绍,更多Python XML处理相关内容可搜索本站历史文章或继续阅读后续教程,感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















