


Python pdfplumber库批量提取PDF表格数据转换为Excel

发布时间:2026-10-16 |
6人浏览过
本文介绍如何利用Python的pdfplumber库实现PDF文件中表格数据的批量提取并转换为Excel格式。通过示例代码演示了从单文件到多文件夹的处理流程,解决了WPS付费及手动操作耗时的问题,提供高效的数据处理方案。
需求
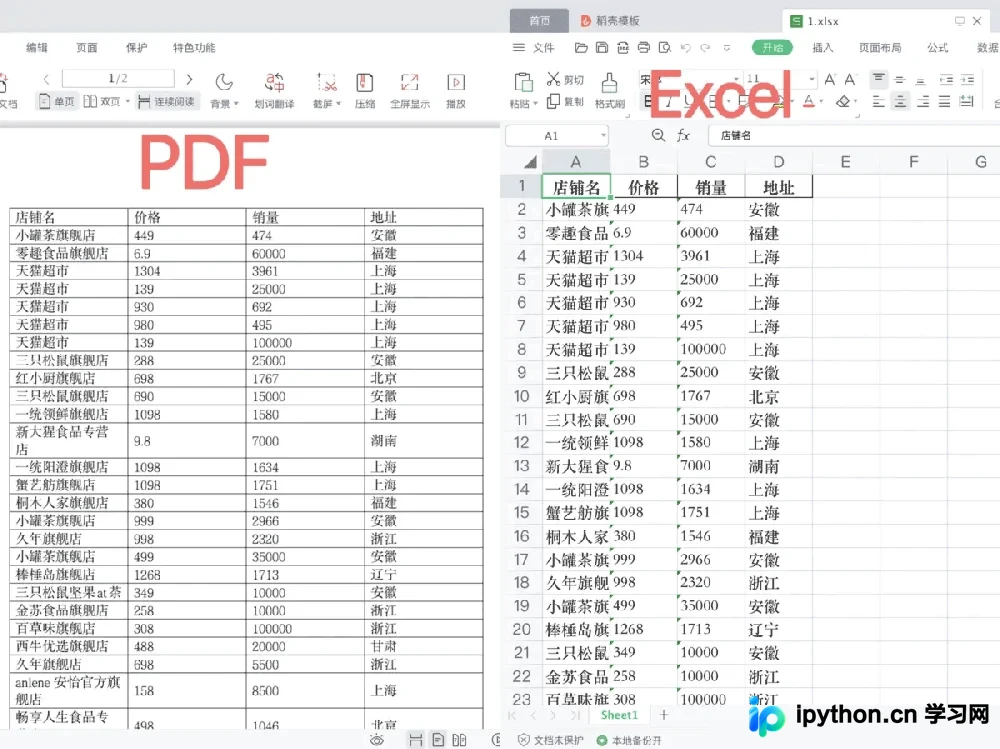
需要将PDF中的数据提取并保存至Excel。尽管WPS支持将PDF直接输出为Excel,但该功能收费,且在处理大量PDF文件时,手动操作极为耗时。借助Python第三方库pdfplumber,可快速实现此功能。
一、实现效果图
二、pdfplumber库介绍
pdfplumber是一款开源Python工具库,可便捷获取PDF的各类信息,包括文本、表格、图表及尺寸等。本文主要利用该库提取PDF中的表格数据以完成需求。
安装命令
pip install pdfplumber
三、代码实现
1、导入相关包
import pdfplumber
import pandas as pd
2、读取PDF并获取页数
pdf = pdfplumber.open("/Users/wangwangyuqing/Desktop/1.pdf")
pages = pdf.pages
3、提取单个PDF文件并保存为Excel
if len(pages) > 1:
    tables = []
    for each in pages:
        table = each.extract_table()
        tables.extend(table)
else:
    tables = each.extract_table()
data = pd.DataFrame(tables[1:], columns=tables[0])
data
data.to_excel("/Users/wangwangyuqing/Desktop/1.xlsx", index=False)
4、提取文件夹下多个PDF文件并保存为Excel
import os
import glob
path = r'/Users/wangwangyuqing/Desktop/pdf文件'
for f in glob.glob(os.path.join(path, "*.pdf")):
    res = save_pdf_to_excel(f)
    print(res)
def save_pdf_to_excel(path):
    #     print('文件名为:',path.split('/')[-1].split('.')[0] + '.xlsx')
    pdf = pdfplumber.open(path)
    pages = pdf.pages
    if len(pages) > 1:
        tables = []
        for each in pages:
            table = each.extract_table()
            tables.extend(table)
    else:
        tables = each.extract_table()
    data = pd.DataFrame(tables[1:], columns=tables[0])
    file_name = path.split('/')[-1].split('.')[0] + '.xlsx'
    data.to_excel("/Users/wangwangyuqing/Desktop/data/{}".format(file_name), index=False)
    return '保存成功!'
小结
Python中还有PyPDF2、pdfminer等库可处理PDF,本文选择pdfplumber的原因在于其能轻松访问PDF的详细信息(如作者、来源、日期等),且提取文本和表格的方法灵活可定制。用户可根据具体数据需求,进一步探索pdfplumber的其他用法。
以上就是Python pdfplumber库批量提取PDF表格数据转换为Excel的详细内容,更多关于Python pdfplumber库PDF转换Excel的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















