


Python实现自变量选择:所有子集回归、后退法与逐步回归详解

本文详细介绍在Python中如何进行回归模型的自变量选择,旨在构建少而精的模型以降低预测方差。重点解析所有子集回归、后退法及逐步回归三种算法的核心思想,并提供基于statsmodels库的完整代码实现与结果分析,帮助开发者掌握最优子集筛选技巧。
1、为什么需要自变量选择?
构建高质量的回归模型并非自变量数量越多越好。在建模过程中,选择自变量的核心原则是追求“少而精”。虽然剔除对因变量y有影响的自变量会导致估计量产生有偏性,但此举能显著降低预测偏差的方差。因此,科学地进行自变量选择具有重要的实际意义。
2、自变量选择的几个准则
(1)自由度调整复决定系数达到最大
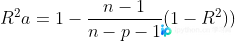
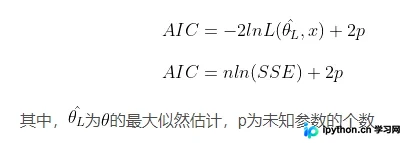
(2)赤池信息量AIC达到最小
3、所有子集回归
(1)算法思想
所有子集回归的核心思路是遍历所有可能的自变量子集,通过评估每个子集的表现,从而找出最优的变量组合解。
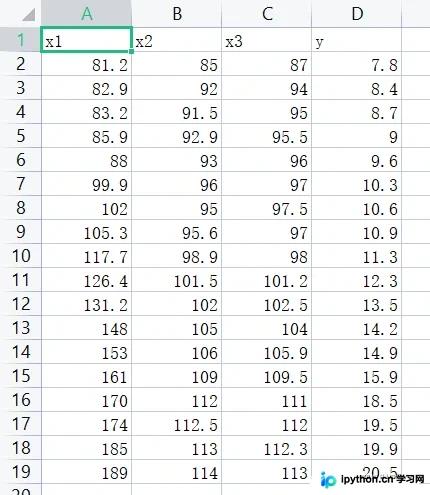
(2)数据集情况
(3)代码部分
import pandas as pd
import numpy as np
import statsmodels.api as sm
import statsmodels.formula.api as smf
from itertools import combinations
def allziji(df):

    list1 = [1,2,3]
    n = 18
    R2 = []
    names = []
    #找到所有子集,并依次循环
    for a in range(len(list1)+1):
        for b in combinations(list1,a+1):
            p = len(list(b))

            data1 = pd.concat([df.iloc[:,i-1] for i in list(b) ],axis = 1)#结合所需因子

            name = "y~"+("+".join(data1.columns))#组成公式

            data = pd.concat([df['y'],data1],axis=1)#结合自变量和因变量

            result = smf.ols(name,data=data).fit()#建模
            #计算R2a
            r2 = (n-1)/(n-p-1)
            r2 = r2 * (1-result.rsquared**2)
            r2 = 1 - r2
            R2.append(r2)
            names.append(name)
    finall = {"公式":names,              "R2a":R2}
    data = pd.DataFrame(finall)
    print("""根据自由度调整复决定系数准则得到:
        最优子集回归模型为:{};
        其R2a值为:{}""".format(data.iloc[data['R2a'].argmax(),0],data.iloc[data['R2a'].argmax(),1]))
    result = smf.ols(name,data=df).fit()#建模
    print()
    print(result.summary())
df = pd.read_csv("data5.csv")
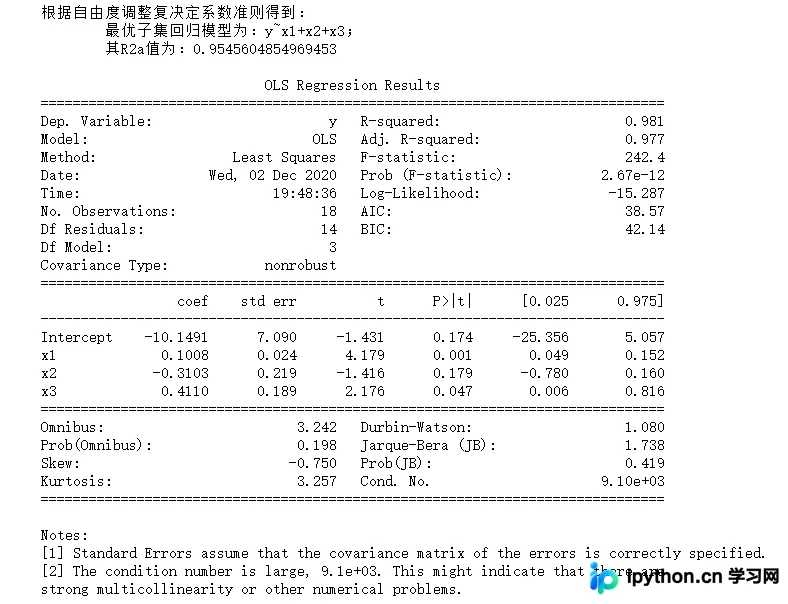
allziji(df)(4)输出结果
4、后退法
(1)算法思想
后退法与前进法逻辑相反。首先利用全部m个变量建立初始回归方程,随后依次计算剔除任意一个变量后回归方程对应的AIC统计量值,选取使AIC最小的变量(记为x1)进行剔除。接着,基于剩余的m-1个变量建立新回归方程,重复上述剔除过程,直至剩余p个变量中任意剔除一个都会导致AIC值增加为止。此时,包含这p个变量的回归方程即为最终确定的最优模型。
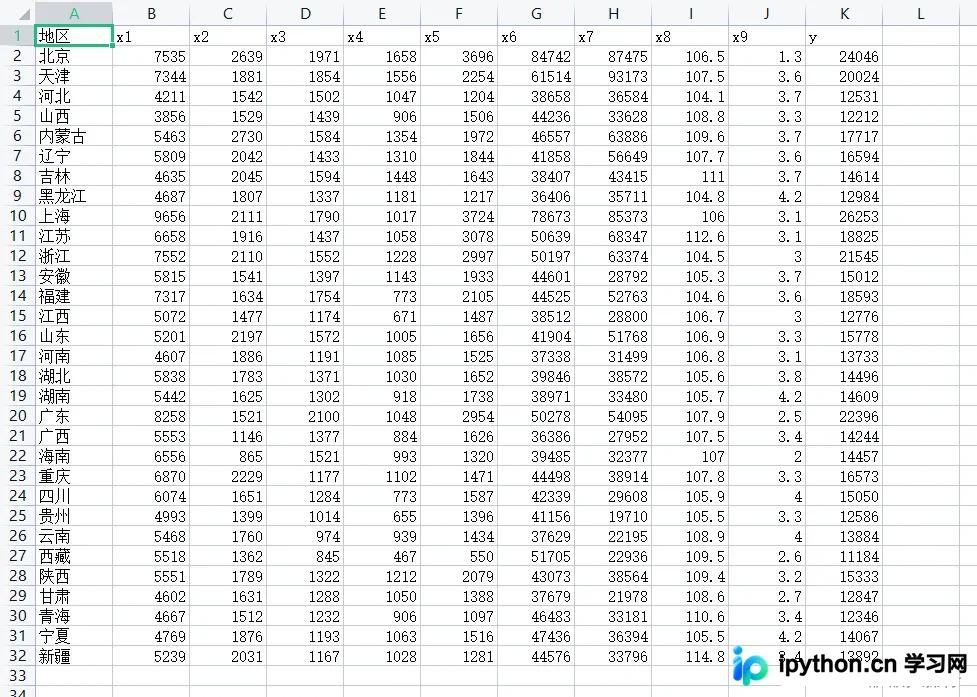
(2)数据集情况
(3)代码部分
import pandas as pd
import numpy as np
import statsmodels.api as sm
import statsmodels.formula.api as smf

def backward(df):
    all_bianliang = [i for i in range(0,9)]#备退因子
    ceshi = [i for i in range(0,9)]#存放加入单个因子后的模型
    zhengshi = [i for i in range(0,9)]#收集确定因子
    data1 = pd.concat([df.iloc[:,i+1] for i in ceshi ],axis = 1)#结合所需因子
    name = 'y~'+'+'.join(data1.columns)
    result = smf.ols(name,data=df).fit()#建模
    c0 = result.aic #最小aic
    delete = []#已删元素
    while(all_bianliang):
        aic = []#存放aic

        for i in all_bianliang:
            ceshi = [i for i in zhengshi]
            ceshi.remove(i)
            data1 = pd.concat([df.iloc[:,i+1] for i in ceshi ],axis = 1)#结合所需因子
            name = "y~"+("+".join(data1.columns))#组成公式
            data = pd.concat([df['y'],data1],axis=1)#结合自变量和因变量
            result = smf.ols(name,data=data).fit()#建模
            aic.append(result.aic)#将所有aic存入

        if min(aic)>c0:#aic已经达到最小
            data1 = pd.concat([df.iloc[:,i+1] for i in zhengshi ],axis = 1)#结合所需因子
            name = "y~"+("+".join(data1.columns))#组成公式
            break
        else:
            zhengshi.remove(all_bianliang[aic.index(min(aic))])#查找最小的aic并将最小的因子存入正式的模型列表当中

        c0 = min(aic)
        delete.append(aic.index(min(aic)))
        all_bianliang.remove(all_bianliang[delete[-1]])#删除已删因子

    name = "y~"+("+".join(data1.columns))#组成公式
    print("最优模型为:{},其aic为:{}".format(name,c0))
    result = smf.ols(name,data=df).fit()#建模
    print()
    print(result.summary())
df = pd.read_csv("data3.1.csv",encoding='gbk')
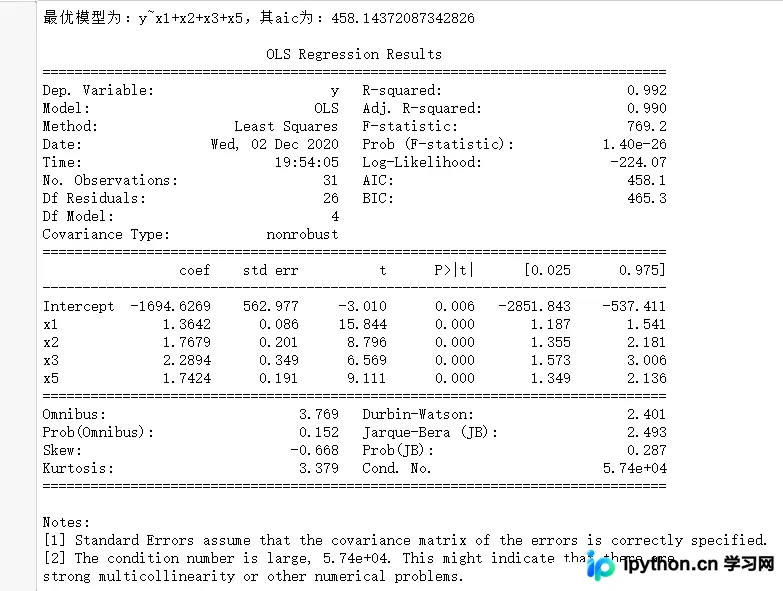
backward(df)(4)结果展示
5、逐步回归
(1)算法思想
逐步回归的基本思想是“有进有出”。以R语言中step()函数的逻辑为例,在给定包含p个变量的初始模型后,计算当前模型的AIC值。随后,分别计算剔除现有p个变量中的任意一个,以及添加剩余m-p个变量中任意一个后的AIC值。系统选择使AIC最小的操作(添加新变量或剔除旧变量)来更新模型。该过程反复迭代,直到既不添加新变量也不剔除现有变量时AIC值达到最小,此时停止计算并返回最终结果。
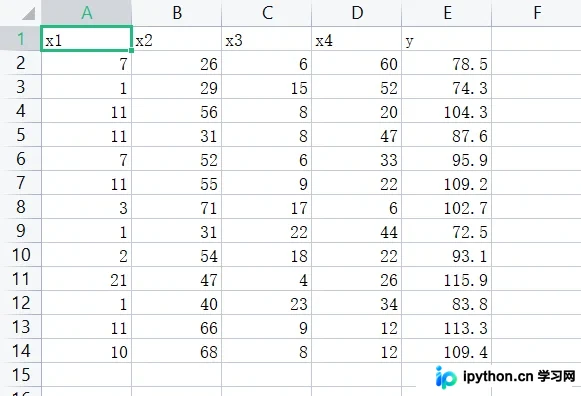
(2)数据集情况
(3)代码部分
import pandas as pd
import numpy as np
import statsmodels.api as sm
import statsmodels.formula.api as smf
def zhubuhuigui(df):
    forward = [i for i in range(0,4)]#备选因子
    backward = []#备退因子
    ceshi = []#存放加入单个因子后的模型
    zhengshi = []#收集确定因子
    delete = []#被删因子

    while forward:
        forward_aic = []#前进aic
        backward_aic = []#后退aic

        for i in forward:
            ceshi = [j for j in zhengshi]
            ceshi.append(i)
            data1 = pd.concat([df.iloc[:,i] for i in ceshi ],axis = 1)#结合所需因子
            name = "y~"+("+".join(data1.columns))#组成公式
            data = pd.concat([df['y'],data1],axis=1)#结合自变量和因变量
            result = smf.ols(name,data=data).fit()#建模
            forward_aic.append(result.aic)#将所有aic存入

        for i in backward:
            if (len(backward)==1):
                pass

            else:
                ceshi = [j for j in zhengshi]
                ceshi.remove(i)
                data1 = pd.concat([df.iloc[:,i] for i in ceshi ],axis = 1)#结合所需因子
                name = "y~"+("+".join(data1.columns))#组成公式
                data = pd.concat([df['y'],data1],axis=1)#结合自变量和因变量
                result = smf.ols(name,data=data).fit()#建模
                backward_aic.append(result.aic)#将所有aic存入

        if backward_aic:
            if forward_aic:
                c0 = min(min(backward_aic),min(forward_aic))

            else:
                c0 = min(backward_aic)

        else:
            c0 = min(forward_aic)

        if c0 in backward_aic:
            zhengshi.remove(backward[backward_aic.index(c0)])
            delete.append(backward_aic.index(c0))
            backward.remove(backward[delete[-1]])#删除已删因子
            forward.append(backward[delete[-1]])
        else:
            zhengshi.append(forward[forward_aic.index(c0)])#查找最小的aic并将最小的因子存入正式的模型列表当中
            forward.remove(zhengshi[-1])#删除已有因子
            backward.append(zhengshi[-1])

    name = "y~"+("+".join(data1.columns))#组成公式
    print("最优模型为:{},其aic为:{}".format(name,c0))
    result = smf.ols(name,data=data).fit()#建模
    print()
    print(result.summary())
df = pd.read_csv("data5.5.csv",encoding='gbk')
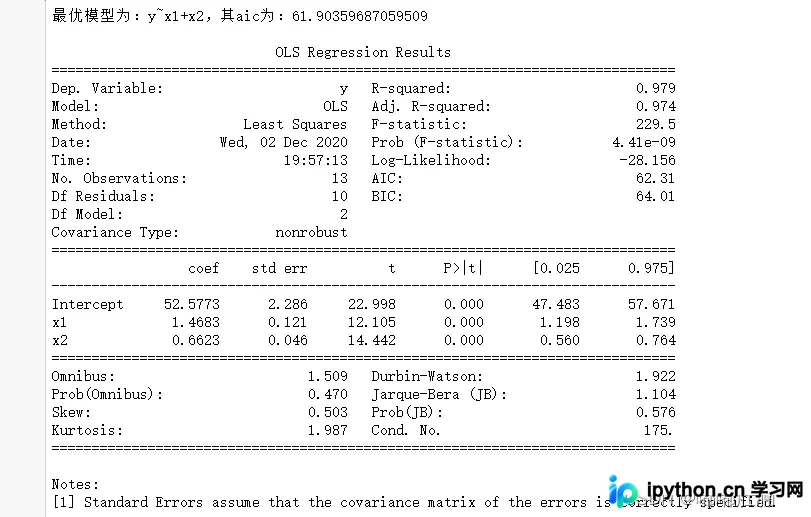
zhubuhuigui(df)(4)结果展示
到此这篇关于python的自变量选择(所有子集回归,后退法,逐步回归)的文章就介绍到这了,更多相关python自变量选择内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















