


Python办公自动化:批量将Word表格数据提取至Excel

本文介绍如何利用Python脚本批量处理Word文档中的表格数据,自动提取日期、标题和文号等关键信息并导出为标准格式的Excel文件。通过解析docx表格结构、处理日期格式转换及异常捕获,实现高效的数据整理,替代繁琐的手动复制操作,适用于公务员及行政办公场景。
前言
大家好,今天有一位从事公务员工作的小伙伴委托我协助处理一份Word文档(出于隐私考虑,文中具体内容已做脱敏处理)。
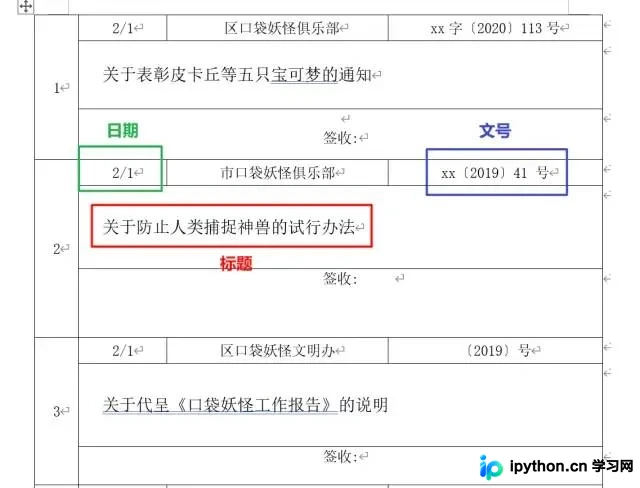
该文档包含近2600条格式相似的表格细栏,每个栏目涵盖以下信息:
- 日期
- 发文单位
- 文号
- 标题
- 签收栏
我们需要从中提取加粗显示的三项内容至Excel表格中,目标表格样式如下:
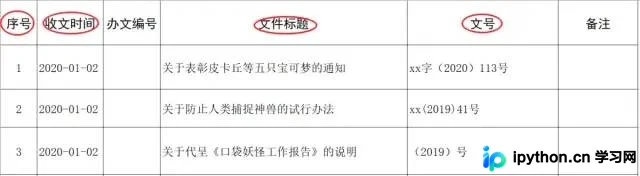
具体而言,需要将收文时间、文件标题和文号填入指定位置,并将时间统一转换为标准格式。若完全依靠手动复制并修改时间,按每条耗时10秒计算,每分钟可处理6条,则最快也需要约43分钟才能完成全部2600条数据的整理。
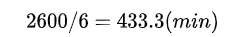
此类格式规整的文件整理任务非常适合使用Python自动化执行。接下来请出Python,关键代码部分已添加详细注释。
首先,使用Python导入Word文件。
# 导入需要的库docx
from docx import Document
# 指定文件存放的路径
path = r'C:\Users\word.docx'
# 读取文件
document = Document(path)
# 读取word中的所有表格
tables = document.tables
接着将问题拆解,首先尝试获取第一张表中第一个文件条目的三项所需信息。
# 获取第一张表
table0 = tables[0]
仔细观察可以发现,一个完整的文件条目占据表格的3行,因此在对表格所有行进行循环迭代时,可以设置步长为3。
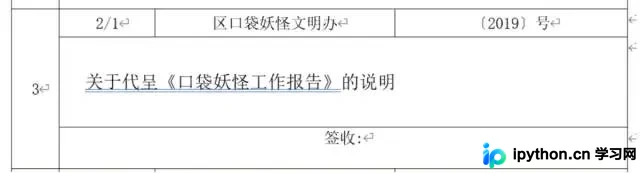
解析row和cell以提取所需内容。
注意观察表格结构,按照row和cell将所需内容解析清楚。
# 在全局放一个变量用来计数填序号
n = 0
for i in range(0, len(table0.rows) + 1, 3):
    # 日期
    date = table0.cell(i, 1).text
    # 标题
    title = table0.cell(i + 1, 1).text.strip()
    # 文号
    dfn = tables[j].cell(i, 3).text.strip()
    print(n, date, tite, dfn)
接下来需要解决的是,我们获取的时间格式为 2/1(日/月形式)。我们需要将其转化为 YYYY-MM-DD格式,这需要利用datetime包中的strptime和strftime函数:
strptime: 用于解析字符串中蕴含的时间信息。
strftime: 用于将解析后的时间转化为所需的标准格式。
import datetime
n = 0
for i in range(0, len(table0.rows) + 1, 3):
    # 日期
    date = table0.cell(i, 1).text
    # 有的条目时间是空的,这里不做过多判别
    if '/' in date:
        date = datetime.datetime.strptime(date, '%d/%m').strftime('2020-%m-%d')
    else:
        date = '-'
    # 标题
    title = table0.cell(i + 1, 1).text.strip()
    # 文号
    dfn = tables[j].cell(i, 3).text.strip()
    print(n, date, tite, dfn)
至此,单张表的内容解析即告完成。注意这里使用的是table[0],即第一张表;若要遍历所有表格,只需增加一个嵌套循环即可,此外还可以捕获异常以增加程序的灵活性。
n = 0
for j in range(len(tables)):
    for i in range(0, len(tables[j].rows)+1, 3):
        try:
            # 日期
            date = tables[j].cell(i, 1).text
            if '/' in date:
                date = datetime.datetime.strptime(date, '%d/%m').strftime('2020-%m-%d')
            else:
                date = '-'
            # 标题
            title = tables[j].cell(i + 1, 1).text.strip()
            # 文号
            dfn = tables[j].cell(i, 3).text.strip()
            n += 1
            print(n, date, title, dfn)
        except Exception as error:
            # 捕获异常,也可以用log写到日志里方便查看和管理
            print(error)
continue信息解析和获取完成后即可导出,用到的包是openpyxl。
from openpyxl import Workbook
# 实例化
wb = Workbook()
# 获取当前sheet
sheet = wb.active
# 设立表头
header = ['序号', '收文时间', '办文编号', '文件标题', '文号', '备注']
sheet.append(header)
内层解析循环逻辑。
在最内层解析循环的末尾添加如下代码即可将数据写入Excel。
row = [n, date, ' ', title, dfn, ' ']
sheet.append(row)
程序运行最后记得保存文件。
wb.save(r'C:\Users\20200420.xlsx')运行时间约为10分钟左右,期间可以暂时离开,程序执行结束后会自动完成。
最后附上完整代码,代码逻辑简单,理清思路是关键。
from docx import Document
import datetime
from openpyxl import Workbook
wb = Workbook()
sheet = wb.active
header = ['序号', '收文时间', '办文编号', '文件标题', '文号', '备注']
sheet.append(header)
path = r'C:\Users\word.docx'
document = Document(path)
tables = document.tables
n = 0
for j in range(len(tables)):
    for i in range(0, len(tables[j].rows)+1, 3):
        try:
            # 日期
            date = tables[j].cell(i, 1).text
            if '/' in date:
                date = datetime.datetime.strptime(date, '%d/%m').strftime('2020-%m-%d')
            else:
                date = '-'
            # 标题
            title = tables[j].cell(i + 1, 1).text.strip()
            # 文号
            dfn = tables[j].cell(i, 3).text.strip()
            n += 1
            print(n, date, title, dfn)
            row = [n, date, ' ', title, dfn, ' ']
            sheet.append(row)
        except Exception as error:
            # 捕获异常,也可以用log写到日志里方便查看和管理
            print(error)
            continue
wb.save(r'C:\Users\20200420.xlsx')
以上就是Python办公自动化Word转Excel文件批量处理的详细内容,更多关于Python办公自动化Word转Excel的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















