


Python实现梯度下降求解逻辑回归详解

发布时间:2026-10-15 |
4人浏览过
本文详细解析如何使用Python通过梯度下降法求解逻辑回归模型。内容涵盖线性回归与逻辑回归的对比、Sigmoid函数应用、似然函数推导、目标函数构建及梯度计算。提供完整的Python代码实现,包括Sigmoid预测、损失计算、梯度更新及停止策略,并分析逻辑回归的优缺点。
本文分享使用Python实现梯度下降求解逻辑回归的具体代码,供读者参考学习。
为理解逻辑回归,需先对比线性回归,主要涉及回归函数、似然函数、梯度下降求解方法及其代码实现。
线性回归基础
线性回归函数定义
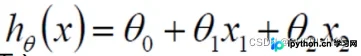
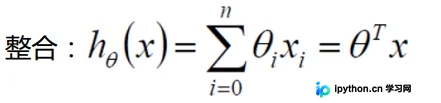
似然函数定义为:在给定联合样本值X下,关于未知参数
的函数。
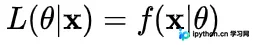
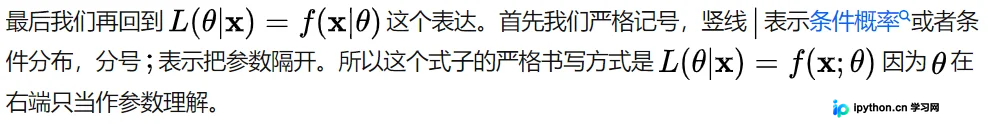
其核心思想是寻找一组参数,使得该参数与数据组合后能恰好还原为真实值。
线性回归似然函数推导
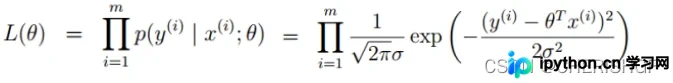
对数似然函数表达式如下:
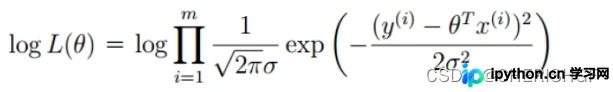
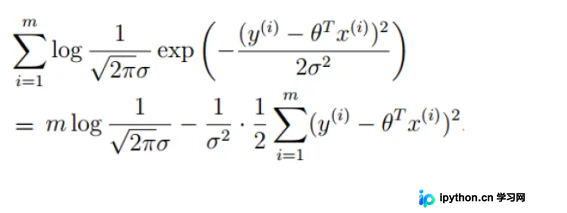
线性回归目标函数构建
目标函数为误差表达式,旨在使真实值与预测值之间的误差最小化。
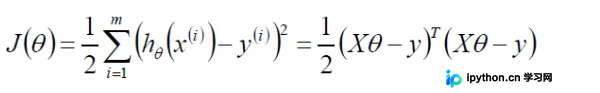
通过令导数为0取得极值,从而解得函数的最优参数。
逻辑回归核心原理
逻辑回归是在线性回归结果的基础上,叠加一层Sigmoid函数进行非线性映射。
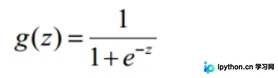
逻辑回归函数定义
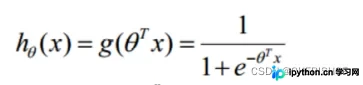
逻辑回归似然函数推导
前提假设:数据服从伯努利分布。
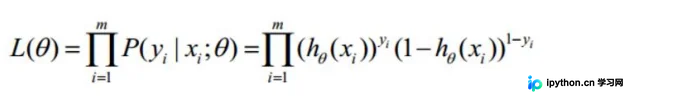
对数似然函数表达式如下:
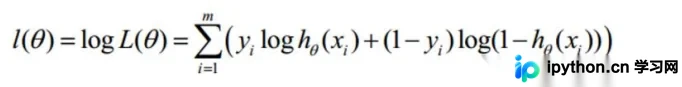
引入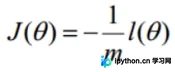 将问题转化为梯度下降任务,由此构建逻辑回归目标函数。
梯度下降法求解过程
该方法的核心是求导并更新参数,当满足特定停止条件后终止迭代,从而获得近似最优解。
代码实现细节
Sigmoid函数实现
def sigmoid(z):
return 1 / (1 + np.exp(-z))预测函数用于计算样本属于正类的概率。
def model(X, theta):
    return sigmoid(np.dot(X, theta.T))
目标函数(损失函数)计算逻辑
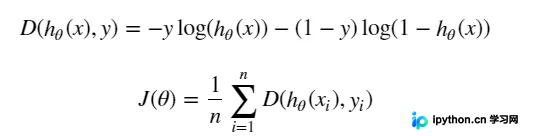
def cost(X, y, theta):
left = np.multiply(-y, np.log(model(X, theta)))
right = np.multiply(1 - y, np.log(1 - model(X, theta)))
return np.sum(left - right) / (len(X))梯度计算方法
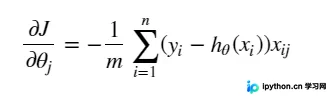
def gradient(X, y, theta):
grad = np.zeros(theta.shape)
error = (model(X, theta)- y).ravel()
for j in range(len(theta.ravel())): #for each parmeter
term = np.multiply(error, X[:,j])
grad[0, j] = np.sum(term) / len(X)
return grad梯度下降的停止策略设定
STOP_ITER = 0
STOP_COST = 1
STOP_GRAD = 2

def stopCriterion(type, value, threshold):
    # 设定三种不同的停止策略
    if type == STOP_ITER:  # 设定迭代次数
        return value > threshold
    elif type == STOP_COST:  # 根据损失值停止
        return abs(value[-1] - value[-2]) < threshold
    elif type == STOP_GRAD:  # 根据梯度变化停止
        return np.linalg.norm(value) < threshold
样本数据的随机洗牌机制
import numpy.random
#洗牌
def shuffleData(data):
    np.random.shuffle(data)
    cols = data.shape[1]
    X = data[:, 0:cols-1]
    y = data[:, cols-1:]
    return X, y
梯度下降求解主流程
def descent(data, theta, batchSize, stopType, thresh, alpha):
    # 梯度下降求解

    init_time = time.time()
    i = 0  # 迭代次数
    k = 0  # batch
    X, y = shuffleData(data)
    grad = np.zeros(theta.shape)  # 计算的梯度
    costs = [cost(X, y, theta)]  # 损失值

    while True:
        grad = gradient(X[k:k + batchSize], y[k:k + batchSize], theta)
        k += batchSize  # 取batch数量个数据
        if k >= n:
            k = 0
            X, y = shuffleData(data)  # 重新洗牌
        theta = theta - alpha * grad  # 参数更新
        costs.append(cost(X, y, theta))  # 计算新的损失
        i += 1

        if stopType == STOP_ITER:
            value = i
        elif stopType == STOP_COST:
            value = costs
        elif stopType == STOP_GRAD:
            value = grad
        if stopCriterion(stopType, value, thresh): break

    return theta, i - 1, costs, grad, time.time() - init_time
完整代码展示
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import os
import numpy.random
import time


def sigmoid(z):
    return 1 / (1 + np.exp(-z))


def model(X, theta):
    return sigmoid(np.dot(X, theta.T))


def cost(X, y, theta):
    left = np.multiply(-y, np.log(model(X, theta)))
    right = np.multiply(1 - y, np.log(1 - model(X, theta)))
    return np.sum(left - right) / (len(X))


def gradient(X, y, theta):
    grad = np.zeros(theta.shape)
    error = (model(X, theta) - y).ravel()
    for j in range(len(theta.ravel())):  # for each parmeter
        term = np.multiply(error, X[:, j])
        grad[0, j] = np.sum(term) / len(X)
    return grad


STOP_ITER = 0
STOP_COST = 1
STOP_GRAD = 2


def stopCriterion(type, value, threshold):
    # 设定三种不同的停止策略
    if type == STOP_ITER:  # 设定迭代次数
        return value > threshold
    elif type == STOP_COST:  # 根据损失值停止
        return abs(value[-1] - value[-2]) < threshold
    elif type == STOP_GRAD:  # 根据梯度变化停止
        return np.linalg.norm(value) < threshold


# 洗牌
def shuffleData(data):
    np.random.shuffle(data)
    cols = data.shape[1]
    X = data[:, 0:cols - 1]
    y = data[:, cols - 1:]
    return X, y


def descent(data, theta, batchSize, stopType, thresh, alpha):
    # 梯度下降求解

    init_time = time.time()
    i = 0  # 迭代次数
    k = 0  # batch
    X, y = shuffleData(data)
    grad = np.zeros(theta.shape)  # 计算的梯度
    costs = [cost(X, y, theta)]  # 损失值

    while True:
        grad = gradient(X[k:k + batchSize], y[k:k + batchSize], theta)
        k += batchSize  # 取batch数量个数据
        if k >= n:
            k = 0
            X, y = shuffleData(data)  # 重新洗牌
        theta = theta - alpha * grad  # 参数更新
        costs.append(cost(X, y, theta))  # 计算新的损失
        i += 1

        if stopType == STOP_ITER:
            value = i
        elif stopType == STOP_COST:
            value = costs
        elif stopType == STOP_GRAD:
            value = grad
        if stopCriterion(stopType, value, thresh): break

    return theta, i - 1, costs, grad, time.time() - init_time


def runExpe(data, theta, batchSize, stopType, thresh, alpha):
    # import pdb
    # pdb.set_trace()
    theta, iter, costs, grad, dur = descent(data, theta, batchSize, stopType, thresh, alpha)
    name = "Original" if (data[:, 1] > 2).sum() > 1 else "Scaled"
    name += " data - learning rate: {} - ".format(alpha)
    if batchSize == n:
        strDescType = "Gradient"  # 批量梯度下降
    elif batchSize == 1:
        strDescType = "Stochastic"  # 随机梯度下降
    else:
        strDescType = "Mini-batch ({})".format(batchSize)  # 小批量梯度下降
    name += strDescType + " descent - Stop: "
    if stopType == STOP_ITER:
        strStop = "{} iterations".format(thresh)
    elif stopType == STOP_COST:
        strStop = "costs change < {}".format(thresh)
    else:
        strStop = "gradient norm < {}".format(thresh)
    name += strStop
    print("***{}\nTheta: {} - Iter: {} - Last cost: {:03.2f} - Duration: {:03.2f}s".format(
        name, theta, iter, costs[-1], dur))
    fig, ax = plt.subplots(figsize=(12, 4))
    ax.plot(np.arange(len(costs)), costs, 'r')
    ax.set_xlabel('Iterations')
    ax.set_ylabel('Cost')
    ax.set_title(name.upper() + ' - Error vs. Iteration')
    return theta


path = 'data' + os.sep + 'LogiReg_data.txt'
pdData = pd.read_csv(path, header=None, names=['Exam 1', 'Exam 2', 'Admitted'])
positive = pdData[pdData['Admitted'] == 1]
negative = pdData[pdData['Admitted'] == 0]

# 画图观察样本情况
fig, ax = plt.subplots(figsize=(10, 5))
ax.scatter(positive['Exam 1'], positive['Exam 2'], s=30, c='b', marker='o', label='Admitted')
ax.scatter(negative['Exam 1'], negative['Exam 2'], s=30, c='r', marker='x', label='Not Admitted')
ax.legend()
ax.set_xlabel('Exam 1 Score')
ax.set_ylabel('Exam 2 Score')

pdData.insert(0, 'Ones', 1)

# 划分训练数据与标签
orig_data = pdData.values
cols = orig_data.shape[1]
X = orig_data[:, 0:cols - 1]
y = orig_data[:, cols - 1:cols]
# 设置初始参数0
theta = np.zeros([1, 3])

# 选择的梯度下降方法是基于所有样本的
n = 100
runExpe(orig_data, theta, n, STOP_ITER, thresh=5000, alpha=0.000001)
runExpe(orig_data, theta, n, STOP_COST, thresh=0.000001, alpha=0.001)
runExpe(orig_data, theta, n, STOP_GRAD, thresh=0.05, alpha=0.001)
runExpe(orig_data, theta, 1, STOP_ITER, thresh=5000, alpha=0.001)
runExpe(orig_data, theta, 1, STOP_ITER, thresh=15000, alpha=0.000002)
runExpe(orig_data, theta, 16, STOP_ITER, thresh=15000, alpha=0.001)

from sklearn import preprocessing as pp

# 数据预处理
scaled_data = orig_data.copy()
scaled_data[:, 1:3] = pp.scale(orig_data[:, 1:3])

runExpe(scaled_data, theta, n, STOP_ITER, thresh=5000, alpha=0.001)
runExpe(scaled_data, theta, n, STOP_GRAD, thresh=0.02, alpha=0.001)
theta = runExpe(scaled_data, theta, 1, STOP_GRAD, thresh=0.002 / 5, alpha=0.001)
runExpe(scaled_data, theta, 16, STOP_GRAD, thresh=0.002 * 2, alpha=0.001)


# 设定阈值
def predict(X, theta):
    return [1 if x >= 0.5 else 0 for x in model(X, theta)]


# 计算精度
scaled_X = scaled_data[:, :3]
y = scaled_data[:, 3]
predictions = predict(scaled_X, theta)
correct = [1 if ((a == 1 and b == 1) or (a == 0 and b == 0)) else 0 for (a, b) in zip(predictions, y)]
accuracy = (sum(map(int, correct)) % len(correct))
print('accuracy = {0}%'.format(accuracy))
逻辑回归优缺点分析
优点分析
- 模型形式简单,可解释性极强。通过特征权重可直接观察各特征对最终结果的影响程度,权重越高,影响越大。
- 工程效果良好,常作为基线模型(baseline)。若特征工程处理得当,效果不会差;且特征工程可并行开发,显著提升开发速度。
- 训练速度较快。分类计算量仅与特征数量相关。此外,随机梯度下降(SGD)的分布式优化技术成熟,可通过增加机器数量加速训练,从而快速迭代多个模型版本。
- 资源占用低,尤其是内存。仅需存储各维度的特征值即可。
- 结果调整灵活。逻辑回归输出的是每个样本的概率分数,便于通过设定阈值(Cutoff)进行分类划分(高于阈值为一类,低于为另一类)。
缺点分析
- 准确率通常不高。由于模型形式简单(近似线性模型),难以拟合数据的真实复杂分布。
- 难以处理数据不平衡问题。例如正负样本比例为10000:1时,将所有样本预测为正类虽能使损失函数值较小,但作为分类器,其对正负样本的区分能力极差。
- 处理非线性数据较为困难。在不引入其他方法的情况下,逻辑回归仅能处理线性可分数据,或更准确地说,仅适用于二分类问题。
- 逻辑回归本身不具备特征筛选功能。实践中常结合GBDT(梯度提升决策树)进行特征筛选,再输入逻辑回归模型。
以上为本文全部内容,希望对读者学习有所帮助,欢迎支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















