


Python音频处理:从读取、写入到分帧与语谱图分析

本文详解Python音频处理的核心操作,涵盖WAV文件的读取与写入、多通道数据重塑、PyAudio实时播放以及基于scipy.signal的信号分帧与语谱图绘制。通过具体代码示例,展示如何处理声道参数、归一化数据及加窗处理,帮助开发者掌握音频信号分析的基础流程。
文件路径与基础配置
在Python中处理音频文件时,文件路径的表示方式直接影响代码的可读性与执行结果。推荐使用原始字符串(Raw String)或显式转义字符来避免路径解析错误。
path = './file/n'
path = r'.\file\n'
path = '.\\file\\'
若需进一步了解字符串处理方法,可查阅 str.replace 等内置函数的文档。
WAV文件读取与参数解析
Python标准库 wave 提供了处理WAV文件的基础接口。使用 wave.open(file, mode) 打开文件,其中 mode 参数决定了操作权限:'rb' 用于读取,'wb' 用于写入。需注意,该模块不支持同时进行的读写操作。
获取音频元数据
打开文件后,通过 getparams() 方法可获取音频的关键参数,包括声道数(nchannels)、量化位数(sampwidth,单位为字节)、采样频率(framerate)和采样点数(nframes)。
import wave
import numpy as np
import matplotlib.pyplot as plt
import os

filepath = "./data/"
filename = os.listdir(filepath)
f = wave.open(filepath+filename[1], 'rb')

params = f.getparams()
nchannels, sampwidth, framerate, nframes = params[:4]

# 读取音频数据并转换为整数数组
strData = f.readframes(nframes)
waveData = np.fromstring(strData, dtype=np.int16)

# 幅值归一化
waveData = waveData * 1.0 / (max(abs(waveData)))

# 绘制单通道波形
time = np.arange(0, nframes) * (1.0 / framerate)
plt.plot(time, waveData)
plt.xlabel("Time(s)")
plt.ylabel("Amplitude")
plt.title("Single channel wavedata")
plt.grid('on')
plt.show()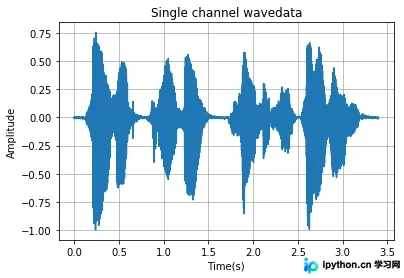
多通道数据处理
对于多通道音频,readframes 返回的是一维数据流。为了按声道分离数据,需使用 np.reshape 将其重塑为二维数组,形状为 [nframes, nchannels]。重塑后,waveData[:, 0] 对应第一个声道,以此类推。若数据原本为单通道,此操作仍适用,因为单通道可视作多通道的特例。
# 多通道读取示例
waveData = np.reshape(waveData, [nframes, nchannels])
f.close()

# 绘制多通道波形
time = np.arange(0, nframes) * (1.0 / framerate)
plt.figure()
plt.subplot(5, 1, 1)
plt.plot(time, waveData[:, 0])
plt.xlabel("Time(s)")
plt.ylabel("Amplitude")
plt.title("Ch-1 wavedata")
plt.grid('on')

plt.subplot(5, 1, 3)
plt.plot(time, waveData[:, 1])
plt.xlabel("Time(s)")
plt.ylabel("Amplitude")
plt.title("Ch-2 wavedata")
plt.grid('on')

plt.subplot(5, 1, 5)
plt.plot(time, waveData[:, 2])
plt.xlabel("Time(s)")
plt.ylabel("Amplitude")
plt.title("Ch-3 wavedata")
plt.grid('on')
plt.show()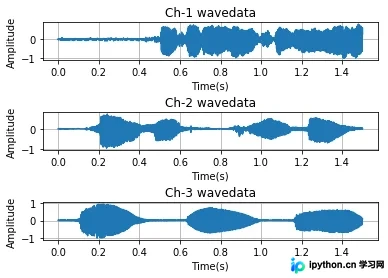
WAV文件写入操作
写入WAV文件涉及三个关键步骤:设置参数、指定路径及写入数据。对于多通道数据,写入前需将二维数据重塑回一维,这是读取时重塑的逆过程。
单通道写入示例
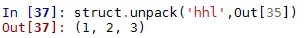
在写入前,需通过 setparams 设置声道数、量化位数、采样率等参数。数据写入时使用 struct.pack 将浮点型数据转换为二进制格式(如 'h' 表示16位整数)。
import struct

# 参数设置
nchannels = 1
sampwidth = 2
fs = 8000
data_size = len(outData)
framerate = int(fs)
nframes = data_size
comptype = "NONE"
compname = "not compressed"

# 打开文件并设置参数
outfile = filepath + 'out1.wav'
outwave = wave.open(outfile, 'wb')
outwave.setparams((nchannels, sampwidth, framerate, nframes, comptype, compname))

# 写入数据
for v in outData:
    # 注意数据范围,避免溢出
    outwave.writeframes(struct.pack('h', int(v * 64000 / 2)))

outwave.close()
多通道写入示例
多通道写入时,需先将二维数据 [nframes, nchannels] 重塑为一维 [nframes * nchannels, 1],再按上述方式写入。
# 多通道写入完整示例
import wave
import numpy as np
import os
import struct

filepath = "./data/"
filename = os.listdir(filepath)
f = wave.open(filepath+filename[0], 'rb')
params = f.getparams()
nchannels, sampwidth, framerate, nframes = params[:4]
strData = f.readframes(nframes)
waveData = np.fromstring(strData, dtype=np.int16)
waveData = waveData * 1.0 / (max(abs(waveData)))
waveData = np.reshape(waveData, [nframes, nchannels])
f.close()

# 准备写入数据
outData = np.reshape(waveData, [nframes * nchannels, 1])
outfile = filepath + 'out2.wav'
outwave = wave.open(outfile, 'wb')

nchannels = 3
sampwidth = 2
fs = 8000
data_size = len(outData)
framerate = int(fs)
nframes = data_size
comptype = "NONE"
compname = "not compressed"
outwave.setparams((nchannels, sampwidth, framerate, nframes, comptype, compname))

for v in outData:
    outwave.writeframes(struct.pack('h', int(v * 64000 / 2)))
outwave.close()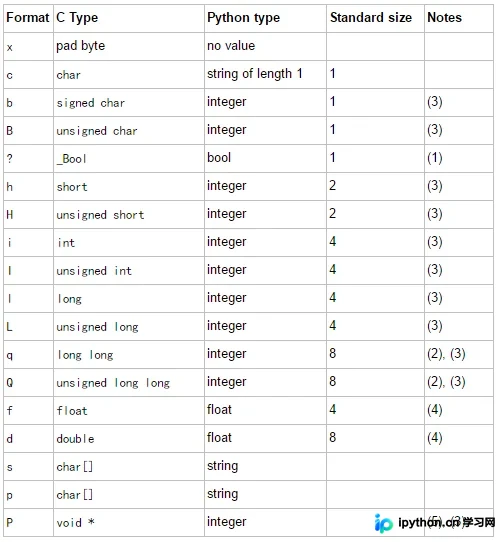
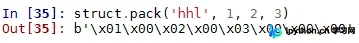
音频播放与PyAudio使用
使用 pyaudio 库可实现音频的实时播放。安装时,需将 .whl 文件置于 \Scripts 目录下,并通过命令行执行安装命令。
pip install PyAudio-0.2.9-cp35-none-win_amd64.whl播放流程包括实例化 PyAudio、配置流参数(采样率、声道数、量化格式)、读取数据块并写入输出流,最后关闭流与实例。
import wave
import pyaudio
import os

filepath = "./data/"
filename = os.listdir(filepath)
f = wave.open(filepath+filename[0], 'rb')
params = f.getparams()
nchannels, sampwidth, framerate, nframes = params[:4]

# 实例化 PyAudio
p = pyaudio.PyAudio()
chunk = 1024

# 打开声音输出流
stream = p.open(format=p.get_format_from_width(sampwidth),
                channels=nchannels,
                rate=framerate,
                output=True)

# 播放音频
data = f.readframes(chunk)
i = 1
while True:
    data = f.readframes(chunk)
    if data == b'':  # Python3.5中判断空字节需加b前缀
        break
    stream.write(data)

f.close()
stream.stop_stream()
stream.close()
p.terminate()
信号分帧与语谱图分析
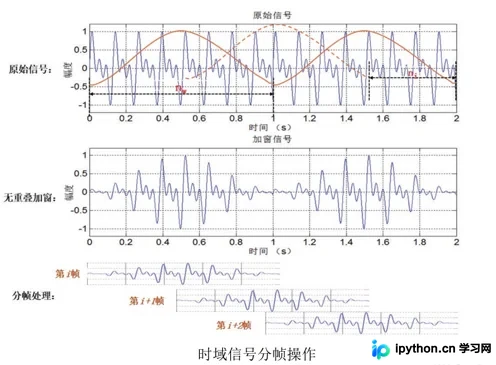
在语音信号处理中,常需对信号进行分帧和加窗处理,以减少频谱泄漏。Python的 scipy.signal 工具箱提供了多种窗函数,如 hamming 和 hanning。
分帧原理与实现
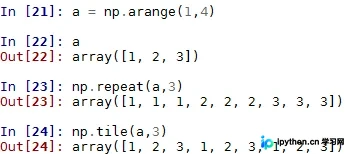
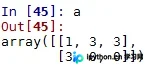
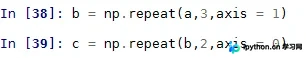
分帧是将长信号切割为短帧的过程,帧与帧之间通常存在帧移(inc)以平滑过渡。以下代码展示了如何实现分帧,包括补零和索引矩阵的构建。
import numpy as np
import wave
import os
import scipy.signal as signal

def enframe(signal, nw, inc):
    '''将音频信号转化为帧。
    signal:原始音频信号
    nw:每一帧的长度(采样点数)
    inc:相邻帧的间隔
    '''
    signal_length = len(signal)
    if signal_length <= nw:
        nf = 1
    else:
        nf = int(np.ceil((1.0 * signal_length - nw + inc) / inc))

    pad_length = int((nf - 1) * inc + nw)
    zeros = np.zeros((pad_length - signal_length,))
    pad_signal = np.concatenate((signal, zeros))

    indices = np.tile(np.arange(0, nw), (nf, 1)) + \
              np.tile(np.arange(0, nf * inc, inc), (nw, 1)).T
    indices = np.array(indices, dtype=np.int32)
    frames = pad_signal[indices]
    return frames

def wavread(filename):
    f = wave.open(filename, 'rb')
    params = f.getparams()
    nchannels, sampwidth, framerate, nframes = params[:4]
    strData = f.readframes(nframes)
    waveData = np.fromstring(strData, dtype=np.int16)
    f.close()
    waveData = waveData * 1.0 / (max(abs(waveData)))
    waveData = np.reshape(waveData, [nframes, nchannels]).T
    return waveData

filepath = "./data/"
dirname = os.listdir(filepath)
filename = filepath + dirname[0]
data = wavread(filename)
nw = 512
inc = 128
Frame = enframe(data[0], nw, inc)
加窗处理
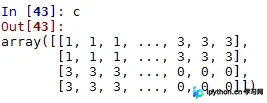
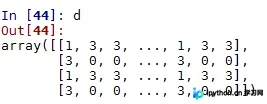
为减少频域能量泄露,分帧后需乘以窗函数。例如使用 hamming 窗:
def enframe(signal, nw, inc, winfunc):
    # ... (前文分帧逻辑相同) ...
    win = np.tile(winfunc, (nf, 1))
    return frames * win

winfunc = signal.hamming(nw)
Frame = enframe(data[0], nw, inc, winfunc)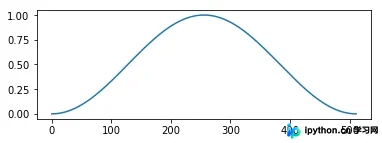
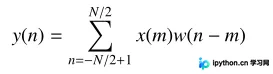
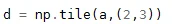
绘制语谱图
得到分帧信号后,可通过 matplotlib.pyplot.specgram 绘制语谱图,观察信号的频率随时间的变化。
import wave
import matplotlib.pyplot as plt
import numpy as np
import os

filepath = "./data/"
filename = os.listdir(filepath)
f = wave.open(filepath+filename[0], 'rb')
params = f.getparams()
nchannels, sampwidth, framerate, nframes = params[:4]
strData = f.readframes(nframes)
waveData = np.fromstring(strData, dtype=np.int16)
waveData = waveData * 1.0 / (max(abs(waveData)))
waveData = np.reshape(waveData, [nframes, nchannels]).T
f.close()

# 绘制语谱图
plt.specgram(waveData[0], Fs=framerate, scale_by_freq=True, sides='default')
plt.ylabel('Frequency(Hz)')
plt.xlabel('Time(s)')
plt.show()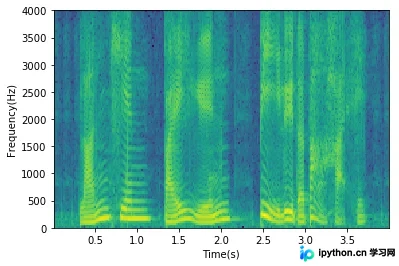
总结
本文系统介绍了Python中音频处理的关键技术,包括WAV文件的读写、多通道数据处理、PyAudio实时播放以及基于信号处理库的分帧与语谱图分析。掌握这些基础操作,可为更复杂的音频分析与处理任务奠定基础。
以上就是Python音频处理用到的操作的示例代码的详细内容,更多关于Python音频处理、wave模块、PyAudio及信号分帧的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















