


Python实现M3U8视频抓取与合并的完整流程

本文详细解析M3U8视频播放原理,介绍如何利用Python脚本抓取.m3u8索引文件及对应的.ts分片文件。通过requests库获取资源链接,结合os系统命令将多个小体积.ts文件合并为完整的mp4视频。文章提供具体操作步骤、代码示例及注意事项,适用于Windows环境下对特定网站视频资源的抓取与本地保存。
M3U8原理
在网页播放视频时,浏览器首先向服务器发起以.m3u8结尾的请求。服务器响应返回具体的.ts文件链接列表,浏览器随后向这些链接发起请求,获取.ts格式的视频资源。.ts文件与常见的.mp4文件主要区别在于封装格式不同,且.ts文件体积通常较小,例如本例中单个.ts文件仅包含约6秒的视频内容。最后,浏览器将这些分散的.ts文件按顺序整合并播放,从而实现视频流的连续播放。
脚本环境
运行环境为Python 3.8版本,操作系统为Windows 10。
爬取步骤
Python脚本需要执行以下核心任务:
1、筛选支持M3U8协议的视频网站;
2、定位并获取.m3u8索引文件的URL地址;
3、利用requests库发送GET请求,解析并获取.ts文件的实际下载链接;
4、编写逻辑下载所有的.ts分片文件至本地;
5、调用系统命令将下载的所有.ts文件合并,最终生成mp4格式的视频文件。
步骤的具体实现
演示使用的视频网站为:https://www.3s8m.com/。
2、在目标网站任意选择一个视频并进入播放页面。按下F12或Fn+F12键打开浏览器开发者工具,切换到“网络(Network)”标签页。刷新页面并暂停视频播放,在开发者工具的网络请求列表中筛选XHR类型(若无XHR选项,可直接在全部请求中搜索“m3u8”)。找到以.m3u8结尾的数据包,点击该请求以查看并复制其完整的URL地址。
3、使用Python编写代码,利用requests库向上述获取的URL发送GET请求,并打印服务器返回的数据内容。具体代码实现如下:
import requests
url = “用第二部找到的URL填入”
results = requests.get(url) #发送get请求
results.encoding=“utf8” #设置编码格式,从网页源码中的head中可以看编码格式,这步不关键
print(results.text) #打印结果
results.close() #关闭
4、从第3步打印的结果中可以发现包含多个URL地址,这些即为.ts分片文件的下载地址。接下来使用Python脚本遍历这些地址,逐一下载.ts文件。
import request
url =“填入获取到的ts文件的URL”
results = requests.get(url)
results.encoding =“utf8”
with open("./a.ts",“wb”) as file:
file.write(results.content)
results.close()
5、将所有下载的.ts文件合并为一个完整的视频。调用Python内置的os库,通过执行系统命令(如copy /b a.ts+b.ts a.mp4)将多个ts文件二进制合并,最终生成mp4格式的视频文件。
import os
os.system(“copy /b a.ts+b.ts a.mp4”)
Python细节处理说明
1、上述流程中.m3u8地址是通过浏览器手动查找获得的。若希望完全自动化,需使用Python对网页源码进行分析检索。可以使用正则表达式进行匹配,也可以采用xpath或bs4等解析库进行数据提取。
2、一个.m3u8索引文件通常对应多个.ts分片地址。在代码实现中,应将属于同一.m3u8索引的所有ts地址收集并保存,下载完成后统一整合,确保一个.m3u8源对应生成一个完整的视频文件。
3、浏览此类网站时,可能会发现部分资源存在不同的播放源,且某些播放源可能无法使用。因此,在检索过程中建议增加播放源切换或校验的逻辑,以确保获取有效的视频链接。
4、关于保存的文件名和存储路径,用户可根据实际需求自定义返回值。具体的完整代码参考下文提供的示例。
参考代码
使用代码前需了解以下前提条件及说明:
1、在代码文件所在的目录下,需预先创建一个名为ts_path的文件夹,用于存放爬取过程中产生的临时.ts文件。
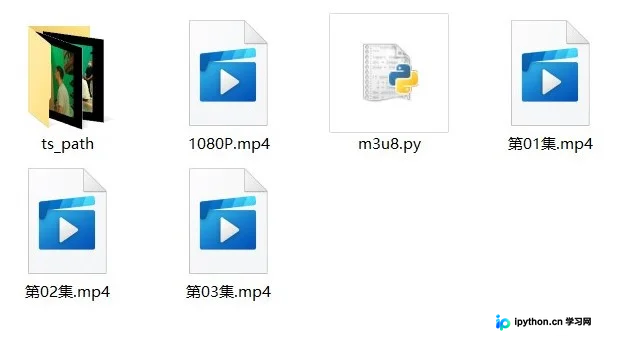
2、最终生成的视频文件将保存在与代码文件相同的目录下,视频命名格式为“集数.mp4”。
3、视频下载完成后,ts_path文件夹中的临时文件需手动删除。由于之前使用os.system执行删除命令曾导致误删源码文件,为避免意外发生,本代码中未包含自动删除临时文件的逻辑。
4、该代码仅针对上述提供的特定网站编写,若需应用于其他网站,需根据目标网站的结构自行修改相关逻辑。
import requests
import re
import os

URL = "输入URL" #视频URL
resources = 0   #播放源选择

episode_urls = [] #存放章节URL
episode_names = [] #存放章节名称
m3u8_urls = []  #存放ts文件的URL

def get_episode(URL,resources): #获取章节名和路径
    results = requests.get(URL)
    results.encoding = "utf-8"
    all = results.text
    results.close()
    episode = re.findall('<ul class="dslist-group">.*?</ul>', all, flags=re.S)
    b = re.finditer('href=".*?</a>', episode[resources],flags=re.S)
    for i in b:
        i = i[0].replace('href="', "").replace('"', "")
        episode_urls.append("https://www.3s8m.com" + i.split('>', 1)[0])
        episode_names.append(i.split('>', 1)[1].replace("</a>", ""))
    print(episode_names)
    print(episode_urls)


def get_ts(episode_urls): #获取ts文件路径
    for i in episode_urls:
        results = requests.get(i)
        results.encoding = "utf8"
        results = re.search('https:.*?\.m3u8', str(results.text),flags=re.S)
        m3u8_urls.append(results[0].replace("\\", ""))
    print(m3u8_urls)


def download_video(episode_names, m3u8_urls): #下载ts文件并整合为mp4文件
    for i in range(len(m3u8_urls)):
        try:
            print(m3u8_urls[i])
            results = requests.get(m3u8_urls[i])
            results.encoding = "utf8"
            all = re.finditer("https://.*?#", results.text, flags=re.S)
            results.close()
            cmd = []
            n = 0
            for j in all:
                n += 1
                ts_url = j[0].replace("\n#", "")
                cmd.append(f'{n}.ts')
                results = requests.get(ts_url,)
                results.encoding = "utf8"
                with open(f"./ts_path/{n}.ts", "wb") as file:
                    file.write(results.content)
                results.close()
                print(f"{n}.ts 下载完成")
            os.chdir("ts_path")
            if ("ts_path" in os.getcwd()):
                cmd = "+".join(cmd)
                cmd = f"copy /b {cmd} {episode_names[i]}.mp4"
                os.system(cmd)
                os.system(f"move {episode_names[i]}.mp4 ../")
            os.chdir("../")
            print(f"{episode_names[i]}.mp4 下载成功")
        except Exception as e:
            print(e)
            exit(0)

if __name__ == '__main__':
    get_episode(URL, resources)
    get_ts(episode_urls)
    download_video(episode_names, m3u8_urls)
总结
至此,关于利用Python爬取M3U8格式视频的教程已介绍完毕。如需了解更多相关Python爬取M3U8视频的内容,建议搜索本站历史文章或继续浏览后续相关文章。感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















