


Python 2与Python 3的关键语法差异:print、除法与Unicode处理详解

从 Python 2 迁移到 Python 3 并不是简单的语法微调,其核心变动集中在输出机制的函数化(print)、数值运算的精确化(除法机制)以及文本与二进制边界的彻底划清(Unicode 模型)。理解这三大差异的内在逻辑与运行时表现,是排查遗留代码缺陷、编写双版本兼容逻辑以及安全重构旧项目的关键技术基础。
一、print:从关键字语句到内建函数
在 Python 2 中,print 是一个内置关键字(Statement),它的行为类似于 return 或 assert。而在 Python 3 中,print() 被重构为一个完全规范的内置函数(Function)。这一改变不仅规范了语法树解析规则,也解决了旧版中重定向和格式化控制繁琐的问题。
1. 语法形态与括号陷阱
Python 2 允许直接跟随输出内容而无需括号:print "Hello"。如果开发者在 Python 2 中给 print 加上括号并传入逗号分隔的多个值,例如 print("A", "B"),解释器并不会将其解析为两个参数,而是将其视为一个整体的 元组(tuple) 并直接打印:
# Python 2.7 终端执行
>>> print "Hello World"
Hello World

>>> print("A", "B")
('A', 'B')   # 输出的是元组字面量表示,而非空格隔开的两个字符串
在 Python 3 中,print() 必须带有圆括号,未加括号直接引发 SyntaxError。传入逗号分隔的参数时,解释器将其识别为函数的独立位置参数:
# Python 3 终端执行
>>> print("Hello World")
Hello World

>>> print("A", "B")
A B          # 参数依次解包并输出,默认用空格分隔
2. 控制参数的替换(换行与流重定向)
在 Python 2 中,若要阻止输出末尾的自动换行,必须在语句末尾添加一个尾随逗号;若要将内容输出到特定流(例如标准错误流 sys.stderr 或本地文件),则需要使用冷门的 >> 运算符重定向语法:
# Python 2 示例
import sys
print "Loading",      # 尾随逗号防止换行,但会多产生一个不可控的空格
print >> sys.stderr, "Error message"  # >> 语法重定向至文件流
Python 3 统一通过命名关键字参数实现对输出行为的精确控制:
sep:指定多个输出项之间的分隔符,默认为' '。end:指定结尾字符,默认为'\n',设为空字符串end=''即可精准控制不换行。file:指定输出目标流对象,替代旧版的>>语法。flush:布尔值,决定是否强制立即清空缓冲区(无需显式调用sys.stdout.flush())。
# Python 3 对应规范写法
import sys
print("Loading", end="", flush=True)
print("Error message", file=sys.stderr)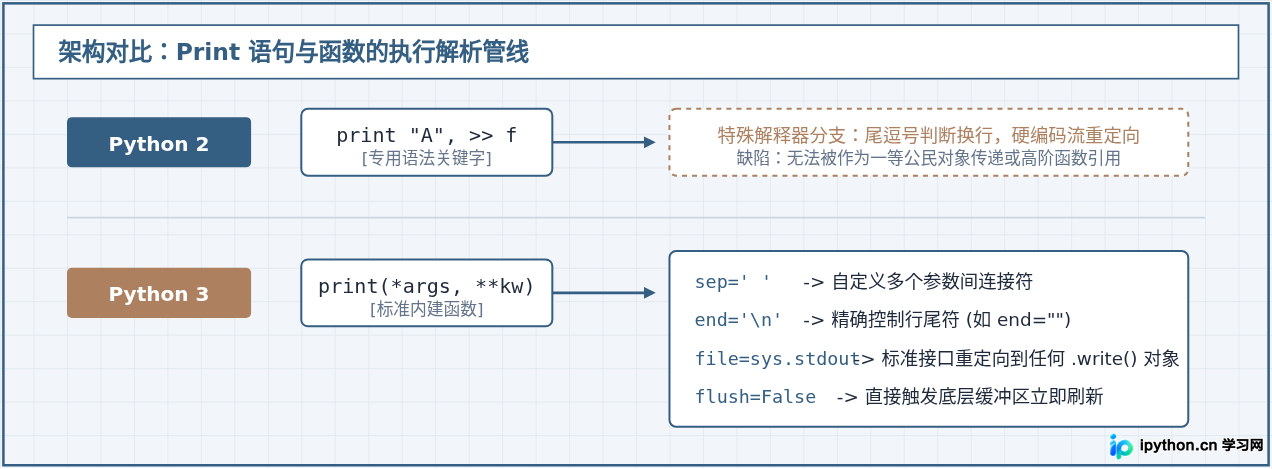
二、除法机制:经典除法与真除法的彻底分离
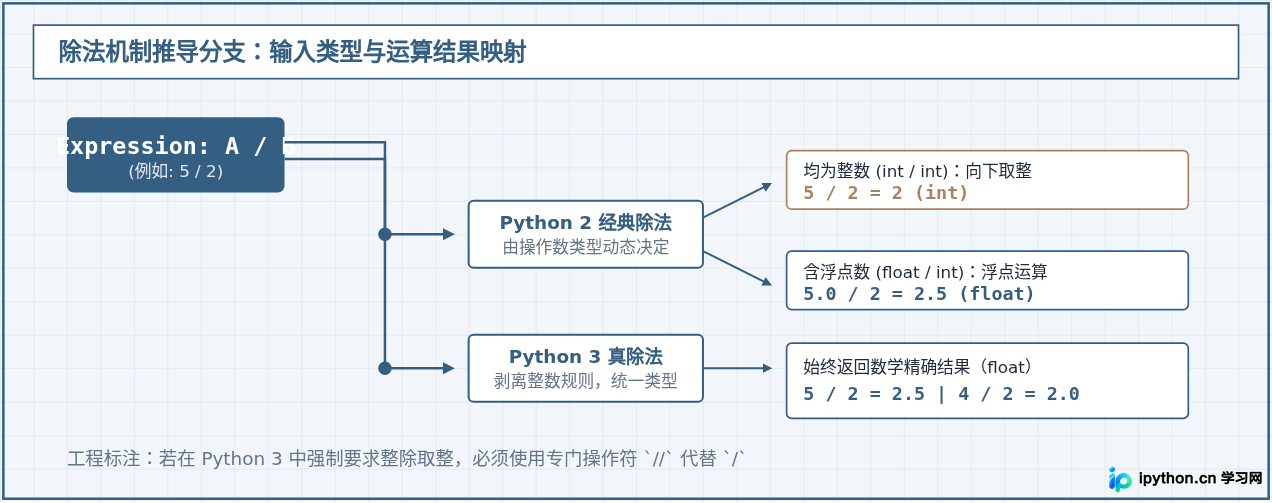
除法计算模式的演进是导致数学计算在跨版本移植中隐蔽报错的最主要原因。Python 2 沿袭了 C 语言的“地板除”(向下取整)传统,而 Python 3 确立了默认“真除法”(保留小数)的设计原则。
1. 单斜杠 / 的行为截然不同
在 Python 2 中,/ 执行的是经典除法(Classic Division):运算行为由操作数的类型决定。如果两个操作数均为整型(int 或 long),结果将强行截断小数部分并向下取整;只有当其中至少一个是浮点型(float)时,才会保留浮点小数。
# Python 2.7 执行
>>> 5 / 2
2         # 整数相除,小数部分被丢弃

>>> 5.0 / 2
2.5       # 其中一个为 float,结果转为 float
在 Python 3 中,/ 统一执行真除法(True Division):不论操作数是整型还是浮点型,返回值始终是计算出的精确浮点数(float)。整除需求被明确转交给双斜杠 //(地板除,Floor Division):
# Python 3 执行
>>> 5 / 2
2.5       # 永远返回 float,即使能整除:4 / 2 结果也是 2.0

>>> 5 // 2
2         # 显式地板除法,结果依然为 int
2. 地板除 // 的隐患与负数截断规则
很多开发者误认为“截断”是向零截断,但 Python 无论是 2 还是 3,对于整除计算均严格执行“向下取整(Floor)”,即取不大于该结果的最大整数:
# 负数整除表现(Python 2 与 3 一致)
>>> -5 // 2
-3 # 真实值为 -2.5,向下取整为 -3,而不是 -2page_count = total_items / page_size),在未迁移的代码中原本依赖整除逻辑,若直接拿到 Python 3 运行,page_count 会变为浮点型,随后传入 range() 将直接抛出 TypeError: 'float' object cannot be interpreted as an integer。必须将其修改为 //。
三、Unicode 与文本/二进制边界:最彻底的底层重构
Python 2 最常为人诟病的问题,是其对文本字符与原始字节序列之间模糊不清的混用机制;这一设计引发了无数臭名昭著的 UnicodeDecodeError。Python 3 从类型层面对两者进行了物理隔离。
1. Python 2 的模糊模型:str 与 unicode
在 Python 2 中,存在两种字符串类型:
str:本质上是原始字节序列(Bytes),没有关联任何字符集编码信息。unicode:表示抽象的文本字符,使用带u前缀的字面量声明,如u"中国"。
当使用 + 拼接 str 和 unicode,或者进行比较运算时,Python 2 会触发隐式自动类型转换。它会默认使用系统全局的 sys.getdefaultencoding()(通常是 ascii)试图将 str 字节解码为 unicode。一旦字节包含非 ASCII 字符(如汉字、特殊符号),解码就会在运行时崩溃:
# Python 2 常见隐蔽崩溃场景
>>> text = u"价格: "      # unicode 类型
>>> price = "100元"      # str 类型,包含非 ASCII 字节(UTF-8 编码下)
>>> text + price
UnicodeDecodeError: 'ascii' codec can't decode byte 0xe5 in position 3: ordinal not in range(128)
2. Python 3 的严格隔离:str 与 bytes
Python 3 彻底消除了这种隐式推测,将概念重新明确为两种互不兼容的类型:
str:表示纯粹的文本字符序列(其内部根据字符码点自动选用 latin-1, ucs2, ucs4 存储),默认源码中所有未带前缀的字符串字面量全都是 unicode 文本。bytes:表示纯粹的 8 位原始二进制字节序列,必须显式声明前缀b"..."。
在 Python 3 中,str 与 bytes 不会发生任何隐式强制转换。使用 + 拼接两者会直接报类型错误,进行 == 比较也始终返回 False。它们之间的转换必须通过两条清晰的单向途径完成:
# Python 3 显式转换标准模型
# 1. 文本 (str) 编码为 二进制字节 (bytes)
b_data = "你好".encode("utf-8")     # 得到 b'\xe4\xbd\xa0\xe5\xa5\xbd'

# 2. 二进制字节 (bytes) 解码为 文本 (str)
s_data = b_data.decode("utf-8")     # 恢复为 '你好'

# 严禁隐式混合操作
>>> "Count: " + b"10"
TypeError: can only concatenate str (not "bytes") to str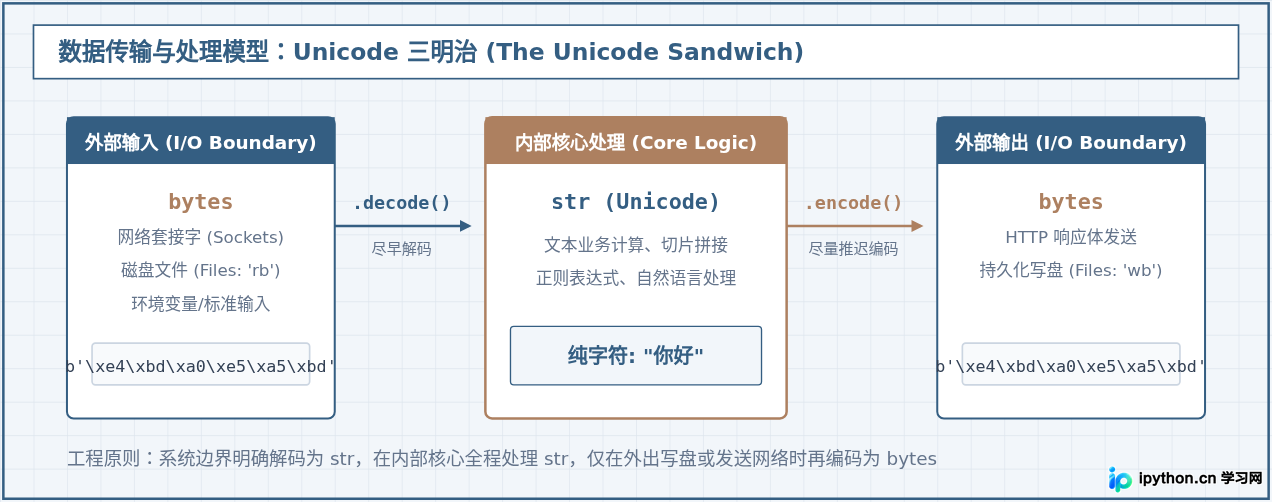
四、关键差异对照与排查指引
为了帮助读者直观识别代码中的迁移隐患,下表系统总结了这三大关键特性的具体语法与运行时表现:
| 对比维度 | Python 2 行为 | Python 3 行为 | 潜在问题及修复方式 |
|---|---|---|---|
| print 语法 | 内置语句,支持 print x 和 print >> stream |
内置函数 print(x, file=stream, end="") |
旧语法在 Py3 报 SyntaxError。在 Py2 文件顶部加入 from __future__ import print_function |
除法 / |
5 / 2 == 2(整数整除) |
5 / 2 == 2.5(永远返回浮点数) |
直接返回 float 会导致作为下标索引时引发 TypeError。改为 5 // 2 显式取整 |
| 默认字符串 | str 为原始字节(ASCII/Bytes),unicode 需加 u"" |
str 默认为 Unicode 文本,原始字节使用 bytes(需加 b"") |
旧代码读文件得到的是 str,Py3 区分文本模式和二进制模式。读写网络流需显式 encode()/decode() |
| 字符串拼接 | unicode + str 发生隐式转换,易报 UnicodeDecodeError |
str + bytes 直接抛出 TypeError,拒绝一切隐式转换 |
重构数据管线,确保内部处理对象类型绝对纯净统一,杜绝类型穿透 |
五、从 Python 2 迁移到 Python 3 的标准实践步骤
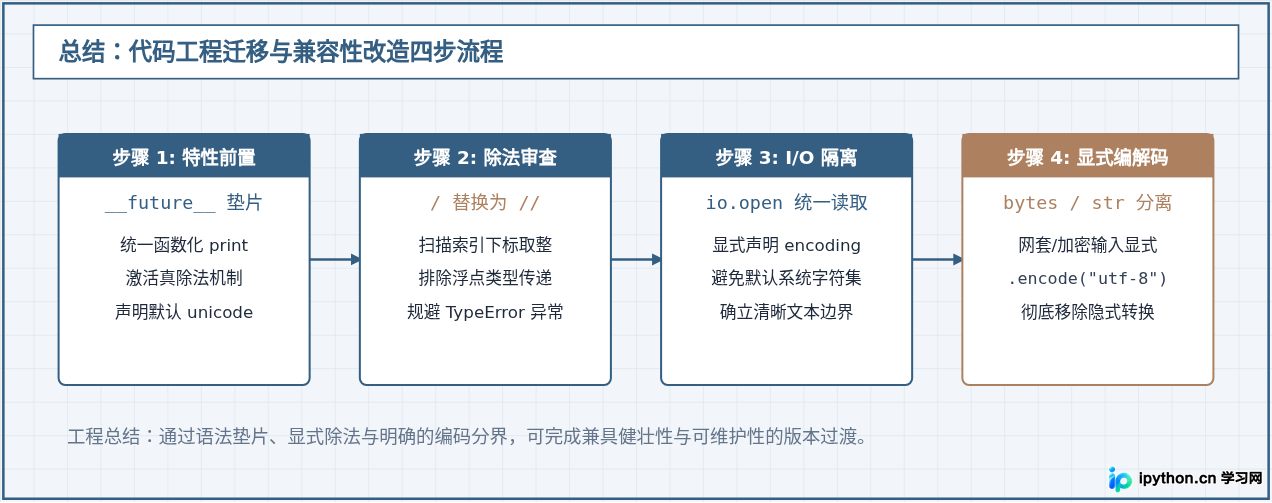
如果要改造现有依赖 Python 2 的遗留脚本,或者需要编写一段同时在 Python 2 和 Python 3 环境下均能完全兼容运行的库代码,推荐按照以下四个标准化步骤进行改造:
-
第一步:在 Python 2 文件顶部引入
__future__垫片
在所有需要维护的 Python 2 代码文件首行直接启用 Python 3 的核心语法特性,让 Python 2 解释器提前以 Python 3 的规则运行:# 必须位于代码文件的最顶端(除注释和 docstring 外) from __future__ import print_function # 禁用 print 语句,开启 print() 函数 from __future__ import division # 启用真除法,使 / 运算始终返回浮点数 from __future__ import unicode_literals # 脚本内所有未加前缀的字面量均为 unicode -
第二步:审查所有斜杠运算符
全局搜索代码中的/,确认代码逻辑是否依赖了整数被向下取整的特性。若确定需要整数结果,一律替换为双斜杠//;若是保留精确度,则维持单斜杠/。 -
第三步:重构文件 I/O 与编码管理
彻底告别 Python 2 原生的open()(它仅按字节读入),改用io.open()并显式指定encoding='utf-8':import io # 跨版本安全的纯文本读取模式 with io.open("data.txt", mode="r", encoding="utf-8") as f: content = f.read() # 在 Python 2 和 3 中均稳定返回 Unicode 字符串 -
第四步:隔离网络与序列化协议
凡是调用socket.send()、写入加密哈希(如hashlib.md5())或使用struct处理结构体的部分,必须在传入前显式使用.encode('utf-8')将str转换为bytes;解析输出时显式调用.decode('utf-8')。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















