


Python 3相比Python 2有哪些性能提升和新特性?asyncio与类型提示介绍
详细解析Python 3相比Python 2在内存布局、惰性求值与解释器层面的性能提升,梳理Unicode字符串分离等核心语法特性,并通过完整代码示例讲解asyncio异步并发与类型提示(Type Hints)的实际用法。
Python 3相比Python 2的核心改进体现在三个层面:底层通过紧凑字典布局、惰性迭代器和自适应字节码解释器降低了内存开销并提升了执行效率;语言层面强制分离文本(str)与二进制数据(bytes),消除了隐式编码转换引发的崩溃;工程层面引入了原生异步框架asyncio和标准化的类型提示(Type Hints),解决了高并发I/O调度和大型项目可维护性两大痛点。本文将逐一拆解这些机制的运作原理,并通过完整代码演示asyncio和类型提示的实际用法。
一、Python 3相比Python 2的核心性能提升
在运行常规业务逻辑和存储大量对象时,Python 3的内存占用显著低于Python 2,CPU密集型与属性访问密集型任务的执行速度也更快。这种差异并非来自单一的语法改动,而是源于底层数据结构和解释器执行机制的重构。
1. 字典(dict)紧凑内存布局与顺序保持
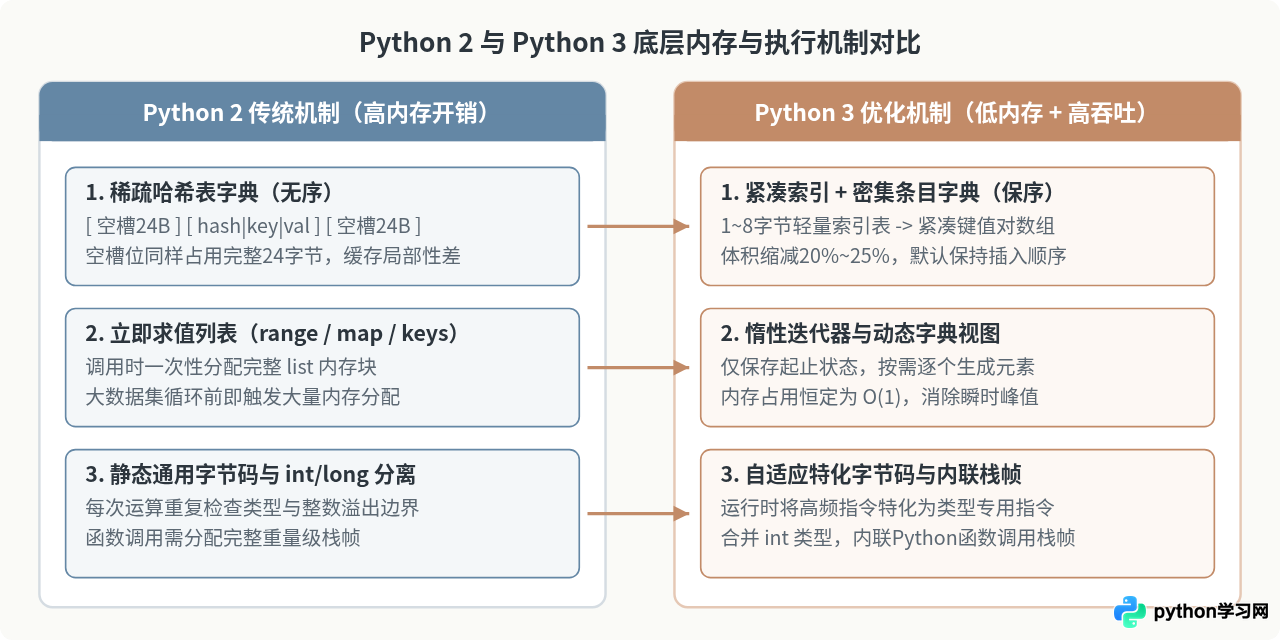
Python中几乎所有对象的属性(__dict__)、模块命名空间和关键字参数都存储在字典中。Python 2的dict采用单一稀疏哈希表,每个槽位(Entry)都要完整存放哈希值、键指针和值指针(64位系统下每个槽位占24字节),且为了降低哈希冲突,表中有大量空槽位直接浪费了这24字节。
从Python 3.6开始,dict改为“紧凑索引表 + 密集条目数组”的双层结构:稀疏的索引表只存储1到8字节的整数下标,真正的键值对按插入顺序紧密排列在另一个数组中。这一改动直接将字典的内存体积缩减了20%至25%,提升了CPU缓存命中率,同时让字典默认保持键的插入顺序(Python 3.7起正式成为语言规范)。
2. 全面转向惰性求值(迭代器视图)
Python 2的range()、map()、filter()、zip()以及字典的.keys()、.values()、.items()在调用时会立即在内存中分配一个完整的列表(list)。处理百万级数据时,这会导致瞬时内存暴涨。
Python 3将这些函数和方法统一改为返回惰性迭代器(Iterator)或动态视图对象(View)。它们只在循环逐个读取元素时才按需计算下一个值,无论数据规模多大,迭代器本身只占用固定的几十字节内存。Python 2中的xrange()也因此被废除,直接由Python 3的range()接替。
3. 整数类型统一与自适应字节码解释器
Python 2区分固定机器字长的int和任意精度的long,每次算术运算都需要检查是否溢出并在两种类型间转换。Python 3移除了long类型,所有整数统一为支持任意精度的int,并在底层采用按需扩展的数组存储。
此外,Python 3.11及后续版本在CPython解释器中引入了自适应特化解释器(Specializing Adaptive Interpreter,PEP 659)。当解释器发现某行字节码反复处理相同类型(例如连续执行两个整数相加或访问同一类实例的属性)时,会在运行时将通用字节码动态替换为针对该类型的特化指令,省去了重复的类型查找与函数调用帧分配开销。在官方pyperformance基准测试中,Python 3.11相比早期3.x版本及Python 2.7的平均执行速度提升了10%至60%不等(具体幅度取决于代码中属性访问和函数调用的密集程度)。
二、Python 3的核心语言新特性
除了底层性能改进,Python 3在语法设计上修正了Python 2早期留下的类型歧义,并增加了多项简化日常编码的语言特性。
1. 文本(str)与二进制数据(bytes)彻底分离
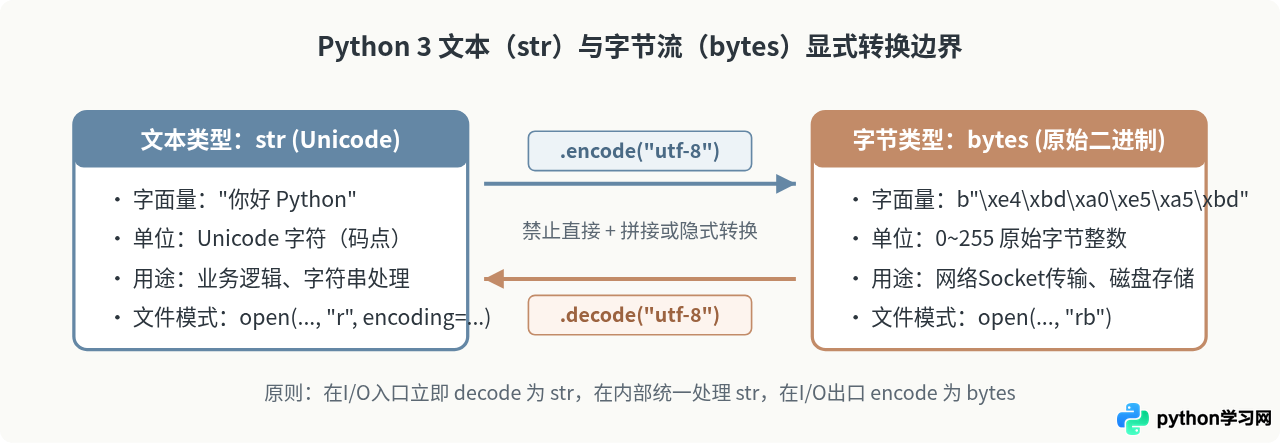
这是Python 3与Python 2最核心的区别。Python 2的str既是文本又是原始字节流,当代码中混合拼接ASCII字节串与unicode对象时,解释器会尝试使用默认的ascii编码隐式转换,一旦遇到中文字符就会在运行时抛出UnicodeDecodeError。
Python 3将二者严格区分:str专门表示Unicode文本,bytes专门表示原始字节序列(如网络报文、图片文件、加密密文)。str与bytes之间禁止隐式拼接或比较,必须显式调用.encode('utf-8')或.decode('utf-8')完成转换。这种设计将编码错误提前暴露在数据进出系统的边界处(如读写文件、接收HTTP响应时),而不是潜伏在业务处理中途。
2. 常用语法与标准库特性的演进
除编码模型外,Python 3陆续引入了多项直接改变代码编写方式的特性:
- f-string格式化字符串(Python 3.6+):以
f"用户 {name} 的余额为 {balance:.2f}"的形式直接在字符串内嵌入变量与表达式。它在编译期会被解析为直接拼接指令,比Python 2的%格式化和str.format()可读性更高,执行速度也更快。 - 真除法与地板除分离:在Python 2中,
5 / 2对整数执行截断除法得到2,极易在科学计算或比例计算中造成精度丢失。Python 3规定/永远表示浮点数真除法(5 / 2 == 2.5),需要向下取整时必须显式使用//(5 // 2 == 2)。 - 星号扩展解包与字典合并:支持使用
first, *middle, last = [1, 2, 3, 4, 5]直接捕获不定长切片;Python 3.9起支持使用dict_a | dict_b直观合并两个字典。 - 面向对象改进(
pathlib):替代了Python 2中零散的os.path字符串拼接函数,允许通过Path("/var/log") / "app.log"跨平台操作文件系统路径。 - 数据类(
dataclasses,Python 3.7+)与结构化模式匹配(match...case,Python 3.10+):@dataclass装饰器可自动生成__init__、__repr__和__eq__方法;match...case则支持按数据结构(如嵌套字典、元组长度、类属性)进行解构分支匹配。
下面的代码示例展示了上述核心语法特性在Python 3(需Python 3.10及以上环境)中的实际写法,可保存为syntax_demo.py并在终端执行python3 syntax_demo.py:
from dataclasses import dataclass
from pathlib import Path

@dataclass
class Order:
    order_id: int
    items: list[str]
    amount: float

def process_order(raw_title: bytes, record: tuple) -> str:
    # 1. 显式将二进制字节流解码为 Unicode 文本
    shop_name = raw_title.decode("utf-8")

    # 2. 星号扩展解包:提取首元素、尾元素和中间所有商品列表
    order_id, *item_list, raw_cents = record

    # 3. 真除法:整数相除直接保留小数精度
    amount_yuan = raw_cents / 100
    order = Order(order_id=order_id, items=item_list, amount=amount_yuan)

    # 4. 结构化模式匹配(Python 3.10+)与 f-string 格式化
    match order.items:
        case [single_item]:
            desc = f"单品订单({single_item})"
        case [first_item, *rest]:
            desc = f"多件订单(首件:{first_item},共 {len(rest) + 1} 件)"
        case _:
            desc = "空订单"

    log_path = Path("logs") / f"order_{order.order_id}.txt"
    return f"[{shop_name}] {desc} | 金额:¥{order.amount:.2f} | 归档路径:{log_path}"

if __name__ == "__main__":
    title_bytes = "星辰书店".encode("utf-8")
    sample_record = (10086, "Python核心编程", "流畅的Python", 12850)
    print(process_order(title_bytes, sample_record))
[星辰书店] 多件订单(首件:Python核心编程,共 2 件) | 金额:¥128.50 | 归档路径:logs/order_10086.txt
三、asyncio异步编程:原理与实操步骤
在Python 2时代,由于全局解释器锁(GIL)的限制,处理成百上千个高并发网络请求通常需要引入第三方框架(如Twisted、Tornado或Gevent猴子补丁),代码风格碎片化且调试困难。Python 3.4引入了asyncio标准库,并在Python 3.5中确立了原生的async def和await关键字,使单线程异步并发成为语言内置能力。
1. asyncio是如何运作的?
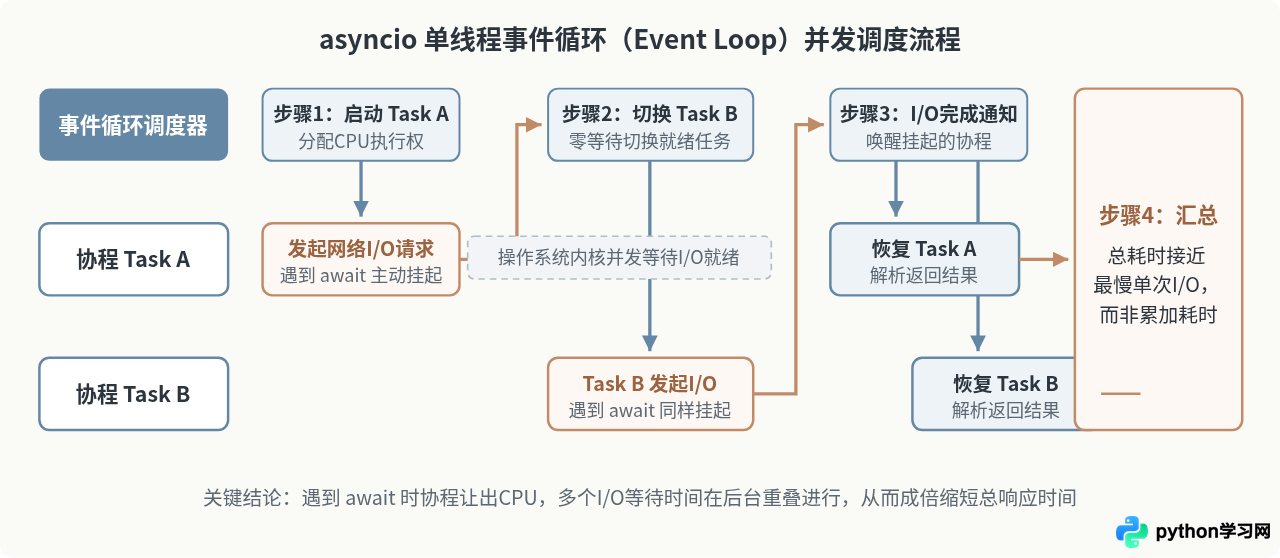
asyncio的核心是事件循环(Event Loop)与协程(Coroutine)的协作式调度。与多线程靠操作系统强制抢占切换不同,asyncio全程运行在单个线程内:当一个协程执行到网络请求、数据库查询或定时器等待等I/O操作(即遇到await表达式)时,它会主动挂起自身,把控制权交还给事件循环;事件循环立即切换到其他已经准备就绪的协程继续执行,直到操作系统的I/O多路复用器(如Linux下的epoll、macOS下的kqueue)通知刚才的I/O数据已返回,事件循环再唤醒原协程从挂起点继续向下执行。
因为全程在单线程内受控切换,它既省去了上千个操作系统线程的栈内存开销(每个线程默认需数MB栈空间,而一个协程对象仅需几百字节至几KB),又避免了多线程频繁上下文切换的CPU损耗。
2. 编写asyncio并发程序的完整步骤
编写一个标准的asyncio并发任务分为三个步骤:
- 使用
async def定义协程函数:在函数内部,凡是需要等待I/O的地方,必须调用异步非阻塞接口并在前面加上await。 - 使用并发原语组织多个任务:如果只是连续写两行
await fetch(1)和await fetch(2),任务依然会串行执行。要让多个协程同时挂载到事件循环上并发等待,需要使用asyncio.gather()或Python 3.11新增的结构化并发上下文asyncio.TaskGroup()。 - 通过
asyncio.run()启动入口协程:在程序主入口调用asyncio.run(main()),它会自动创建事件循环、运行全部任务并在结束时安全关闭循环。
将以下代码保存为async_demo.py,在Python 3.7及以上环境中运行python3 async_demo.py,即可对比并发执行与串行执行的耗时差异:
import asyncio
import time

async def query_service(service_name: str, delay_seconds: float) -> dict:
    print(f"[{service_name}] 开始发起请求,预计等待 {delay_seconds} 秒...")
    # 使用 asyncio.sleep 模拟非阻塞网络I/O等待
    await asyncio.sleep(delay_seconds)
    print(f"[{service_name}] 收到响应数据")
    return {"service": service_name, "latency": delay_seconds, "status": "ok"}

async def main() -> None:
    start_time = time.perf_counter()

    # 使用 asyncio.gather 将三个协程同时注册到事件循环并发执行
    results = await asyncio.gather(
        query_service("用户中心API", 1.2),
        query_service("订单查询API", 1.5),
        query_service("库存校验API", 0.8),
    )

    elapsed = time.perf_counter() - start_time
    print(f"\n全部任务完成,共获取 {len(results)} 条结果,总耗时:{elapsed:.2f} 秒")
    for item in results:
        print(f" - {item['service']}: 状态={item['status']}, 耗时={item['latency']}s")

if __name__ == "__main__":
    asyncio.run(main())
[用户中心API] 开始发起请求,预计等待 1.2 秒...
[订单查询API] 开始发起请求,预计等待 1.5 秒...
[库存校验API] 开始发起请求,预计等待 0.8 秒...
[库存校验API] 收到响应数据
[用户中心API] 收到响应数据
[订单查询API] 收到响应数据

全部任务完成,共获取 3 条结果,总耗时:1.50 秒
 - 用户中心API: 状态=ok, 耗时=1.2s
 - 订单查询API: 状态=ok, 耗时=1.5s
- 库存校验API: 状态=ok, 耗时=0.8s在
async def函数中,如果直接调用time.sleep(2)或同步的requests.get(),由于它们不包含await挂起协议,会直接卡死整个单线程事件循环,导致其他所有协程全部停滞。发起HTTP请求应改用支持异步的httpx.AsyncClient或aiohttp;如果必须调用无法改造的同步阻塞函数或CPU密集型函数,应使用await asyncio.to_thread(blocking_func, arg)(Python 3.9+)将其委托给后台线程池执行。
四、类型提示(Type Hints):语法演进与静态检查实践
Python作为动态类型语言,变量类型在运行时才确定。当项目规模扩大到多人协作或数万行代码时,阅读函数定义def calculate_discount(user, items, rate):很难直接判断user是字典还是类实例、rate是百分比整数还是小数。Python 3.5通过PEP 484正式引入了类型提示(Type Hints),允许开发者为函数参数、返回值和变量显式标注预期类型。
1. 核心规则:解释器忽略检查,静态工具负责校验
理解Python类型提示最关键的前提是:添加类型提示默认不会改变代码的运行时行为,也不会影响运行性能,更不会在传入错误类型时自动报错。CPython解释器在运行时仅将类型注解保存在函数对象的__annotations__字典中。真正的类型校验发生在代码运行之前——由IDE(如VS Code的Pylance、PyCharm)或命令行静态类型检查工具(如mypy、pyright)读取源码并给出告警。
2. Python 3类型提示的简化语法(3.9与3.10+)
在Python 3.5至3.8中,标注列表、字典或可选类型必须从typing模块导入大写的List、Dict、Optional、Union。从Python 3.9(PEP 585)和Python 3.10(PEP 604)开始,标准内置类型和竖线运算符|可以直接用于类型标注,大幅减少了冗余导入:
| 类型场景 | Python 3.5 ~ 3.8 旧写法 | Python 3.10+ 推荐现代写法 |
|---|---|---|
| 字符串列表 | from typing import Listnames: List[str] |
无需导入,直接使用内置类型:names: list[str] |
| 键值字典 | from typing import Dictscores: Dict[str, int] |
无需导入:scores: dict[str, int] |
| 联合类型(多种可能) | from typing import Unionuid: Union[int, str] |
使用竖线运算符:uid: int | str |
| 可空类型(可能为None) | from typing import Optionalemail: Optional[str] = None |
使用竖线与None组合:email: str | None = None |
3. 编写类型提示并使用mypy进行静态检查
下面通过一个完整的订单折扣计算示例展示如何编写类型提示,以及如何通过mypy在运行前捕获隐藏的None属性访问错误。将以下代码保存为type_check_demo.py(需Python 3.10及以上环境):
from dataclasses import dataclass

@dataclass
class Member:
    username: str
    vip_level: int
    coupon_code: str | None = None

def calc_final_price(
    member: Member,
    prices: list[float],
    extra_discount: float | None = None
) -> float:
    base_total = sum(prices)
    # VIP会员享受9折,普通会员原价
    rate = 0.9 if member.vip_level >= 1 else 1.0
    total = base_total * rate

    # 显式判断 None 分支,静态检查器会自动将分支内的 extra_discount 窄化为 float
    if extra_discount is not None:
        total -= extra_discount

    return round(max(total, 0.0), 2)

if __name__ == "__main__":
    user = Member(username="alice", vip_level=2)
    final_amount = calc_final_price(user, [59.9, 40.1], extra_discount=10.0)
    print(f"用户 {user.username} 应付金额:{final_amount:.2f} 元")
直接运行该脚本python3 type_check_demo.py,可以得到正常的计算结果:
用户 alice 应付金额:80.00 元
若要在代码上线或提交前执行静态类型验证,可在终端安装并运行mypy:
pip install mypy
mypy type_check_demo.pySuccess: no issues found in 1 source file
如果有人在调用时误传了字符串价格列表calc_final_price(user, ["59.9", "40.1"]),或者删掉了if extra_discount is not None:直接执行total -= extra_discount,无需真正运行程序触发线上异常,执行mypy type_check_demo.py就会立即指出具体的行号和类型不匹配原因(例如提示Unsupported operand types for - ("float" and "None"))。
五、总结与迁移对照全景
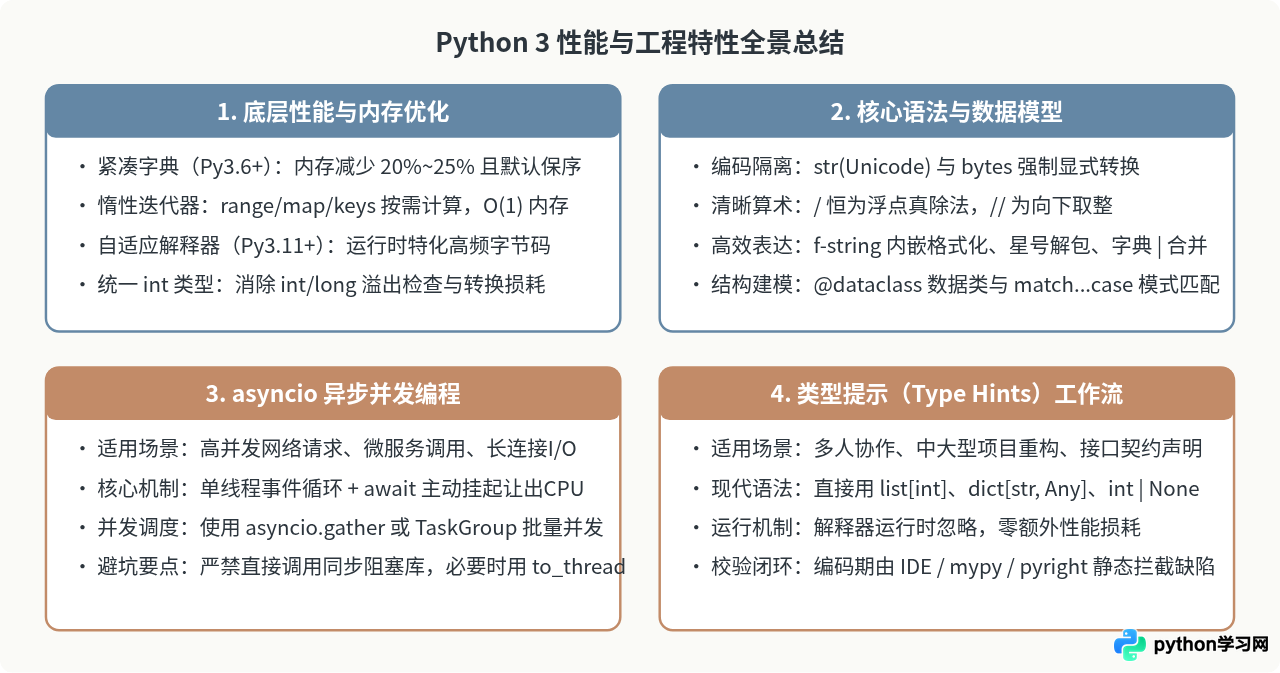
从Python 2升级到现代Python 3,不仅是语法的调整,更是从“脚本式松散编写”向“高性能、高并发、强工程约束”的转变。下图汇总了Python 3在底层性能、语言特性、异步I/O以及静态类型检查四个维度的核心工作流与适用场景。
常见疑问解答
- 既然有了
asyncio,还需要使用多线程(threading)或多进程(multiprocessing)吗?
需要,三者解决的问题不同。asyncio专门解决高并发I/O等待问题(如同时请求几百个网页或数据库接口);对于少量的第三方同步阻塞库调用,使用threading或asyncio.to_thread()更简单;而对于图像处理、矩阵运算、大文件压缩等CPU密集型任务,由于GIL限制单进程同一时刻只能跑满一个CPU核心,必须使用multiprocessing或concurrent.futures.ProcessPoolExecutor通过多进程利用多核CPU。 - 类型提示如果想要在运行时也强制校验(例如校验外部传入的JSON接口参数),该怎么做?
标准类型提示本身不在运行时拦截错误。如果需要对外部不可信输入(如Web请求体、配置文件)在运行时基于类型注解自动完成数据校验与类型转换,可以在Python 3类型提示的基础上配合Pydantic库使用,它会在实例化模型时读取类型注解并执行严格的运行时验证。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















