


Python正则表达式匹配反斜杠\\的转义陷阱与解决方案

本文详解Python中使用正则表达式re.sub匹配或替换反斜杠\\时的转义问题。由于正则语法与Python字符串解析器的双重转义机制,直接写入单个反斜杠会导致语法错误。文章通过对比分析,解释了为何需要四个反斜杠(\\\\)或使用原始字符串(r'\\')来正确匹配单个反斜杠,并提供了str.replace()作为替代方案。
问题背景:
在进行网页爬虫开发时,获取的URL链接中可能包含转义字符,即反斜杠 \。为了清理这些数据,计划使用正则表达式的re.sub()函数进行替换,但在编写代码时遇到了语法报错。以下是需要处理的原始字符串示例。

起初尝试直接编写如下代码:
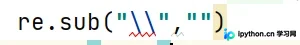
re.sub("\\","",item)编译器提示语法错误(红色波浪线)。
经过查阅资料,发现必须使用四个反斜杠才能正确实现替换功能,即采用如下写法:
re.sub("\\\\","",item)查阅相关文档后,这里简要梳理一下背后的原理。
正则表达式机制
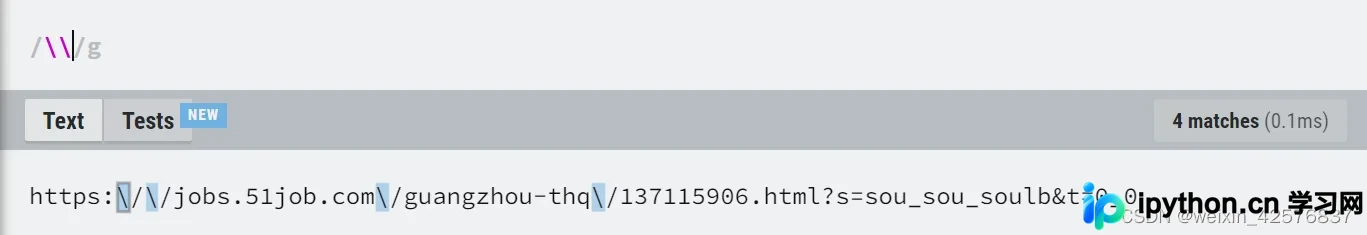
首先,正则表达式拥有独立的语法规则。在正则表达式中,反斜杠 \ 被定义为特殊字符,用于与其他字符组合形成转义序列。因此,若要匹配一个普通的反斜杠 \,在正则表达式语法中必须写作 \\。基于此规则,如果要匹配一个实际的 \ 字符,正则表达式模式应写为 \\,示例如下:
Python字符串处理机制
在Python语言中,若要在字符串中输出一个反斜杠 \ 字符,同样需要利用转义机制:
>>> print("\\")
\
这同样是因为反斜杠在Python字符串中属于特殊字符。
综合上述两点:
当代码中写入如下字符串时:
    item = "https:\/\/jobs.51job.com/guangzhou-thq\/137115906.html?s=sou_sou_soulb&t=0_0"
    item = re.sub("\\\\","",item)
首先,传入的参数是一个Python字符串,Python解释器会先将 "\\\\" 解析为 \\。随后,这个解析后的结果被传递给正则表达式引擎。由于正则引擎也有自己的语法结构,当它接收到 \\ 时,会将其解析为一个字面量的 \。因此,最终的匹配结果仅对应一个 \。
参考StackOverflow上的相关解答:
If you’re putting this in a string within a program, you may actually need to use four backslashes (because the string parser will remove two of them when “de-escaping” it for the string, and then the regex needs two for an escaped regex backslash). For instance:
regex("\\\\")is interpreted as…
regex("\\" [escaped backslash] followed by "\\" [escaped backslash])is interpreted as…
regex(\\)is interpreted as a regex that matches a single backslash.
原文链接:Can’t escape the backslash with regex?
此外,还可以使用原始字符串(Raw String)来简化书写,即写成:
re.sub(r'\\','',item)由于使用了 r'\\' 前缀,Python字符串解析器在遇到 r'\\' 时,会直接去掉外层的引号 r'' 并将其作为原始内容传递给正则表达式引擎。正则引擎随后将 \\ 解析为 \,从而成功匹配到一个反斜杠 \。
字符串内置方法replace()
除了使用正则表达式进行替换外,还可以直接使用字符串对象的replace()方法:
str.replace(old, new[, max]) old – 将被替换的子字符串。 new – 新字符串,用于替换old子字符串。 max – 可选字符串, 替换不超过 max 次
>>> item
'https:\\/\\/jobs.51job.com/guangzhou-thq\\/137115906.html?s=sou_sou_soulb&t=0_0'
>>> item.replace('\\','')
'https://jobs.51job.com/guangzhou-thq/137115906.html?s=sou_sou_soulb&t=0_0'
>>>
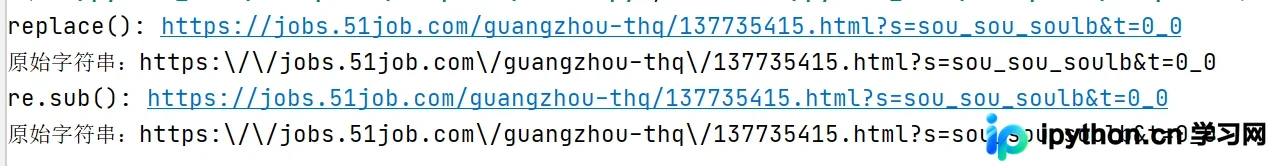
需要注意的是,无论是使用正则的re.sub()还是字符串的replace(),执行后都不会直接修改原始字符串变量,而是返回一个新的字符串:
import re

urL ='https:\/\/jobs.51job.com\/guangzhou-thq\/137735415.html?s=sou_sou_soulb&t=0_0'
print(urL.replace('\\',''))
print(urL)

print(re.sub(r'\\','',urL))
print(urL)
总结
至此,关于Python中使用正则表达式匹配反斜杠\\所遇问题的介绍已完毕。如需了解更多Python正则表达式匹配反斜杠\\的相关内容,建议搜索本站过往文章或继续浏览后续教程,感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















