


Python3 Requests库处理HTTP重定向获取真实URL的两种方法

本文介绍在Python3中使用Requests库处理HTTP 301或302重定向时,如何获取跳转后的真实URL。通过解析Response Header中的Location字段,或利用Requests默认自动跳转特性访问response.url,可分别实现手动提取与自动获取两种方案。
Python3 Requests库处理HTTP重定向获取真实URL的两种方法
前言:
在网页抓取过程中,常遇到URL存在重定向的情况,服务器会返回301或302状态码。此时,我们需要确定如何获取最终的真实URL或跳转后的目标地址。
本文将以Python的requests库为例进行演示说明。
假设我们要访问京东电子商务网站,目前仅知道其域名为http://jd.com。
import requests

def request_jd():
    url = 'http://jd.com/'
    #allow_redirects= False 这里设置不允许跳转
    response = requests.get(url=url, allow_redirects=False)

    print(response.headers)
    print(response.status_code)
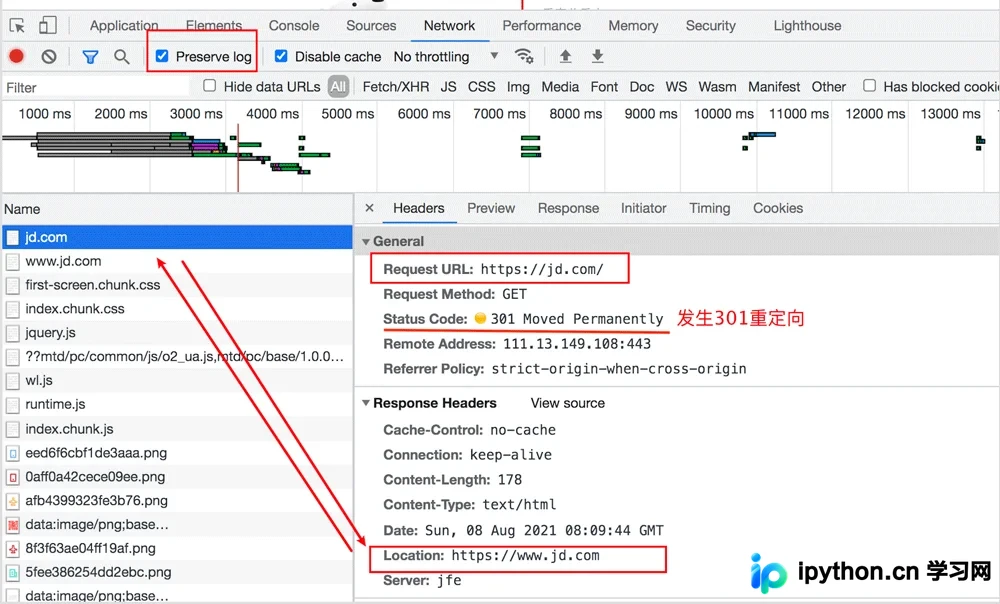
查看返回的response header,可以发现其中包含一个Location属性,这表明发生了重定向'Location': 'https://www.jd.com'。

为了更直观地观察,可以在Chrome浏览器的Network面板中进行抓包分析。请注意勾选“Preserve log”选项,以便在页面跳转后仍能查看历史记录。
从浏览器的Response Header中可以看到Location字段,同时在General部分可以看到状态码为301,确认发生了跳转。
方法1:
现在你已了解如何获取跳转后的URL,只需直接从Response Header中提取Location值即可。
需要注意的是,Request Header中返回的Header Key不区分大小写,因此使用全小写形式同样可以正确获取值。
import requests

def request_jd():
    url = 'http://jd.com/'
    response = requests.get(url=url, allow_redirects=False)
    #return response.headers.get('location')
    return response.headers.get('Location')
方法2:
默认情况下,Requests库会自动处理重定向。如果发生重定向,它会自动跳转到Location指定的URL。我们只需正常访问该URL并获取Response对象,随后通过response.url属性即可直接获得真实的URL。
import requests

def request_jd():
    url = 'http://jd.com/'
    response = requests.get(url=url)

    return response.url
到此这篇关于Python3中Requests库重定向获取URL的文章就介绍到这了,更多相关Python获取URL内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















