


Python内置函数max()与min()的高级用法详解

本文深入解析Python内置函数max()和min()的高级用法。重点讲解如何通过key参数自定义排序规则,处理字典列表等复杂对象;阐述default参数在空可迭代对象中的防错机制;并展示在NumPy多维数组中利用axis参数进行行列极值计算的方法,帮助开发者写出更健壮、高效的代码。
基础用法与类型处理
Python中的 max() 和 min() 函数用于获取可迭代对象或一组参数中的最大值与最小值。它们的行为取决于输入数据的类型:
- 数值型数据:直接比较数值大小,返回数值最大或最小的项。
- 字符型数据:按照字母表顺序(Unicode编码)进行比较,返回排序靠后或靠前的字符串。
当传入多个参数时,函数直接比较这些参数;当传入一个可迭代对象(如列表、元组、字符串)时,函数遍历该对象并返回极值元素。
s = '12345'
print(max(s))
处理空可迭代对象:default参数
当 max() 或 min() 接收一个空的可迭代对象(如空列表 [] 或空元组 ())时,如果不提供额外处理,程序会抛出 ValueError 异常。为了避免程序崩溃,可以使用 default 参数指定一个默认返回值。
如果指定了 default,当可迭代对象为空时,函数将返回该默认值,而不会抛出异常。这是处理不确定数据源时的最佳实践。
print(max((), default=1))
# 输出: 1

# 若不指定default,以下代码将抛出 ValueError
# print(max(()))
高级用法:key参数与自定义排序
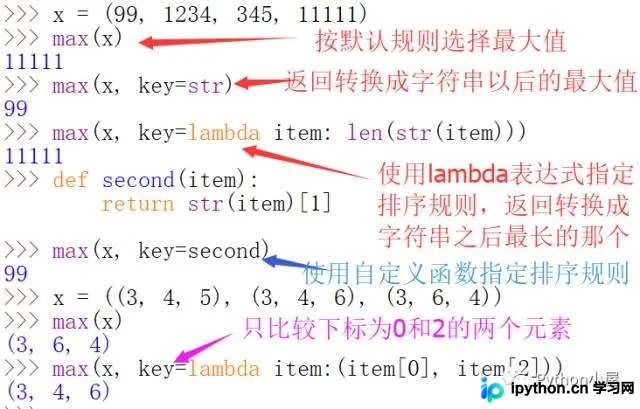
key 参数允许用户传入一个可调用对象(如函数、lambda表达式或类方法),用于指定比较的依据。这是处理复杂数据结构(如字典列表)的核心技巧。
1. 使用 lambda 表达式
在处理包含字典的列表时,我们通常希望根据字典中的某个特定字段(如年龄、价格等)来寻找最大或最小值。此时,可以使用 lambda 函数作为 key 参数的值。
s = [
  {'name': 'sumcet', 'age': 18},
  {'name': 'bbu', 'age': 11}
]
# 根据字典中的 'age' 键的值来寻找最大元素
a = max(s, key=lambda x: x['age'])
print(a)
# 输出: {'name': 'sumcet', 'age': 18}上述代码中,lambda x: x['age'] 定义了比较规则:对于列表中的每个元素 x,提取其 'age' 字段的值作为比较标准。函数最终返回的是原始字典对象,而非提取出的数值。
2. key参数的通用性
key 参数不仅适用于 max() 和 min(),同样适用于 sorted() 和列表的 .sort() 方法。它接收的可调用对象必须返回一个用于比较的值。常见的可调用对象包括:
- 内置函数(如
len,abs)。 - 用户定义的函数。
- lambda 匿名函数。
- 类(通过调用构造函数生成实例进行比较)。
NumPy数组中的极值计算
在使用 NumPy 库处理多维数组时,min() 和 max() 方法(注意是数组对象的方法,而非内置函数)提供了 axis 参数,用于指定计算的维度。
- axis=0:沿垂直方向(行之间)比较,即对每一列求极值。
- axis=1:沿水平方向(元素之间)比较,即对每一行求极值。
import numpy as np
a = np.array([[1,2,3],[0,0,0],[-1,-2,-3],[2,2,2]])

# 不同行相比较得出每列的最小值
print(a.min(0))
# 输出: array([-1, -2, -3])

# 每一行自身元素相互比较得出每行的最小值
print(a.min(1))
# 输出: array([ 1, 0, -3, 2])
通过合理运用 default 和 key 参数,以及理解 NumPy 数组的轴操作,开发者可以灵活应对各种数据极值查找需求,编写出更加健壮和高效的 Python 代码。
 以上就是Python内置函数max()和min()高级用法的详细内容,更多关于Python数据处理技巧的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















