


Python怎么使用key参数实现复杂对象自定义排序
深入解析Python中如何利用sorted()与list.sort()的key参数,对字典、类实例及复合数据结构实现单字段、多字段及混合升降序的自定义排序。
在 Python 中对列表进行排序时,如果元素不是基础数字或字符串,而是字典、自定义类实例或嵌套结构,直接比较往往会抛出 TypeError 或无法达到预期顺序。解决这一问题的标准且高效的方法是使用 sorted() 函数或 list.sort() 方法中的 key 参数。key 参数接收一个单参数可调用对象(函数、lambda 表达式或方法提取器),在排序前为每个待排元素计算出一个“代理键(Key Proxy)”,Python 底层直接依据该键进行比较排序,从而在不修改原对象的前提下实现任意维度的自定义排序。
一、key 参数的核心工作机制
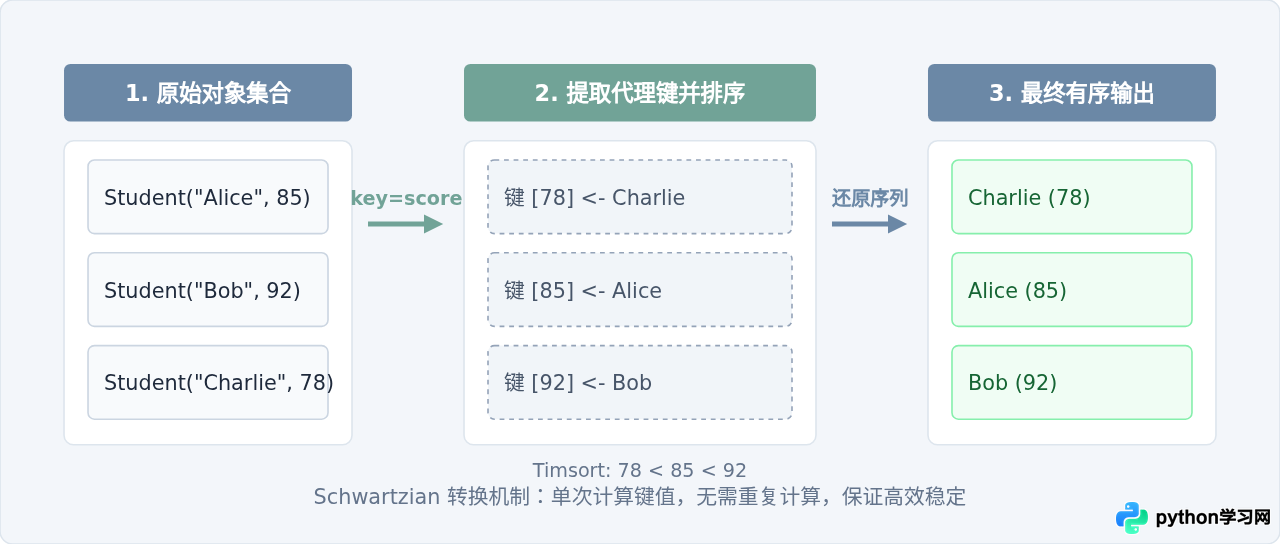
很多初学者容易误以为 key 参数是一个双参数比较函数(如 C++ 或早前 Python 2 中的 cmp)。实际上,Python 核心采用的是 Schwartzian 转换(Decorate-Sort-Undecorate) 原理:
- 单趟提取:在排序真正启动前,Python 仅对每个列表元素调用一次
key函数,提取对应的值并与原对象组合。整个过程的时间复杂度严格为 O(N)。 - 底层比较:内置的高性能混合排序算法(Timsort)直接对提取出的键进行两两比较。
- 剥离还原:排序完成后,丢弃临时键,返回排好序的原对象序列。
二、常见复杂对象的单属性自定义排序
1. 字典列表排序
当处理 JSON 数据或数据库查询结果时,数据通常以字典列表形式组织。最直接的写法是使用匿名函数 lambda 提取特定键:
users = [
    {"name": "Alice", "age": 28, "salary": 9500},
    {"name": "Bob", "age": 22, "salary": 12000},
    {"name": "Charlie", "age": 35, "salary": 8000}
]

# 按 age 从小到大排序
sorted_by_age = sorted(users, key=lambda u: u["age"])

# 示例输出:
# [{'name': 'Bob', 'age': 22, ...}, {'name': 'Alice', 'age': 28, ...}, {'name': 'Charlie', 'age': 35, ...}]
2. 自定义类实例排序
如果数据保存在自定义类实例中,可以直接通过 lambda 访问其实例属性或方法:
class Employee:
    def __init__(self, name, department, level):
        self.name = name
        self.department = department
        self.level = level

    def __repr__(self):
        return f"Employee({self.name}, {self.department}, L{self.level})"

employees = [
    Employee("Zhang", "Dev", 5),
    Employee("Li", "QA", 3),
    Employee("Wang", "Dev", 7)
]

# 按职级 level 排序
employees.sort(key=lambda emp: emp.level)
# 排序后列表原地更新为:[Employee(Li, QA, L3), Employee(Zhang, Dev, L5), Employee(Wang, Dev, L7)]
3. 使用 operator 模块提升运行性能
Python 标准库提供了内置的 operator 模块,包含专门用于属性和键提取的 C 语言级高效函数:
operator.itemgetter("key"):等价于lambda d: d["key"]operator.attrgetter("attr"):等价于lambda obj: obj.attr
from operator import itemgetter, attrgetter

# 字典排序改写为 itemgetter(效率高于普通 Python lambda)
users_sorted = sorted(users, key=itemgetter("salary"))

# 类实例排序改写为 attrgetter
employees.sort(key=attrgetter("level"))
三、多属性组合与复杂优先级排序
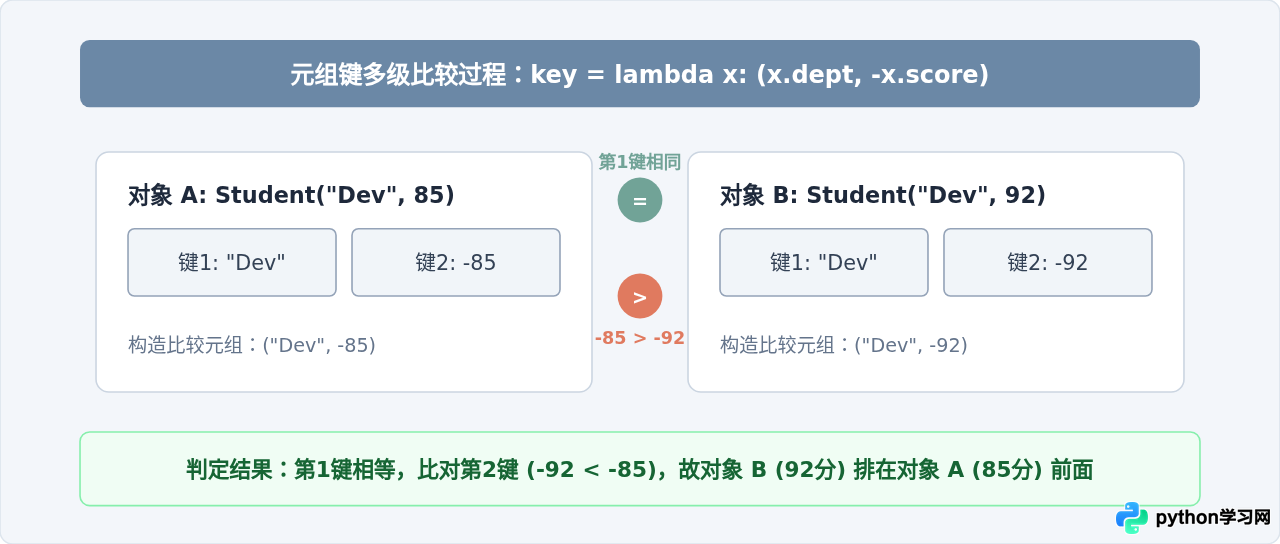
实际业务中经常遇到“先按部门字母排序;部门相同时按职级降序排列”这种多维需求。在 Python 中,实现多字段排序的核心秘诀在于元组(Tuple)比较机制。
在 Python 中,元组的比较是严格按从左到右的位置逐项对比的。如果第 0 个元素不同,就直接根据该元素决定大小;只有在第 0 个元素完全相等时,才会继续比对第 1 个元素。这与现实中的主次排序逻辑完全一致。
1. 同向多属性排序(均为升序)
students = [
    {"dept": "Math", "grade": 2, "name": "Tom"},
    {"dept": "Art",  "grade": 1, "name": "Lily"},
    {"dept": "Math", "grade": 1, "name": "Jack"}
]

# 第一关键字 dept 升序,第二关键字 grade 升序
sorted_students = sorted(students, key=lambda s: (s["dept"], s["grade"]))
# 排序结果:
# 1. Art, grade: 1
# 2. Math, grade: 1
# 3. Math, grade: 2
2. 混合升降序排序(关键技巧)
当一个字段需要升序、另一个字段需要降序时,不能单纯传递 reverse=True(因为该参数会对整个元组生效)。根据字段数据类型,通常有两种处理手段:
如果降序字段是整型、浮点型或可数值化的数据,最简单的方法是加上负号
-。比如按部门升序、分数降序:
key=lambda x: (x.dept, -x.score)。
如果需要降序的字段是字符串,无法直接加负号取反。此时可以利用 Python 排序算法的稳定性(Stable Sort)——即当两个元素键值相同时,保留原有的先后相对顺序。按照“由次到主、反向应用”的规则分步执行:
# 需求:部门 dept 升序,城市 city 降序(字符串无法直接取负)
records = [
    {"dept": "Dev", "city": "Beijing"},
    {"dept": "Dev", "city": "Shanghai"},
    {"dept": "HR",  "city": "Guangzhou"}
]

# 第一步:先对次级关键字 city 进行降序排序
records.sort(key=itemgetter("city"), reverse=True)

# 第二步:再对主要关键字 dept 进行升序排序(依赖稳定排序,相同 dept 内部保留第一步的 city 降序)
records.sort(key=itemgetter("dept"), reverse=False)

# 最终结果:
# [{'dept': 'Dev', 'city': 'Shanghai'},
#  {'dept': 'Dev', 'city': 'Beijing'},
#  {'dept': 'HR', 'city': 'Guangzhou'}]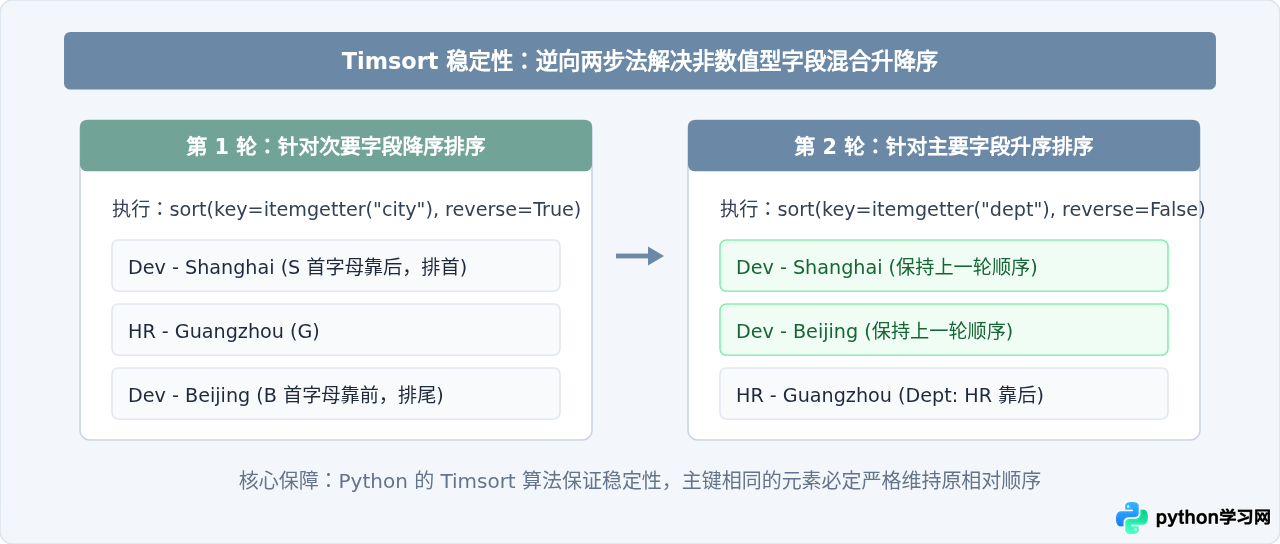
四、特殊复杂规则与遗留兼容方案
1. 条件权重分组(布尔值优先排序)
在 Python 中,布尔类型 bool 是整数的子类,False == 0 且 True == 1。利用这个特性,可以轻松实现“置顶功能”或“无效空值沉底”:
items = [
    {"id": 1, "is_pinned": False, "score": 90},
    {"id": 2, "is_pinned": True,  "score": 60},
    {"id": 3, "is_pinned": False, "score": 95}
]

# 需求:置顶项(is_pinned=True)排在最前,之后按 score 降序
# 注意:True 对应 1,False 对应 0;为了让 True 排前,使用 not 或在降序中比较
items.sort(key=lambda x: (not x["is_pinned"], -x["score"]))

# 排序后结果:ID 2 置顶排第1位,即使其分数只有 60 分
2. 遗留比较函数适配:functools.cmp_to_key
某些历史业务逻辑包含复杂的双对象比较规则(例如接受 a 和 b,返回负数、0 或正数)。Python 3 移除了 cmp 参数,但标准库通过 functools.cmp_to_key 提供了完整的兼容转换器:
from functools import cmp_to_key

def custom_comparator(a, b):
    # 复杂的业务逻辑:特定 VIP 优先,否则按普通逻辑
    if a.is_vip and not b.is_vip:
        return -1  # a 优先,排在前面
    elif not a.is_vip and b.is_vip:
        return 1   # b 优先
    # 平局时比对创建时间
    return (a.created_at > b.created_at) - (a.created_at < b.created_at)

# 通过 cmp_to_key 转换为合法的 key 函数
sorted_users = sorted(users, key=cmp_to_key(custom_comparator))cmp_to_key 内部通过创建轻量包装类(代理实现 __lt__、__gt__ 等比较方法),会在每次比较时执行 Python 层代码。其时间开销显著高于原生提取代理键,建议优先采用元组代理键。
五、选型与排查总结
在编写自定义排序时,可以参考以下决策路径来选择最精简、高效的 key 参数实现形式:
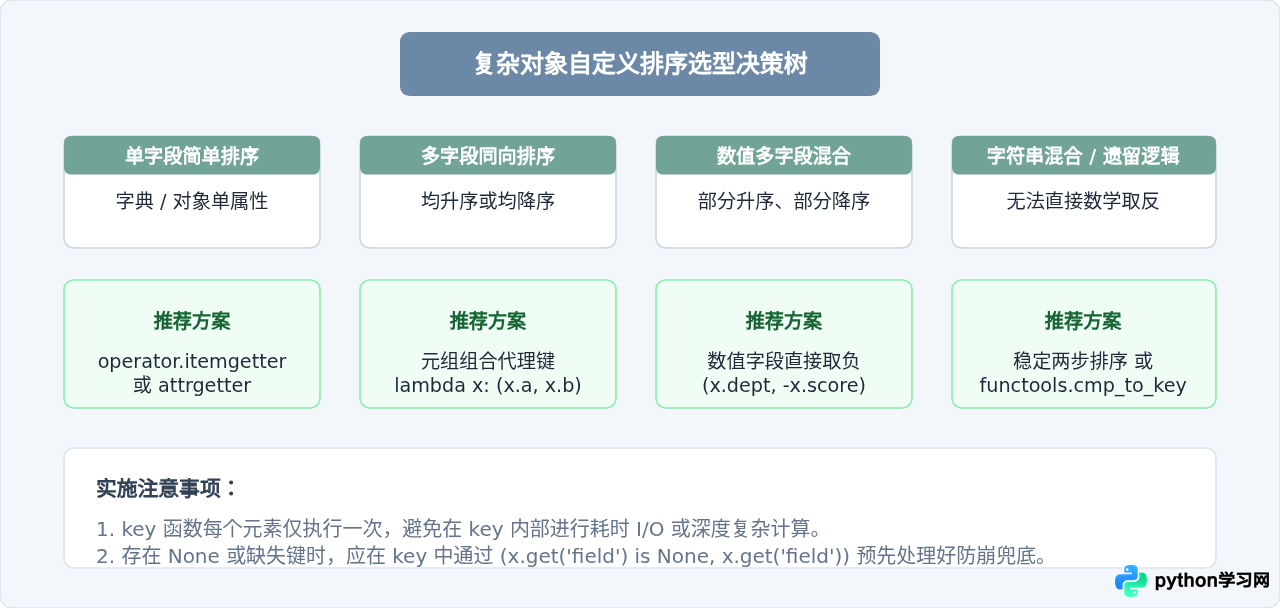
最后提醒:空值(None)的安全处理
在 Python 3 中,None 与整数或字符串进行大小比较(如 None < 10)会直接引发 TypeError。若被排序对象中存在可能为 None 的属性,可以通过元组设置首要标记位,强制将空值排在末尾:
data = [{"id": 1, "val": 10}, {"id": 2, "val": None}, {"id": 3, "val": 5}]

# 将 None 强制排在最后:首项 (d["val"] is None) 为 True(即 1),非 None 为 False(即 0)
sorted_data = sorted(data, key=lambda d: (d["val"] is None, d["val"]))
# 排序结果:val 为 5 -> val 为 10 -> val 为 None本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















