


Python怎么避免无限循环及迭代中修改列表的报错

在 Python 开发中,循环结构是控制流程的基石,但“陷入无限死循环”与“遍历时修改列表引发异常或逻辑缺陷”是两类高频发生的典型错误。解决死循环的核心是为循环状态迁移建立确定的单向收敛条件与熔断计数;而安全修改列表的关键,则是避免打破底层迭代器的内部游标偏移机制,优先通过列表推导式、切片赋值或逆序遍历来保证状态隔离。
一、迭代中修改列表:静默跳项与索引越界的成因
许多开发者在需要剔除列表中符合特定条件的元素时,会直觉性地写出如下代码:直接在 for item in my_list 循环体内调用 my_list.remove(item),或者根据下标执行 del my_list[i]。这类操作往往会导致两种典型问题:
- 静默漏项(逻辑错误):程序完全不抛出异常,但部分符合删除条件的元素被完好保留,产生不可预期的脏数据。
- 索引越界(RuntimeError/IndexError):如果基于
range(len(my_list))遍历,列表长度因删除而动态缩水,而循环预设的索引上限依然按原长度递增,最终抛出IndexError: list index out of range。
# 典型错误示例 1:连续目标元素被静默跳过
numbers = [10, 20, 20, 30, 40]
for num in numbers:
    if num == 20:
        numbers.remove(num)
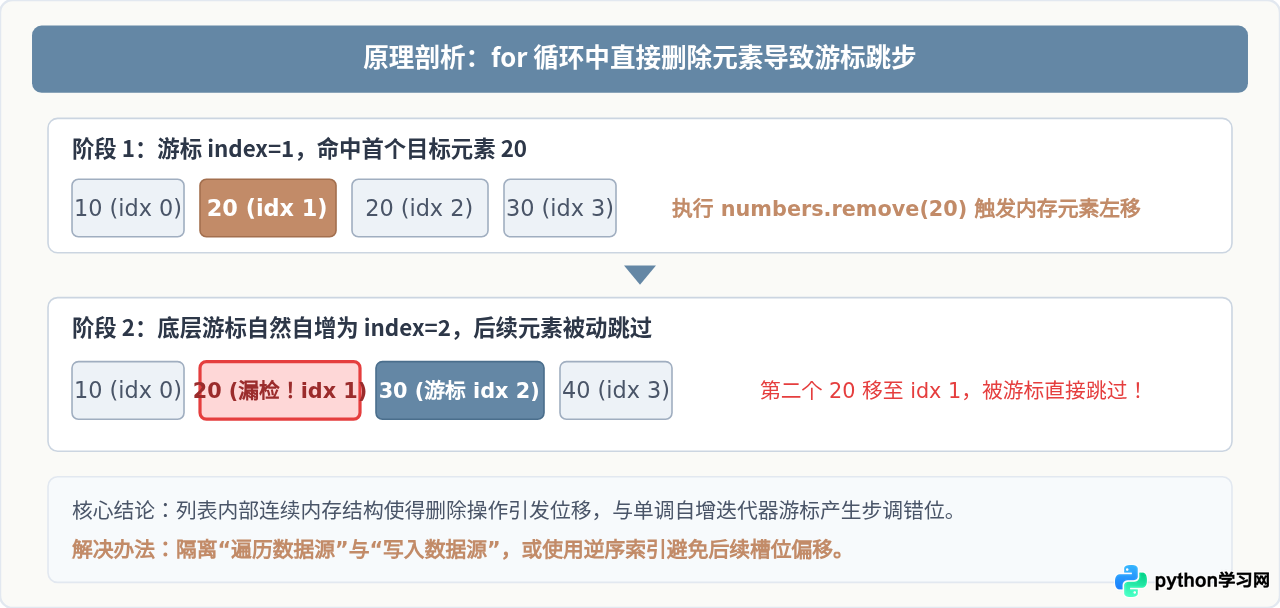
print(numbers)  # 实际输出仍为: [10, 20, 30, 40],第二个 20 未被删除
这一现象的底层机制在于:Python 的 for 循环本质上是通过内置迭代器工作的。迭代器内部维护了一个递增的整数游标(Cursor),初始为 0,每轮循环后递增 1。当在索引 1 处删除了元素 20 时,其后方的所有元素在内存中向前平移一位,原索引 2 处的第二个 20 自动滑到了索引 1。下一轮循环时游标自增到 2,指向了元素 30,从而使移入索引 1 的目标元素被完全跳过。
二、安全修改正在迭代的列表:四大稳健解决方案
要彻底消除迭代修改列表导致的异常与逻辑漏洞,通常有四种成熟且标准的技术手段。开发者应依据“是否需要保持原对象引用”以及“数据体量”来选用最佳策略。
方法 1:列表推导式(强烈推荐,Pythonic 实践)
在大多数场景下,最清晰、高效的做法并非“删除不需要的项”,而是“筛选保留需要的项”。通过列表推导式或内置的 filter 函数构建新列表,完全避开迭代冲突:
numbers = [10, 20, 20, 30, 40]
# 仅保留不等于 20 的数值,生成新的列表对象
filtered_numbers = [num for num in numbers if num != 20]
print(filtered_numbers) # 结果: [10, 30, 40]numbers = [...] 会使变量绑定至新对象,而其他引用仍保持原样。若需在不改变原列表内存地址(即 id(numbers) 不变)的前提下原地更新,使用全切片语法:
numbers[:] = [num for num in numbers if num != 20]方法 2:遍历列表副本(浅拷贝)
若业务逻辑中必须在循环体内执行针对原列表的 remove() 或自定义操作,可以通过切片 numbers[:] 或 list(numbers) 产生一个浅拷贝副本。通过副本驱动游标,在原列表上执行变更:
numbers = [10, 20, 20, 30, 40]
# numbers[:] 创建了一份独立的浅拷贝用于迭代
for num in numbers[:]:
    if num == 20:
        numbers.remove(num)
print(numbers)  # 结果: [10, 30, 40] 完全正确
方法 3:逆序索引遍历(原地物理删除)
在空间受限或超大列表不宜克隆的场景下,可以采用逆序遍历方式:从列表末尾向前推进(即从 len(lst)-1 降序遍历至 0)。因为删除某个索引位置的元素时,只会引起其右侧(已遍历过)元素的向前位移,而左侧未遍历元素的索引完全不受影响:
numbers = [10, 20, 20, 30, 40]
# 步长为 -1,逆序遍历索引
for i in range(len(numbers) - 1, -1, -1):
    if numbers[i] == 20:
        del numbers[i]
print(numbers)  # 结果: [10, 30, 40]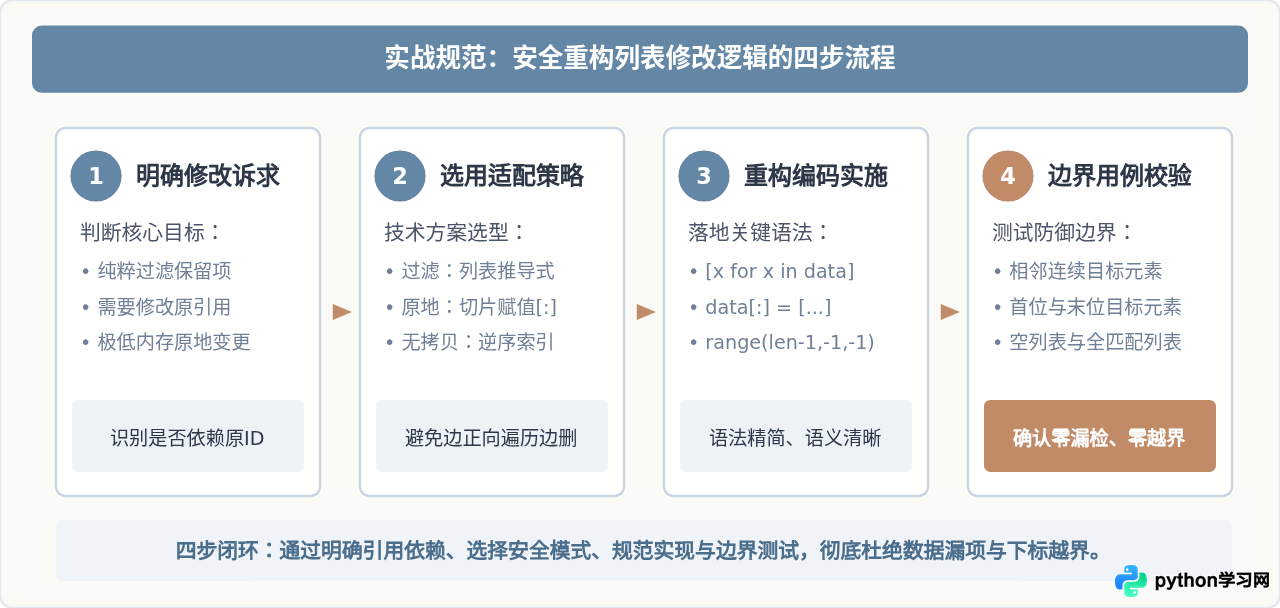
三、避免 While 无限循环:根源排查与防御式编码
无限循环(死循环)的本质,是循环继续执行的前提条件在运行时永远无法转化为 False,或者循环体内无法触达退出指令(如 break 或 return)。在实际项目中,死循环往往由以下三类隐蔽失误导致:
1. 步进更新语句被跳过(分支控制疏漏)
在循环体内使用 continue 语句时,若状态递增语句位于其后方,会导致循环变量永久停滞:
# 错误示例:continue 提前中断,跳过了 index 自增,陷入死循环
index = 0
while index < 10:
    if index % 2 == 0:
        continue  # 此处直接进入下一轮循环,下方 index += 1 永远不被执行!
    print(index)
    index += 1
2. 浮点数精度等值比对导致无法命中终止条件
计算机二进制浮点数在表示十进制小数时存在精度损耗。编写类似 while current != 1.0 的代码时,由于累计加法产生类似 0.9999999999999999 的微小误差,将永远无法严格等于 1.0:
# 危险写法:浮点数累加难以精确对齐
val = 0.0
while val != 1.0:
    val += 0.1  # 累加后实际为 0.9999999999999999,下一跳即超 1.0,直接死循环
3. 防御式安全重构:熔断计数器与安全边界
为了从机制上杜绝无限死循环,推荐在无法完全依赖单调有界迭代器时,为 while 循环增加最大迭代阈值熔断机制(Safety Guard Counter):
# 防御式模板:引入熔断计数器保证有界终止
MAX_LIMIT = 1000
step = 0

while condition_evaluating():
    step += 1
    if step > MAX_LIMIT:
        raise RuntimeError("循环执行超出安全阈值,触发保护熔断!")

    # 正常业务处理
    do_something()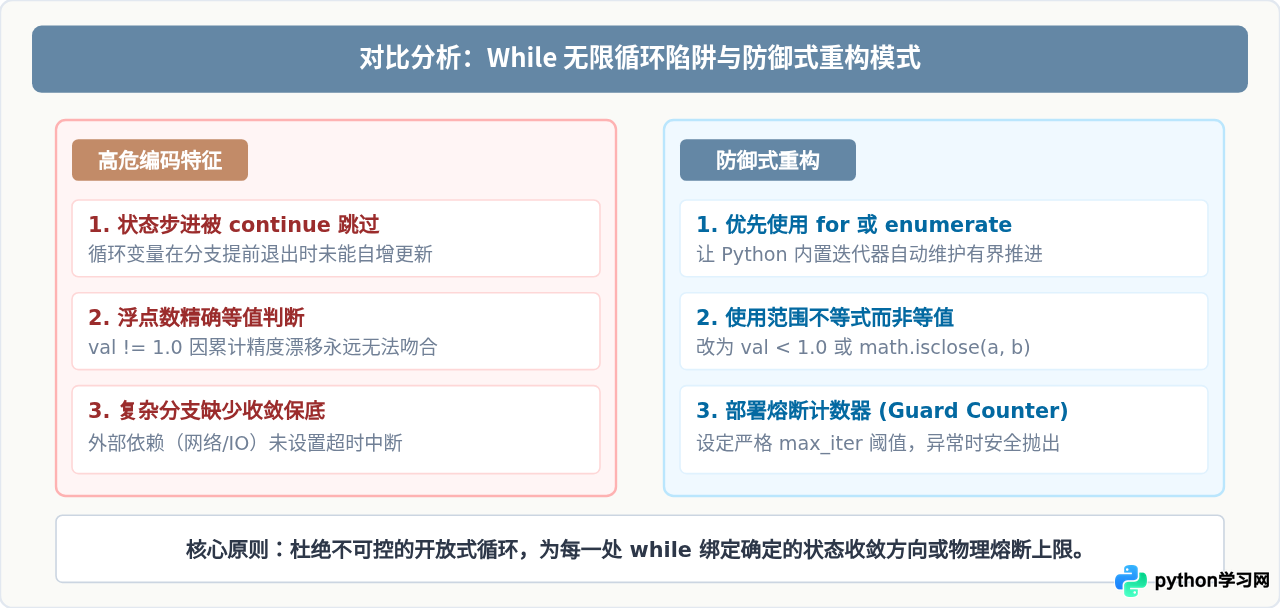
四、场景选型与避坑速查决策指南
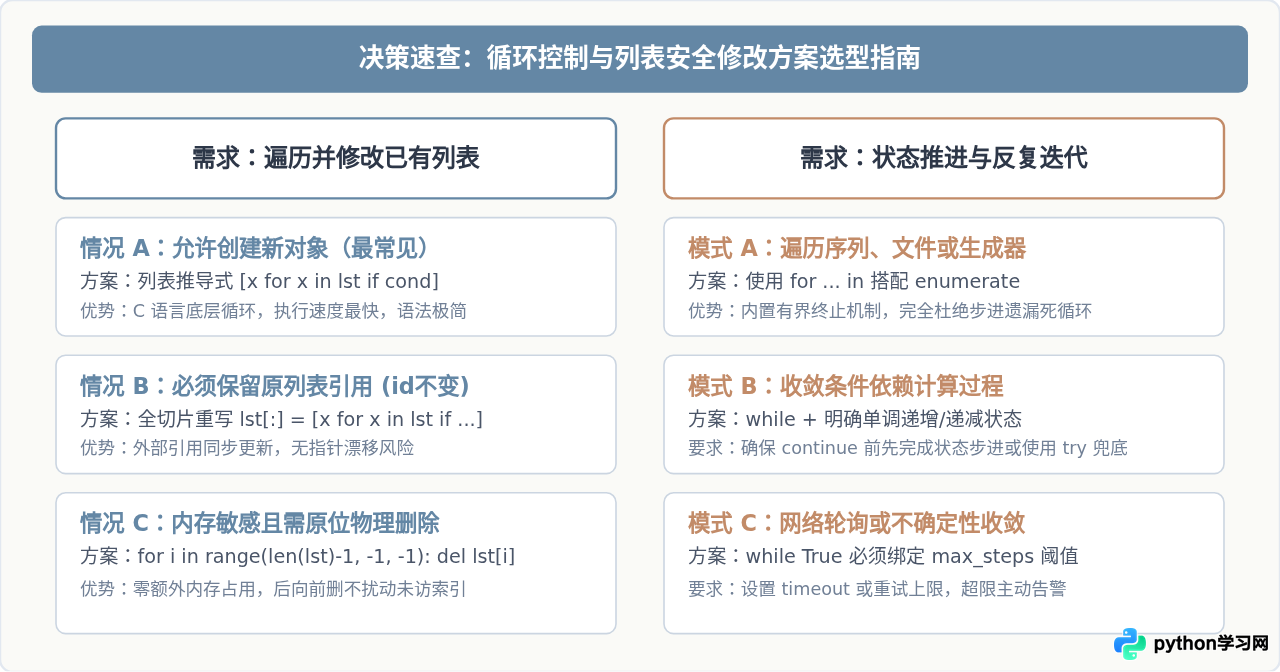
在编写生产环境代码时,可以参考以下决策路径快速选择对应的循环模式与列表修改技术,既兼顾运行性能,又彻底杜绝死循环与数据状态污染:
常见疑难问题解答 (FAQ)
Q:为什么在 Python 字典中边遍历边删除会直接抛出 RuntimeError,而列表却不报错只是漏项?
A:Python 字典设计了专门的防并发修改保护。字典迭代器在初始化时会记录当前字典的修改版本号计数器(mutation count)。在每一步 next() 调用时,如果检测到字典长度或版本发生改变,会立刻主动抛出 RuntimeError: dictionary changed size during iteration。而列表(List)为了追求极限的下标寻址性能,内置的 list_iterator 仅简单维护游标偏移,并不检查整体长度变化,因此导致操作被放行却产生静默跳项的恶性 Bug。
Q:大列表使用切片浅拷贝 numbers[:] 是否会有内存压力?
A:对于包含百万级以上元素的大列表,numbers[:] 会在内存中开辟一个新的连续指针数组,带来额外的内存消耗。在此类对资源敏感的场景下,优先推荐列表推导式配合生成器,或者采用逆序索引遍历(range(len-1, -1, -1))进行原地删除,避免整表拷贝带来的开销。
五、总结
避免 Python 中的无限循环与列表迭代异常,其核心在于控制流动向的确定性与内存状态读写的相互隔离。对于循环推进,优先依赖 for 的自动迭代特性,确需使用 while 时务必配置安全熔断步数与边界不等式;对于列表修改,切忌“边正向走游标、边原位改结构”,通过推导式过滤生成新列表或逆序索引删除,便可在编写清爽优雅代码的同时,彻底远离偶发性数据异常与程序假死。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















