


RAG知识库是什么:原理、架构与核心作用解析

大语言模型虽然强大,但面对企业内部私有数据或最新发生的新闻时,往往显得“力不从心”。RAG(检索增强生成)知识库正是为了解决这一痛点而生。它不改变模型本身的参数,而是像给大脑配了一本随时可查的参考书,让AI在回答问题前先“查阅资料”,从而给出基于事实的精准回答。
这种机制最直接的好处是显著降低了模型的“幻觉”概率,同时确保了回答的时效性和安全性。用户无需重新训练昂贵的模型,只需挂载更新的知识库,即可让AI掌握最新业务动态。
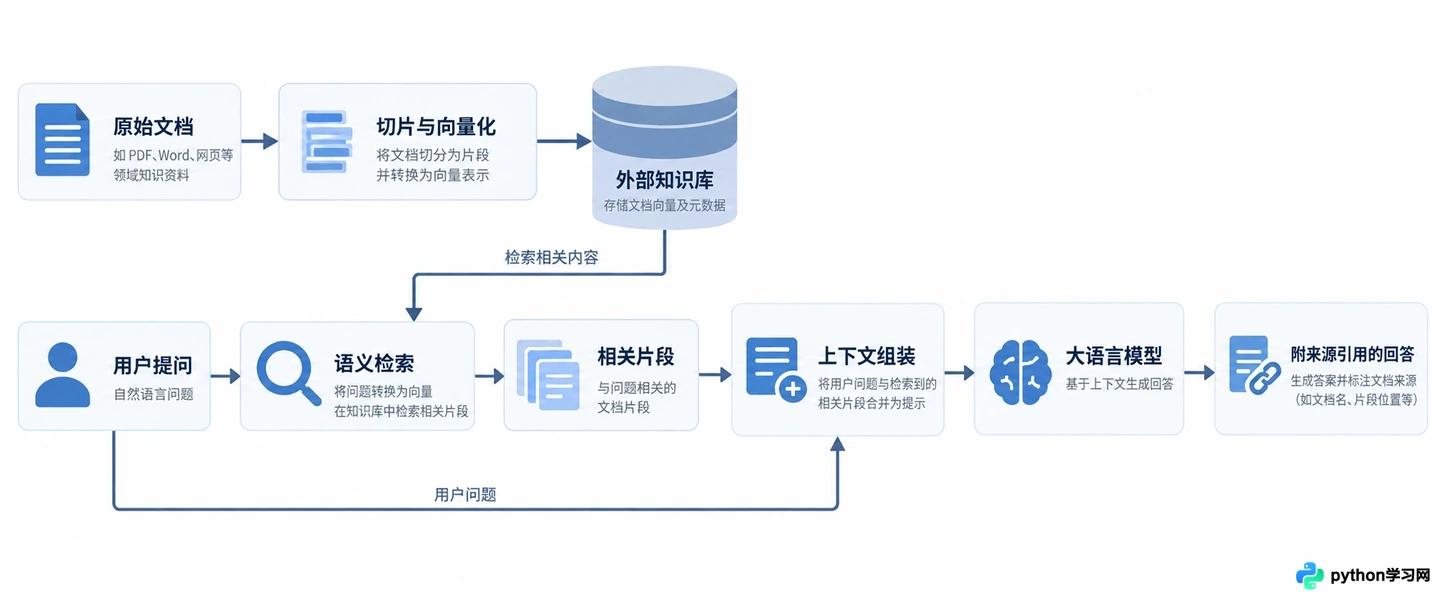
RAG系统通过检索外部知识库增强大模型生成能力的流程概览
要理解RAG,只需把握一个核心逻辑:它将传统的“记忆式”回答转变为“开卷考试”。模型不再依赖训练时固化的权重,而是动态地从外部知识库中检索相关片段,将其作为上下文输入,再生成最终答案。
准备构建或理解一个基础的RAG系统,通常需要三个要素:非结构化或结构化的原始数据源、向量数据库用于存储和检索语义信息、以及具备推理能力的大语言模型接口。
1. 数据清洗与分块处理
RAG的第一步并非直接搜索,而是将原始文档转化为机器可理解的片段。选中需要入库的企业文档、PDF或网页内容,进入数据处理管道。
在此阶段,关键动作是“分块”(Chunking)。由于大模型有上下文窗口限制,且过长的文本会稀释关键信息,需将长文档切割为固定长度(如500-1000字符)的重叠片段。重叠部分能保留段落间的语义连贯性,避免切断关键句子。
观察此时的变化:原本连续的长篇报告变成了数千个独立的文本小块,每个小块都携带了原始的元数据(如来源文件、页码),这是后续溯源的基础。
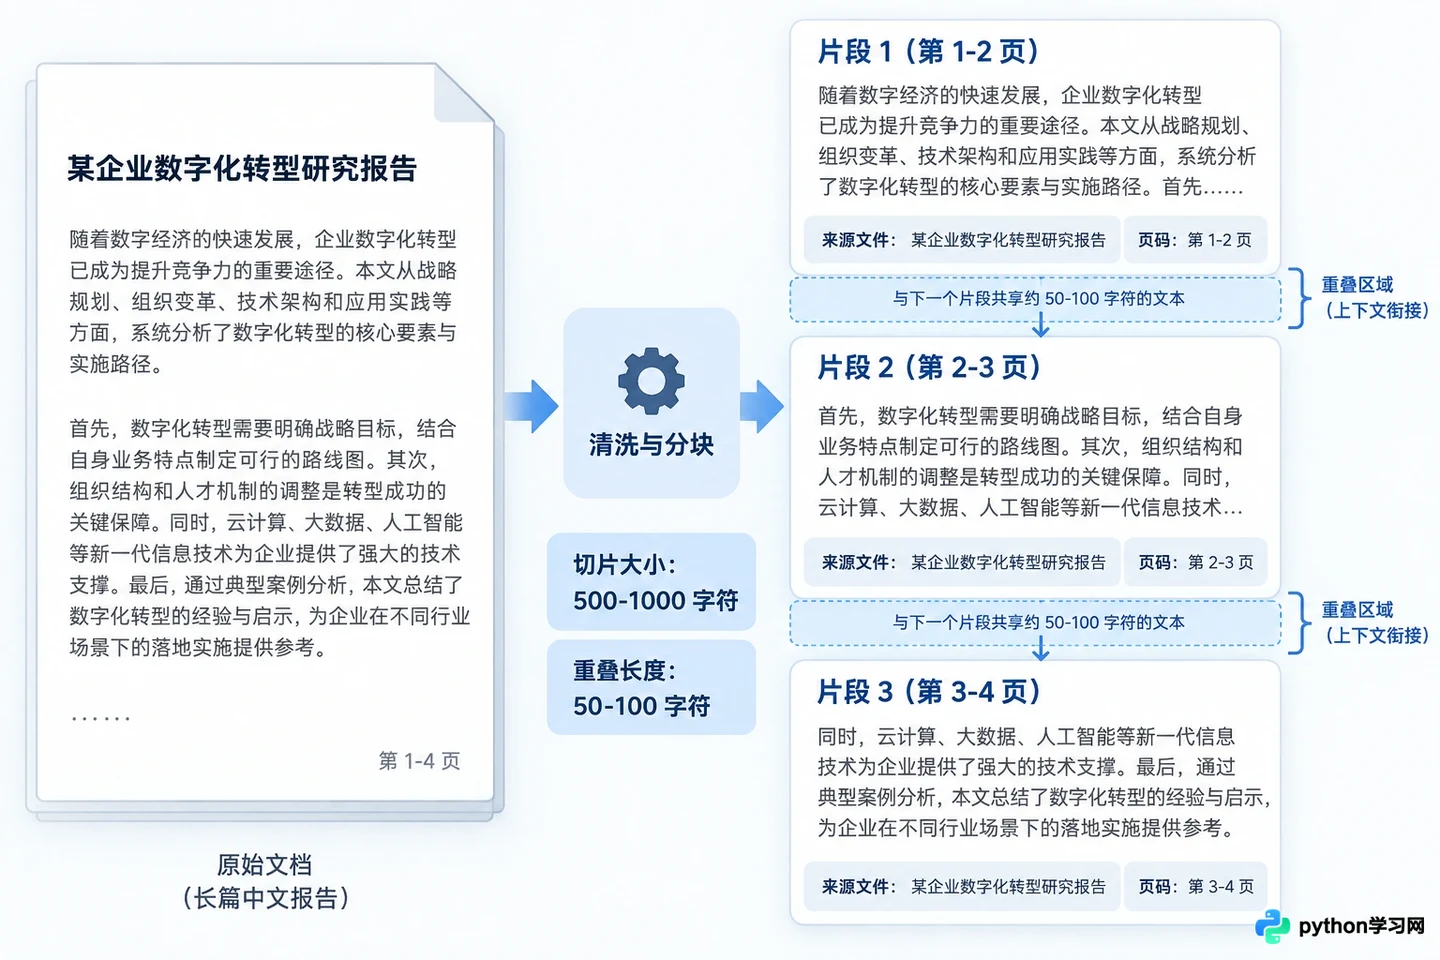
1. 数据清洗与分块处理
2. 向量化嵌入与存储
接下来,将这些文本小块转化为数学向量。调用嵌入模型(Embedding Model),对每个文本块进行编码。嵌入模型会将语义相似的文本映射到向量空间中距离相近的位置。
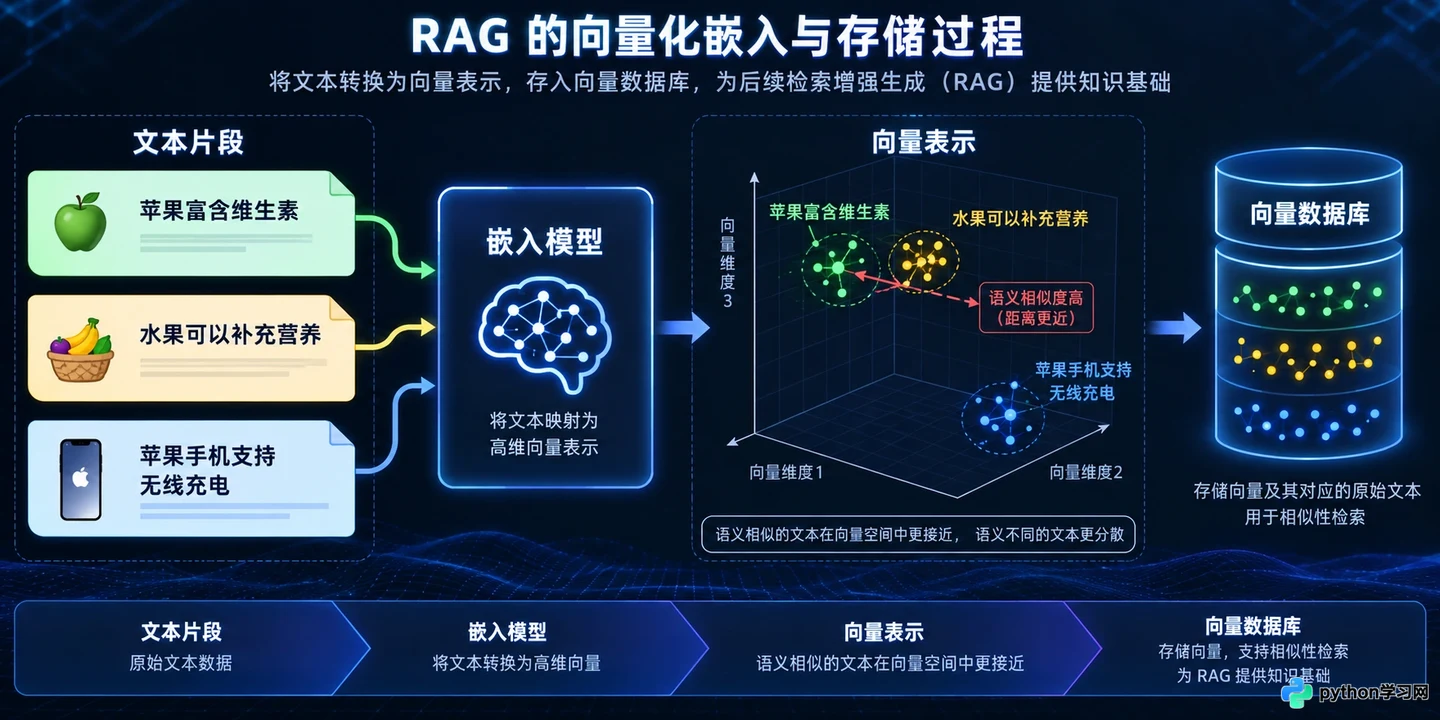
文本分块经过嵌入模型转化为向量并存入数据库的过程
设置向量数据库(如Milvus、Faiss或Pinecone)接收这些高维向量。当存入操作完成后,数据库中不再是明文,而是一系列数值数组及其对应的原始文本索引。这一步决定了检索的精度,高质量的嵌入模型能确保“苹果”和“水果”在空间上比“苹果”和“手机”更接近。
3. 语义检索与相关性排序
当用户提出问题时,系统首先对问题进行同样的向量化处理。进入检索模块,计算问题向量与数据库中所有向量余弦相似度。
设置返回顶部的K个最相似片段(例如Top-5)。此时可见的变化是:系统从海量数据中迅速锁定了与问题语义最相关的几段文字,即使它们没有包含完全相同的关键词。例如搜索“报销流程”,系统能找回包含“费用提交规范”的段落。
为了提升精度,常引入重排序(Rerank)步骤。对初筛出的片段进行更精细的相关性打分,剔除噪声,确保送入模型的上下文高度纯净。
4. 提示词组装与生成
这是RAG的“增强”环节。将检索到的相关片段、用户原始问题以及系统指令组装成一个完整的Prompt(提示词)。
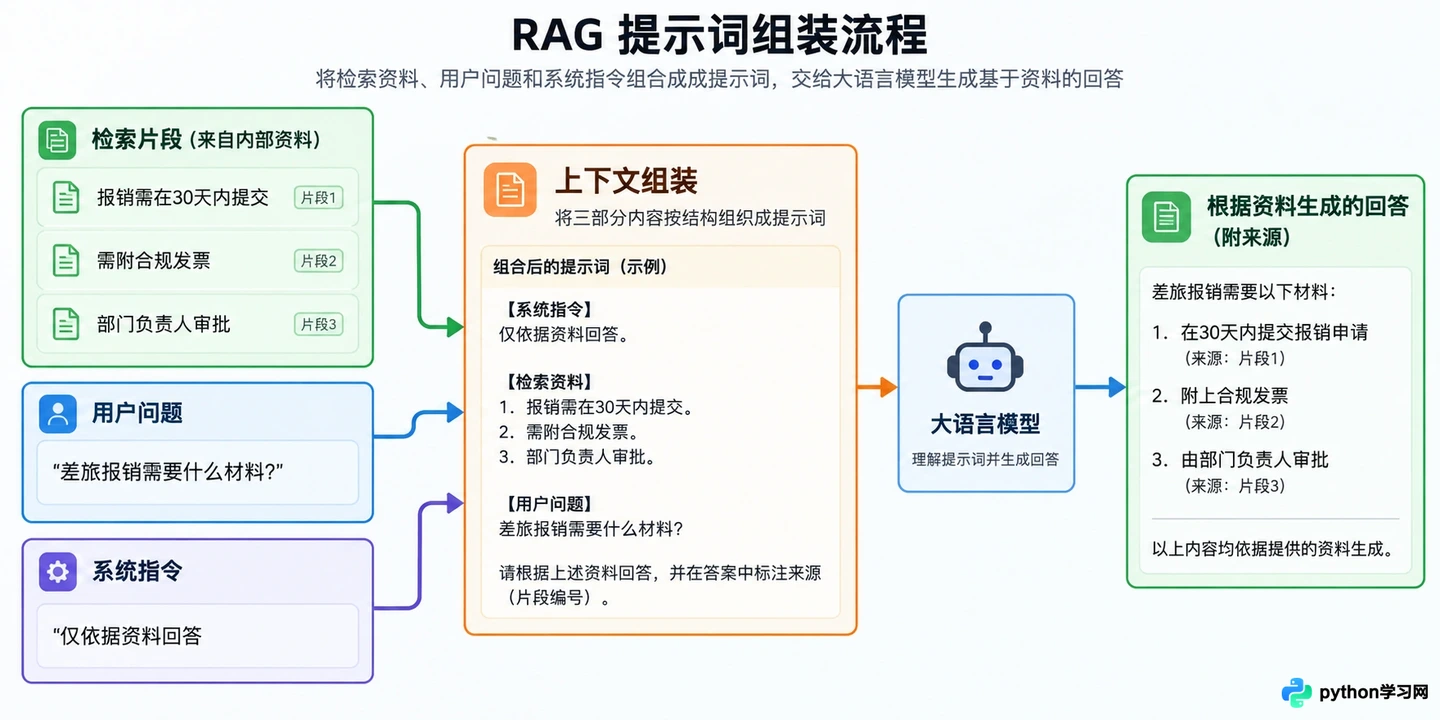
系统将检索内容与用户问题组合成完整Prompt的示意
典型的提示词结构为:“请根据以下参考资料回答问题:[检索片段1]...[检索片段N]。用户问题:[用户提问]。如果资料中无答案,请如实告知。”
将此Prompt发送给大语言模型。模型基于提供的“参考资料”进行推理生成。观察输出结果:回答不仅准确,而且通常会引用资料来源,避免了模型凭空捏造。
5. 效果验证与迭代优化
最后一步是验证RAG系统的实际表现。输入几个典型业务问题,检查回答是否忠实于知识库内容。
若发现回答不准确,需回溯检查:是检索没找到相关片段(需优化分块或嵌入模型),还是模型忽略了上下文(需调整Prompt策略)。RAG的优势在于可解释性强,每一步都可独立调试,无需像微调模型那样黑盒摸索。
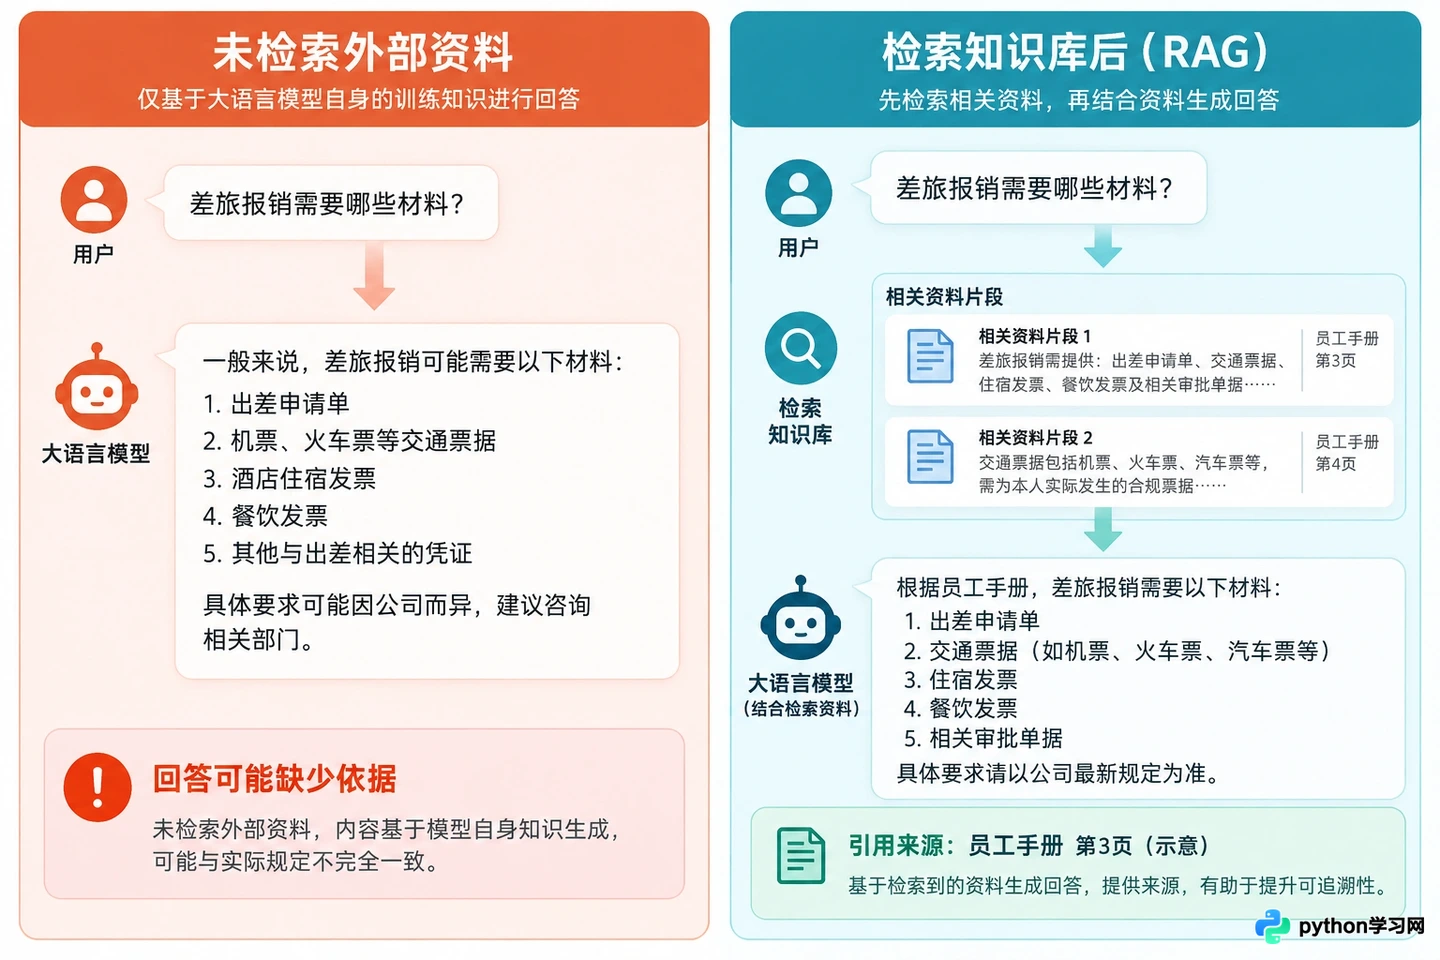
传统LLM与RAG增强后回答准确性的对比展示
通过这种架构,企业可以快速构建专属的智能客服、文档助手或代码查询工具。知识库的更新只需重新执行数据入库流程,分钟级即可生效,真正实现了AI能力的敏捷迭代。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















