



在 LLM 应用开发里,很多人先接触的是 LangChain:上手快、组件全、能很快把模型调用跑起来。但项目一旦进入多轮交互、回退重试、共享状态这些阶段,线性链路往往开始变得别扭。本文就围绕这个常见分界点,把 LangChain 和 LangGraph 的定位、差异和选型标准拆开讲清楚,帮助你根据流程形态而不是热度来判断该用哪一个。
为什么开发一复杂,LangChain 就容易显得吃力
先看一个很典型的需求:做一个客服机器人。用户不只是提一次问题就结束,而是会不断追问、修正之前的表述,系统还要保留上下文,并在特定条件下能够“回到上一步”重新生成答案。
这类需求放到简单演示里不难,难的是流程开始分叉以后怎么继续维护。如果只用 LangChain,你通常会把流程写成一条往前走的链:定义 Prompt、调用模型、返回结果,流程就结束了。即便 LangChain 也提供了 Memory 模块,面对真正的多轮交互、状态回溯和条件分支时,这种以线性推进为核心的写法还是容易出现结构别扭的问题。
LangGraph 出现,正是为了解决这一层复杂度。它是 LangChain 生态中的核心组件,专门面向有状态、多步骤的复杂工作流。更关键的是,LangChain 的 Agent 本身就是建立在 LangGraph 之上的。这意味着 LangGraph 不是一个“可有可无的扩展件”,而是更底层的编排基础设施。
LangChain 解决的,首先是“把大模型应用搭起来”
LangChain 本质上是一个 LLM 应用开发框架。它把模型调用、Prompt 组织、工具接入、向量检索等常见能力做了统一封装,让开发者不用从头处理大量重复性工作。
它常见的核心模块包括:模型调用层(统一接口)、Prompt 模板(动态拼接)、Chains(链式组合)、Memory(记忆存储)、Tools(工具调用)、Agents(自主决策)。
如果把问题说得更直接一点,LangChain 主要解决的是“怎样更方便地调用大模型,并把常见能力拼起来”。对于很多轻量应用,这已经足够。
在 Go 语言里,一个常见实现是 github.com/tmc/langchaingo。下面这段示例就很典型:初始化模型,发起一次 Prompt,请求结果并输出。
package main

import (
    "context"
    "fmt"
    "log"

    "github.com/tmc/langchaingo/llms"
    "github.com/tmc/langchaingo/llms/openai"
)

func main() {
    llm, err := openai.New()
    if err != nil {
        log.Fatal(err)
    }

    ctx := context.Background()
    completion, err := llms.GenerateFromSinglePrompt(ctx, llm, "用一句话介绍 Go 语言")
    if err != nil {
        log.Fatal(err)
    }

    fmt.Println(completion)
}
这类场景里,LangChain 的优势非常明显:结构简单,开发速度快,适合快速完成单轮问答、摘要、翻译、基础 RAG 检索或简单工具调用。
LangGraph 的重点,是把流程当作图来编排
和链式调用不同,LangGraph 的核心抽象是一张图。图中的节点代表操作单元,边代表节点之间的流向。这里要先澄清一个常见误解:LangGraph 并不是必须依赖 LangChain 才能运行,它可以独立使用;但在 LangChain 生态中,它承担着 Agent 持久化、流式输出、人机交互等能力的底层职责。
这种图结构带来了几项非常关键的能力。
节点可以承载任意操作
每个节点既可以是一次模型调用,也可以是一次工具执行,或者一段完全自定义的业务逻辑。也就是说,LangGraph 不是只为“调用模型”而设计,而是为“组织步骤”而设计。
边可以表达顺序,也可以表达条件
节点之间的连接不只有固定流向,还可以根据状态决定下一步去哪里。普通边适合稳定流程,条件边适合判断分支。
循环是原生能力,不需要额外绕路
这是 LangGraph 与 LangChain 最容易拉开差距的地方。很多 Agent 场景并不是“一次生成就结束”,而是“生成、检查、修正、再生成”的反复过程。LangGraph 允许一个节点自然地回到之前的节点,把循环写成流程本身的一部分。
共享状态让多步骤协作更自然
在 LangGraph 里,每一步都可以读写同一份共享状态。这样多个节点围绕同一份上下文工作时,数据不会只能靠函数参数和返回值层层传递,流程会更清晰,也更适合后续维护。
相比之下,用 langchaingo 写出的链式调用通常是线性流程:前一步产出,喂给后一步继续执行。这个模式在简单任务上很好用,但一旦需求变成“模型反复思考直到满意”,链式结构就容易开始失去表达力。
两者真正的差别,不在名词,而在编程模型
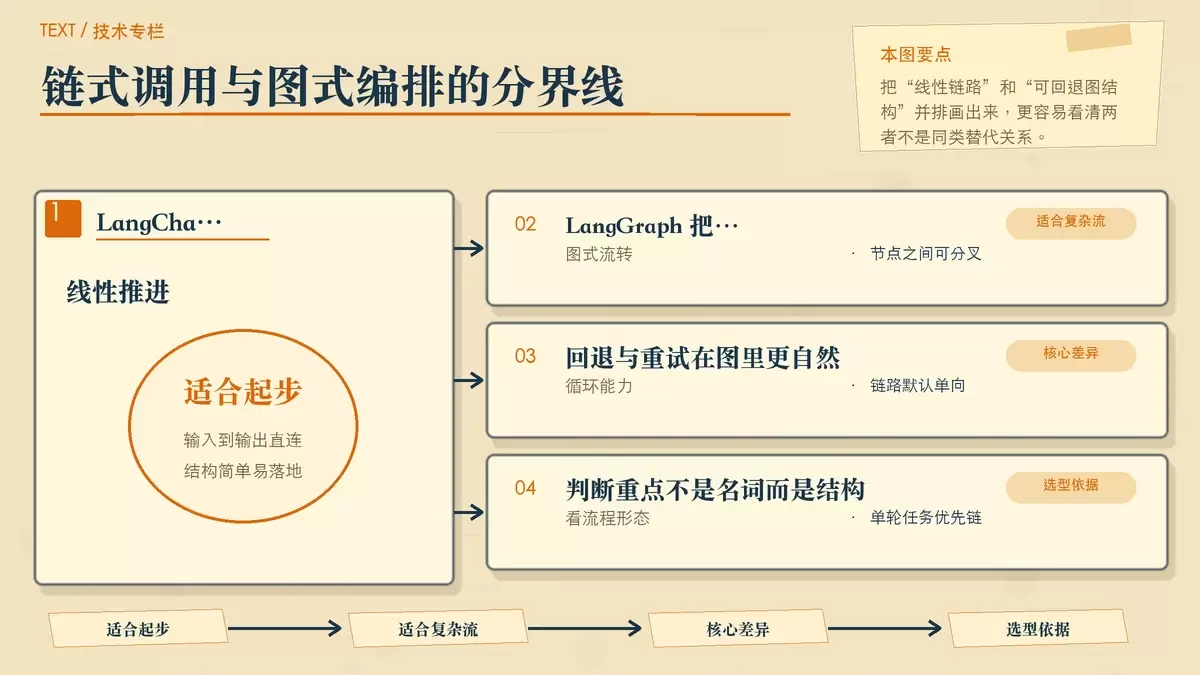
很多人会把 LangChain 和 LangGraph 当成两个平行框架来比较,但更准确的理解方式,是看它们各自适合承载什么样的流程结构。
1. 编程模型不同
LangChain 更接近链式调用,适合从输入一路走到输出的线性流程。LangGraph 则是图结构,更适合存在分支、回退、重试和多路径收敛的网状流程。
2. 状态管理方式不同
LangChain 里的状态传递,主要还是依赖函数参数、返回值以及附加的 Memory 机制。LangGraph 提供共享状态对象,多个节点可以围绕同一份数据做协同更新,这对复杂工作流尤其重要。
3. 循环处理能力不同
这是最核心的一条。LangChain 的 LCEL 管道本质上是单向推进的,想写循环通常需要额外封装控制逻辑。LangGraph 原生支持循环,因此像“自我反思直到达到条件”“检查失败则返回修改”这类模式,会自然得多。
4. 适用场景不同
如果你的目标是单轮问答、基础 RAG、简单工具调用,或者希望尽快验证一个 LLM 应用原型,LangChain 往往更合适。如果你面对的是复杂 Agent、多轮决策、需要回退机制的交互系统,或者对持久化和流式输出有更高要求,LangGraph 会更贴近生产环境的需求。
选型怎么判断:先看流程是不是“会拐弯”
实际选型时,与其先问“哪个更先进”,不如先问业务流程长什么样。
如果你的应用基本是“一问一答”式,比如翻译、总结、文案生成,直接用 LangChain 往往最省事,结构简单,开发效率也高。
如果你的应用需要多轮对话、持续记住上下文、根据当前结果动态决定下一步,那就应该优先考虑 LangGraph。因为这时问题已经不只是“调用模型”,而是“管理流程”。
再进一步,如果你的应用需要反复执行某个步骤,直到结果满足条件,例如“让模型生成代码,不满意就重新生成”,这类循环机制就是 LangGraph 的典型主场。
对于还拿不准的项目,一个务实的做法是先用 LangChain 快速验证核心思路。等你明确发现线性流程开始束手束脚,再迁移到 LangGraph。这样既不会过早设计,也能避免项目后期被错误抽象拖累。
实战场景:论文评审 Agent 为什么更适合用 LangGraph
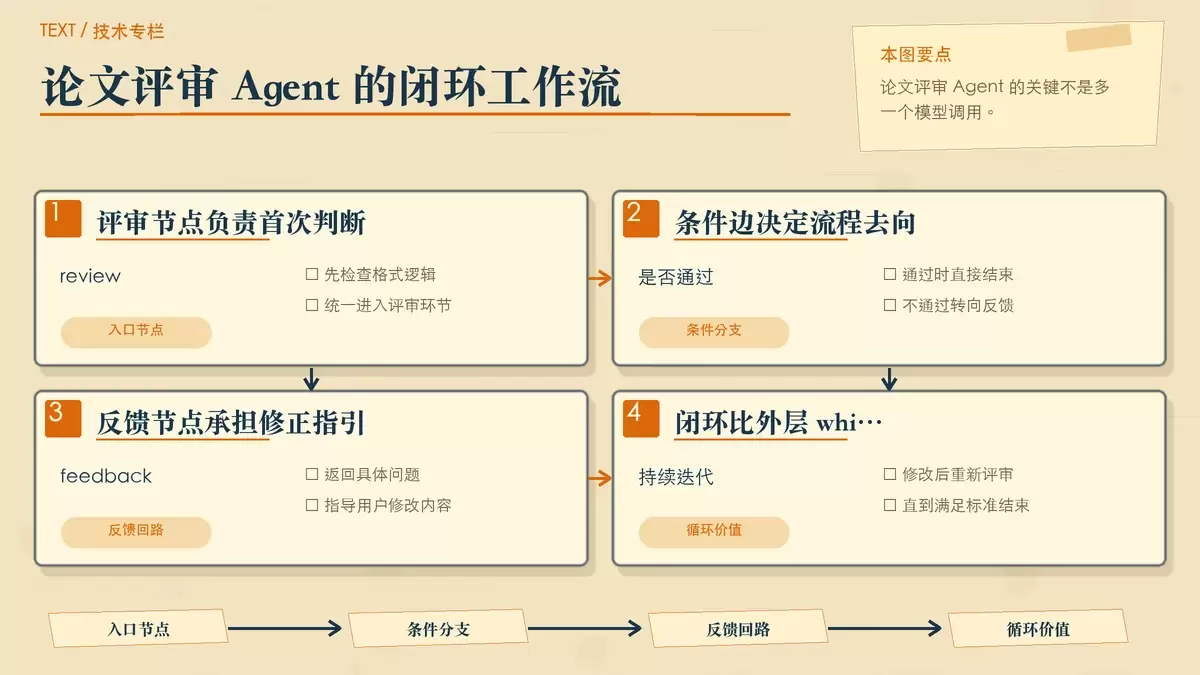
看一个更具体的例子:实现一个“论文评审 Agent”。需求是把论文交给 AI,检查格式、逻辑和创新点;如果发现问题,就反馈给用户修改;修改后再进入下一轮检查,直到论文符合标准。
这个场景的关键,不在于模型能不能评审,而在于流程天然是一个“检查—反馈—修改”的闭环。若用 LangChain 实现,你往往需要在外部再套 while 循环来驱动重试,模型调用、判断逻辑和流程控制会被拆散,代码很容易越写越碎。
换成 LangGraph,流程就能直接画成一张图:检查节点负责判断,条件边决定是否结束,不通过则流转到反馈节点,再回到检查节点继续下一轮。
// LangGraph 工作流伪代码
workflow := NewStateGraph(ReviewState{})

workflow.AddNode("review", reviewNode)
workflow.AddNode("feedback", feedbackNode)

workflow.SetEntryPoint("review")
workflow.AddConditionalEdges("review",
    func(state ReviewState) string {
        if state.IsApproved {
            return END
        }
        return "feedback"
    },
)
workflow.AddEdge("feedback", "review")

app := workflow.Compile()
这段伪代码的价值,不只是“能运行”,而是它把流程结构直接表达出来了:入口在哪里、判断在哪里、回路怎么走、结束条件是什么,都一眼能看明白。对于需要多人维护、后续还会继续扩展的 Agent 系统,这种可视化的编排思路通常比拼接链式调用更稳。
结论:LangChain 负责上手速度,LangGraph 负责复杂流程
可以把两者的关系理解为互补,而不是替代。LangChain 降低了 LLM 应用开发门槛,让你能快速把模型、Prompt、检索和工具串起来;LangGraph 则在此基础上,提供了处理复杂工作流所需的图结构、循环和共享状态能力。
真正决定选型的,不是项目是不是“Agent”,而是你的流程里有没有循环、有没有多步骤状态要保留、有没有条件分支和回退路径。没有这些时,LangChain 足够直接;一旦这些需求成为主角,LangGraph 往往才是更合理的底层结构。















