


Python递归遍历文件夹获取所有子文件的方法

一、递归遍历的核心机制与目录树模型
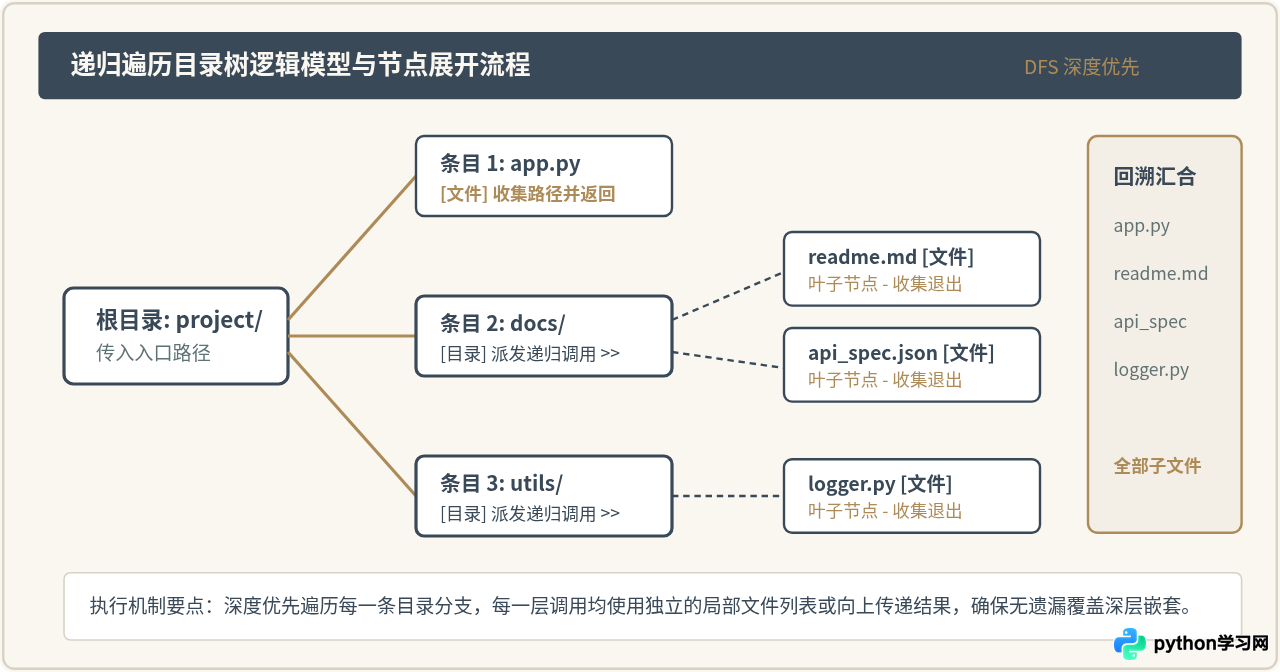
文件系统在逻辑结构上表现为典型的树状分形结构(Directory Tree)。根文件夹对应树的根节点,下属的普通文件是叶子节点,而下属的子文件夹则是内部子节点。
递归算法解决该问题的优势在于逻辑高度对齐树结构。递归过程由两个核心要素驱动:
- 基准条件(Base Case):当检查的条目为常规文件时,停止向下递归,直接收集文件绝对路径。
- 递推步骤(Recursive Step):当条目为目录时,保留当前上下文并对该子目录触发新的一轮递归探索,完成后将子目录返回的文件集合并入上一级列表。
二、方法一:基于 os 模块实现纯函数递归
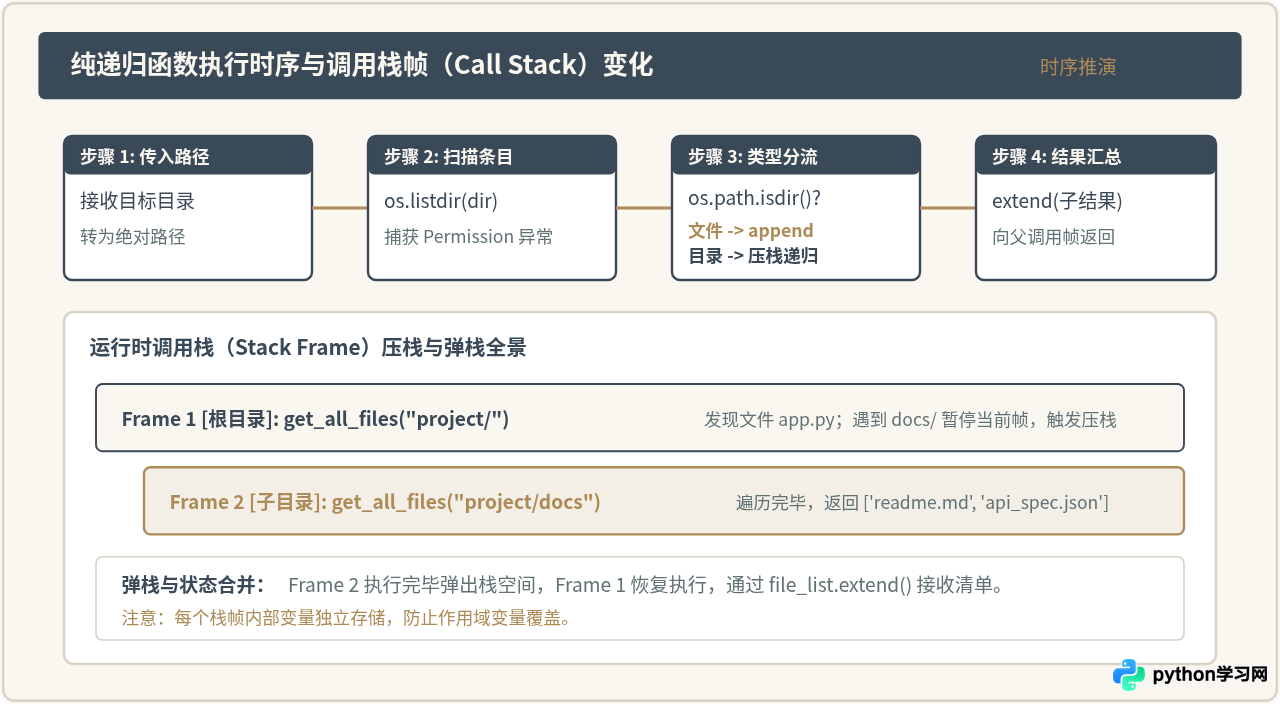
在标准库 os 模块中,os.listdir(path) 可以列出指定目录下的所有直接条目(包括文件与文件夹名称,但不包含 . 和 ..)。通过 os.path.join() 拼装完整路径,并借助 os.path.isdir() 进行分支判定,即可编写最标准的纯函数递归算法。
1. 完整代码实现
import os

def get_all_files_by_os(base_dir):
    """
    使用 os.listdir 与纯递归方式获取目录下的全部子文件绝对路径
    """
    file_list = []

    # 转换为绝对路径,避免相对路径在上层切换时失效
    base_dir = os.path.abspath(base_dir)

    # 遇到不存在或非目录直接返回空列表
    if not os.path.isdir(base_dir):
        return file_list

    try:
        entries = os.listdir(base_dir)
    except PermissionError:
        # 无权限访问的系统目录跳过,防止程序崩溃
        return file_list

    for entry in entries:
        full_path = os.path.join(base_dir, entry)

        if os.path.isdir(full_path):
            # 递推:如果是目录,递归获取并扩展到当前文件列表中
            sub_files = get_all_files_by_os(full_path)
            file_list.extend(sub_files)
        else:
            # 基准:如果是普通文件,直接收纳
            file_list.append(full_path)

    return file_list

# 示例调用
if __name__ == '__main__':
    target_path = "./my_project"
    all_files = get_all_files_by_os(target_path)
    print(f"共发现 {len(all_files)} 个子文件")
2. 递归调用的关键执行细节
编写上述纯递归代码时,必须注意以下三个细节:
- 必须拼接完整绝对路径:
os.listdir()返回的只是纯文件名(如"app.py"),若不使用os.path.join(base_dir, entry)拼接,下层递归时os.path.isdir()将在当前工作目录下查找,导致判断错误。 - 避免可变默认参数陷阱:不可将
def get_all_files(base_dir, file_list=[])作为函数签名,Python 中的可变默认参数在多次调用间会发生共享污染,应在函数体内部显式初始化或通过传参隔离。 - 调用栈深度限制:Python 解释器内置了默认最大递归深度(通常为 1000)。当目录嵌套层级超过该阈值时会抛出
RecursionError。因此纯递归适合层级可控的项目结构。
三、方法二:现代面向对象与生成器递归(pathlib)
Python 3.4 引入的 pathlib 提供了面向对象的文件路径抽象。使用 Path.iterdir() 结合 Python 的生成器语法(yield from),可以实现极其优雅且内存友好的流式递归遍历。
1. 流式生成器递归实现
from pathlib import Path

def get_all_files_generator(dir_path):
    """
    使用 pathlib 与生成器递归遍历,逐个产出文件 Path 对象
    """
    path_obj = Path(dir_path)

    if not path_obj.is_dir():
        return

    try:
        for entry in path_obj.iterdir():
            if entry.is_dir():
                # 递归委托给子生成器,无需在内存中一次性分配大数组
                yield from get_all_files_generator(entry)
            elif entry.is_file():
                yield entry.resolve()
    except PermissionError:
        pass

# 示例调用
if __name__ == '__main__':
    for file_path in get_all_files_generator("./my_project"):
        print(file_path)
使用 list.extend() 会在内存中构造包含成千上万个路径字符串的大数组。而 yield from 则采用惰性求值(Lazy Evaluation),每遍历到一个文件就立即产出并交由外部消费,内存占用始终维持在极低的常数级别。
2. 使用 pathlib 内置递归工具:rglob
如果无需自行控制递归细节,pathlib 封装了基于模式匹配的递归方法 rglob():
from pathlib import Path

def get_all_files_rglob(base_dir):
    p = Path(base_dir)
    # 匹配所有层级子文件,过滤掉目录节点
    return [f.resolve() for f in p.rglob('*') if f.is_file()]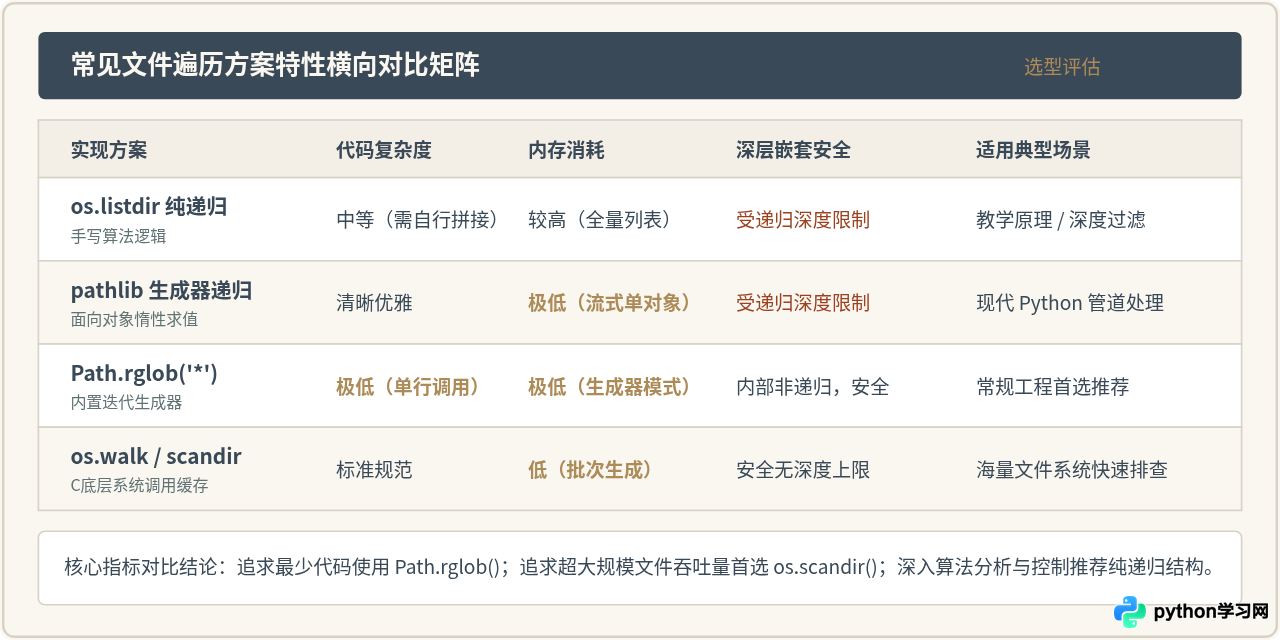
四、工程实践:系统级性能与异常防范
在真实生产环境遍历文件夹时,往往会面临符号链接循环、文件系统权限阻隔以及高频 I/O 带来的性能问题。
1. 符号链接(Symlink)死循环防范
当目录中存在指向父级目录或祖先目录的软链接(Symbolic Link)时,递归遍历会陷入无底死循环直至栈溢出。防范方案是显式过滤软链接,或者在递归过程中维护一个已访问真实设备节点(inode)的集合:
# 防范软链接死循环示例
if entry.is_symlink():
    continue  # 忽略软链接,或者判断 os.path.realpath(entry) 是否已被访问
2. 利用 os.scandir 消除多余 stat 系统调用
os.listdir() 仅返回文件名,随后的 os.path.isdir() 会再次触发操作系统的 stat() 系统调用。而在 Linux/Windows 上,os.scandir() 在读取目录清单的同时就一并获取了文件属性并缓存为 DirEntry 对象,遍历性能通常高出 2 到 10 倍。
五、总结与选型指南
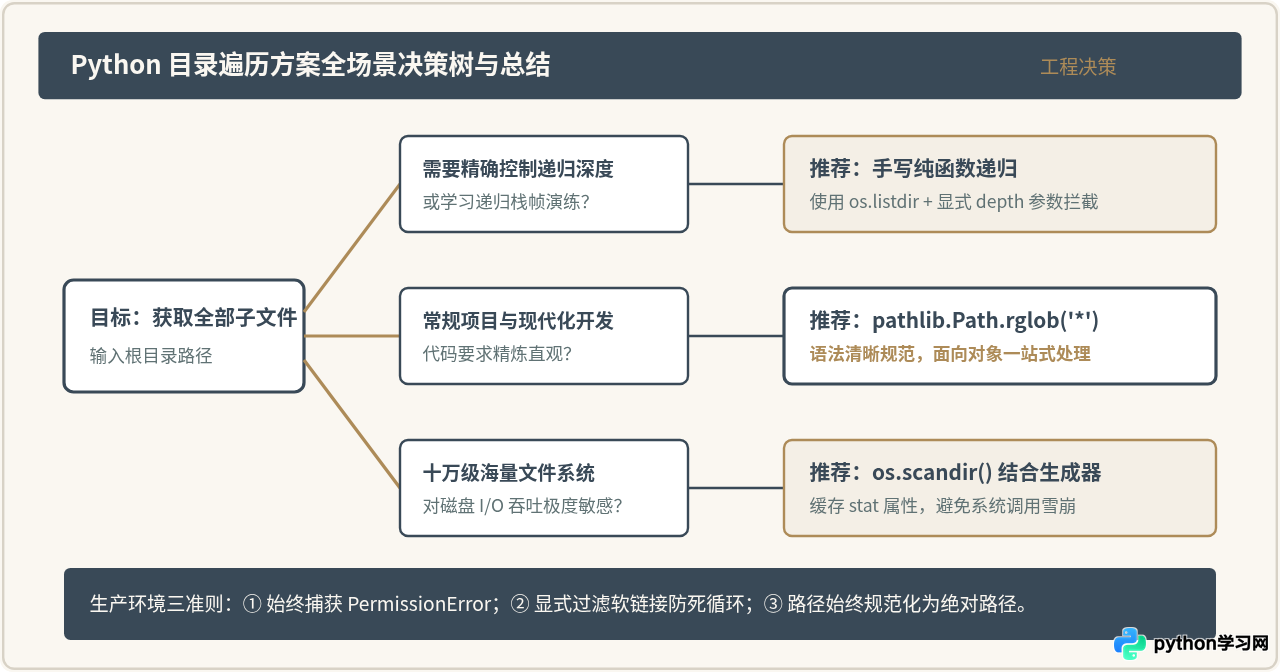
递归遍历的本质是深度优先搜索在目录树上的映射。掌握纯递归有助于理解栈帧机制与算法推演;而在工程落地时,应结合场景特性合理选型。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















