


Python字符串切片语法详解:start、stop与step参数用法

s[start:stop:step],核心逻辑建立在“前闭后开区间”与“步长方向判断”的基础之上。理解并熟练掌握这三个参数的缺省行为与正负索引转换,能够帮助开发者准确书写取值逻辑,并避免空字符串及索引偏差等常见问题。
许多刚接触 Python 的读者在第一次写出 s[1:4] 时,常误以为会提取出 4 个字符,结果却只得到了 3 个。切片并不是简单的“从第几个字符抓取到第几个字符”,它在底层抽象出了一个带有几何分界点、支持正反双向坐标以及可控步长运动的轻量视图机制。本文将逐一拆解 start、stop 与 step 的具体工作逻辑。
一、双向索引与“前闭后开”区间模型
在深入参数之前,必须先理清 Python 序列的坐标系统。Python 字符串中的字符拥有两套等价的索引系统:从左往右以 0 开始递增的正向索引,以及从右往左以 -1 开始递减的反向索引。
而在切片语法 s[start:stop] 中,start 与 stop 划定的是一个前闭后开区间,即数学意义上的 [start, stop):包含起点 start 处的元素,但不包含终点 stop 处的元素。
理解这种机制最稳妥的思维模型,是将索引视作字符之间的分界点(Cut Points),而不是字符本身所在的格子:
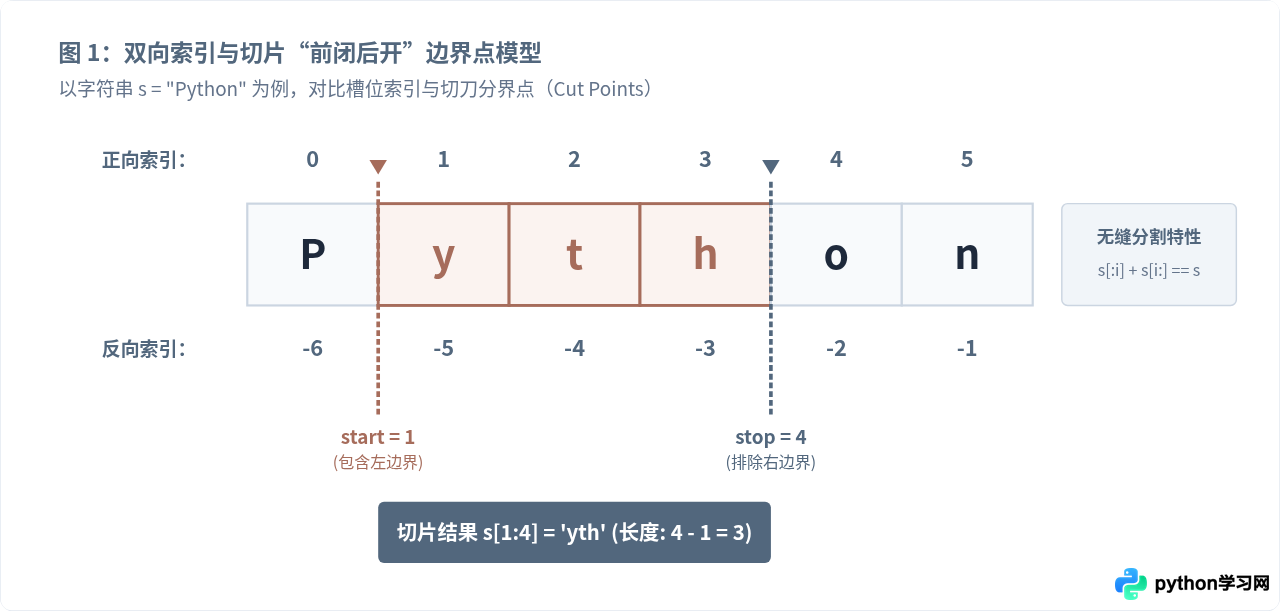
采用前闭后开区间设计具有三个显著的数学与工程优势:
- 切片长度计算直接直观:当步长为默认的 1 时,切片返回的子串长度恰好等于
stop - start。例如s[1:4]的长度就是4 - 1 = 3。 - 相邻切片能够无缝拼接:任意索引
i都可以将字符串干净地切成前后两半,满足恒等式s[:i] + s[i:] == s,不会产生任何重复字符或遗漏。 - 空切片边界清晰:当
start == stop时,区间[start, start)为空集,必然返回空字符串"",逻辑高度自洽。
二、start 与 stop 参数及缺省值机制
在基础切片 s[start:stop] 中,两个参数都可以省略。省略时,Python 会根据当前的扫描方向赋予其默认值。
在步长为正(向右扫描,包括默认省略 step 的情况)的前提下:
- 若省略
start(形如s[:stop]),其默认值为0,表示从字符串最开头开始提取。 - 若省略
stop(形如s[start:]),其默认值为原字符串长度len(s),表示一直提取到字符串末尾(包含最后一个字符)。 - 若两者皆省略(形如
s[:]),则提取整个字符串,生成原字符串的一个浅拷贝。
s = "HelloWorld"

# 1. 省略 start:等价于 s[0:5]
print(s[:5])    # 示例输出: 'Hello'

# 2. 省略 stop:等价于 s[5:len(s)]
print(s[5:])    # 示例输出: 'World'

# 3. 使用负数索引:提取倒数后 5 个字符
print(s[-5:])   # 示例输出: 'World'

# 4. 前闭后开掐头去尾:去掉首字符和尾字符
print(s[1:-1])  # 示例输出: 'elloWorl'
如果通过单一索引访问越界位置(例如
s[100]),Python 会立刻抛出 IndexError: string index out of range 异常;但在切片语法中,start 和 stop 超过字符串实际边界是完全合法的。Python 会自动将超出范围的边界截断在合法的最大范围处,例如 s[0:1000] 只会安全地提取出整个字符串而不会报错。
三、step 步长机制:方向性与跳步控制
第三个参数 step 指定取值间隔与行进方向。如果将切片操作看作指针在字符序列上的移动,那么 step 就是指针每一步移动的跨度与符号:
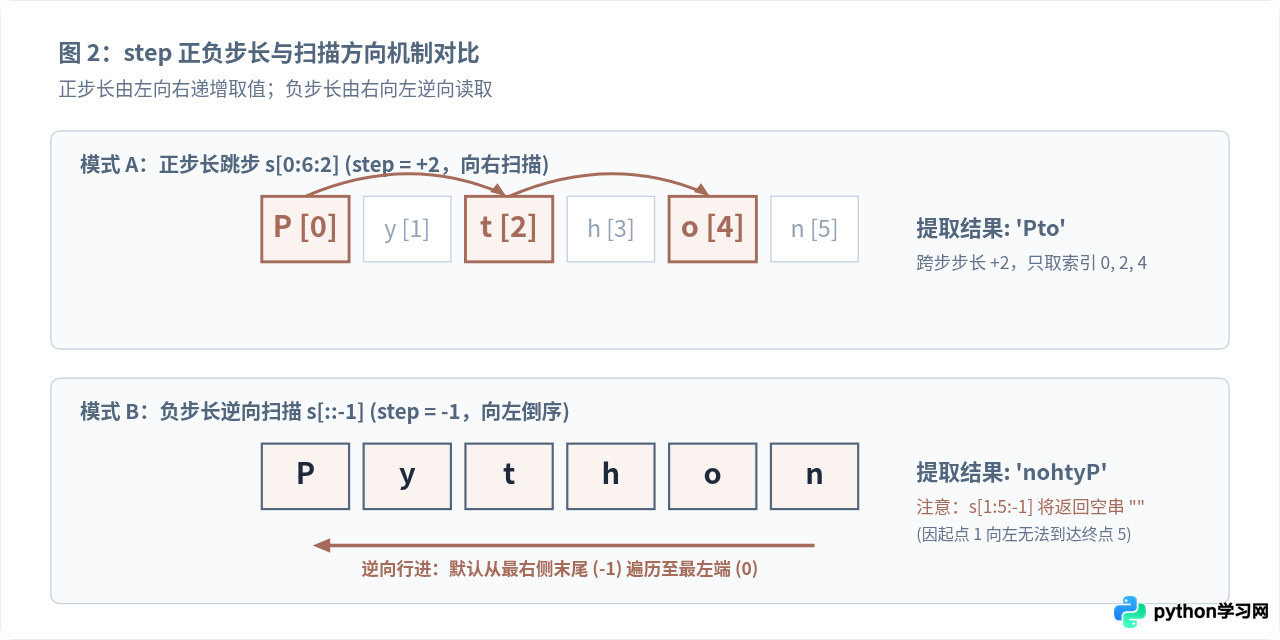
step > 0:正向移动(从左向右读取)。指针每次递增step个单位。step < 0:反向移动(从右向左读取)。指针每次递减abs(step)个单位。step == 0:非法参数。Python 会直接抛出ValueError: slice step cannot be zero。
许多初学者产生困惑的核心原因,在于忽略了 “step 的正负直接决定了扫描方向”。当方向反转后,start 和 stop 的缺省值与有效性判断规则也会随之改变:
反向切片与逆序常见陷阱
当 step < 0 时,由于方向从右往左,默认值规则发生了颠倒:
start缺省值变为-1(即最右侧最后一个元素)。stop缺省值变为字符串最左端之前的虚拟位置(从而能完整包含第0个字符)。
因此,常用语法 s[::-1] 可以极为简洁地实现字符串反转。
但这里有一个非常经典的错误案例:很多开发者试图通过 s[1:5:-1] 来“逆向获取索引 1 到 5 之间的内容”,运行后却只得到一个空字符串 ""。其原因在于:起点 start=1 位于终点 stop=5 的左侧,但 step=-1 规定了指针只能向左移动。指针从位置 1 往左走,永远无法触及右侧的位置 5,因而直接判定无有效元素,返回空结果。若要逆向提取该区间,正确的写法应将起点置于右侧:s[4:0:-1](获得 'oht')。
四、切片推导与排查三步法
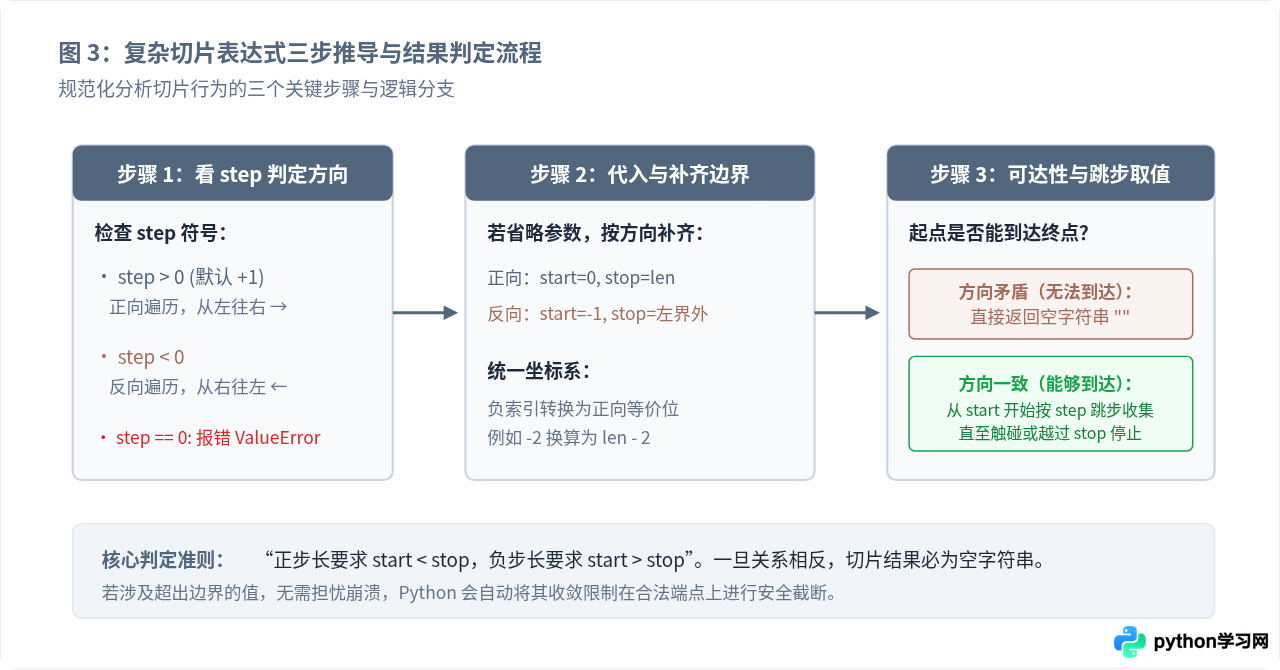
在面对包含负索引、负步长或省略参数的复杂切片时,不需要死记硬背各种排列组合,可以通过以下规范的“三步推导法”准确推断运行结果:
推导实战示例
以字符串 text = "ABCDEFGHIJ"(长度 10)为例,推导表达式 text[-2:2:-2] 的执行过程:
- 第 1 步(看步长方向):
step = -2为负数,说明扫描方向为从右向左。 - 第 2 步(规范化坐标):
start = -2对应字符'I'(正向索引 8);stop = 2对应字符'C'(正向索引 2)。 - 第 3 步(可达性与跳步收集):起点 8 在终点 2 的右侧,沿着向左方向可以到达终点(满足
start > stop)。从索引 8 开始以步长 2 向左跳步:- 取索引 8:字符
'I' - 跳到索引 6:字符
'G' - 跳到索引 4:字符
'E' - 下一次跳到索引 2,但由于区间前闭后开不包含
stop本身,停止收集。
'IGE'。 - 取索引 8:字符
五、常用高频应用模式与技巧
在日常开发中,切片广泛应用于数据清洗、格式截取与序列变形等场景:
1. 奇偶位置字符提取
s = "0123456789"

# 提取偶数索引字符(第 0, 2, 4, 6, 8 位)
evens = s[::2]    # 示例输出: '02468'

# 提取奇数索引字符(从索引 1 开始,每次跳 2 步)
odds = s[1::2]   # 示例输出: '13579'
2. 提取固定长度前缀与后缀
filename = "report_2026_final.pdf"

# 提取前 6 个字符
prefix = filename[:6]    # 示例输出: 'report'

# 提取最后 4 个字符(常用于获取后缀名)
extension = filename[-4:]  # 示例输出: '.pdf'
3. 使用内置 slice 对象增强可读性与复用
在编写处理固定格式协议或报文的代码时,如果代码中散落着大量形如 row[12:28]、row[28:40] 的硬编码切片,可读性与维护性会显著降低。Python 提供了内置的 slice(start, stop, step) 函数,可以创建命名的切片对象:
# 创建命名切片规则对象
RECORD_ID = slice(0, 8)
RECORD_DATE = slice(8, 16)
RECORD_AMOUNT = slice(16, 24)

raw_data = "TX9081222026102000045000"

# 像传递索引一样使用切片对象
tx_id = raw_data[RECORD_ID]        # 示例输出: 'TX908122'
tx_date = raw_data[RECORD_DATE]    # 示例输出: '20261020'
tx_amount = raw_data[RECORD_AMOUNT]# 示例输出: '00045000'
使用 slice 对象能将数据解析结构清晰地抽象出来,大幅提升了批量解析日志或固定宽度文本时的代码清晰度。
六、参数特性与常见切片模式总结
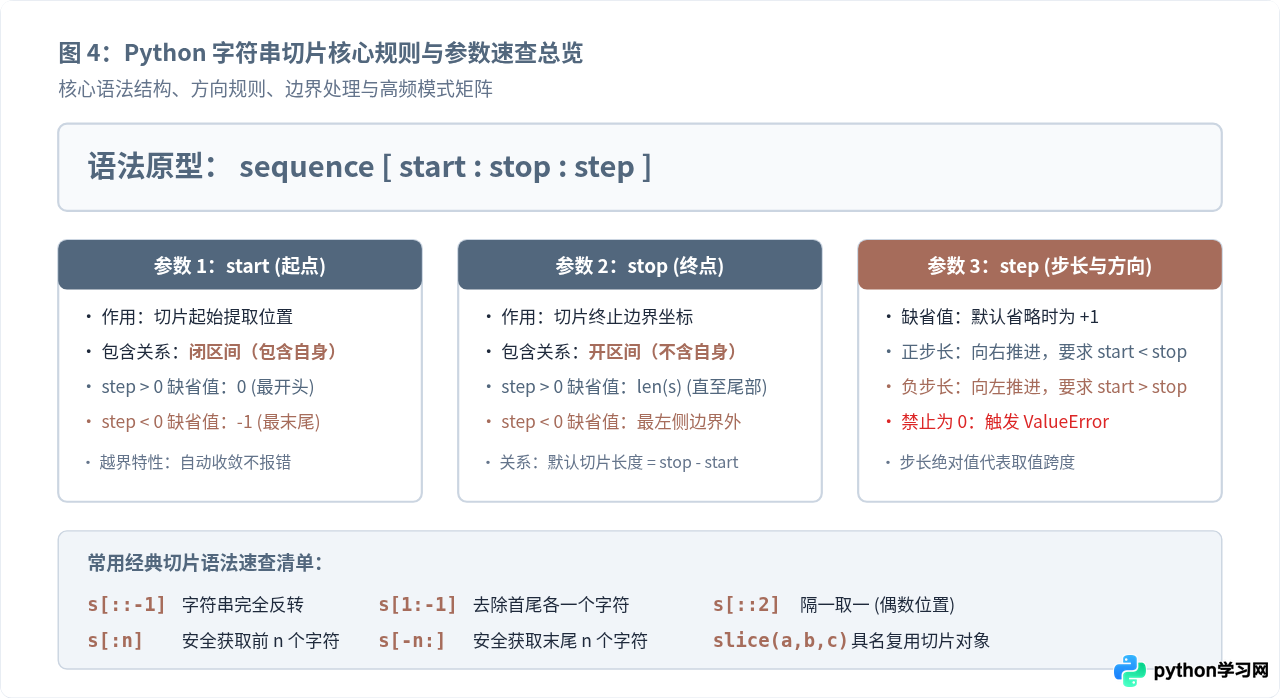
为了便于速查与系统复习,下表归纳了 start、stop 与 step 在不同组合下的行为特征:
| 切片模式 | step 状态 | 扫描方向 | 等效完整写法 | 典型应用场景 |
|---|---|---|---|---|
s[a:b] |
省略 (+1) | 向右 → | s[a:b:1] |
截取指定下标区间子串 |
s[:b] |
省略 (+1) | 向右 → | s[0:b:1] |
截取前缀 / 前 b 个字符 |
s[a:] |
省略 (+1) | 向右 → | s[a:len(s):1] |
截取从下标 a 开始的全部剩余内容 |
s[:] |
省略 (+1) | 向右 → | s[0:len(s):1] |
复制原序列浅拷贝 |
s[::k] |
k > 0 | 向右 → | s[0:len(s):k] |
正向均匀抽样 / 取偶数位 |
s[::-1] |
-1 | 向左 ← | s[-1:-len(s)-1:-1] |
完整逆序反转字符串 |
s[b:a:-1] |
-1 | 向左 ← | 需满足 b > a |
局部逆序截取子串 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















