


Python元组怎么创建和访问?索引、切片与遍历示例

在 Python 中,元组(tuple)是一种用于存放多个有序元素的基础数据结构。与列表(list)非常相似,元组支持通过位置读取数据,但其核心差异在于元组是不可变的(Immutable)——一旦完成创建,就无法新增、删除或替换其中的元素。本文将直接围绕元组的创建方式、单元素定义陷阱、正负索引与切片规则、循环遍历以及序列解包展开系统讲解,提供可直接验证的代码示例与图解对比。
一、Python元组的核心概念与创建方式
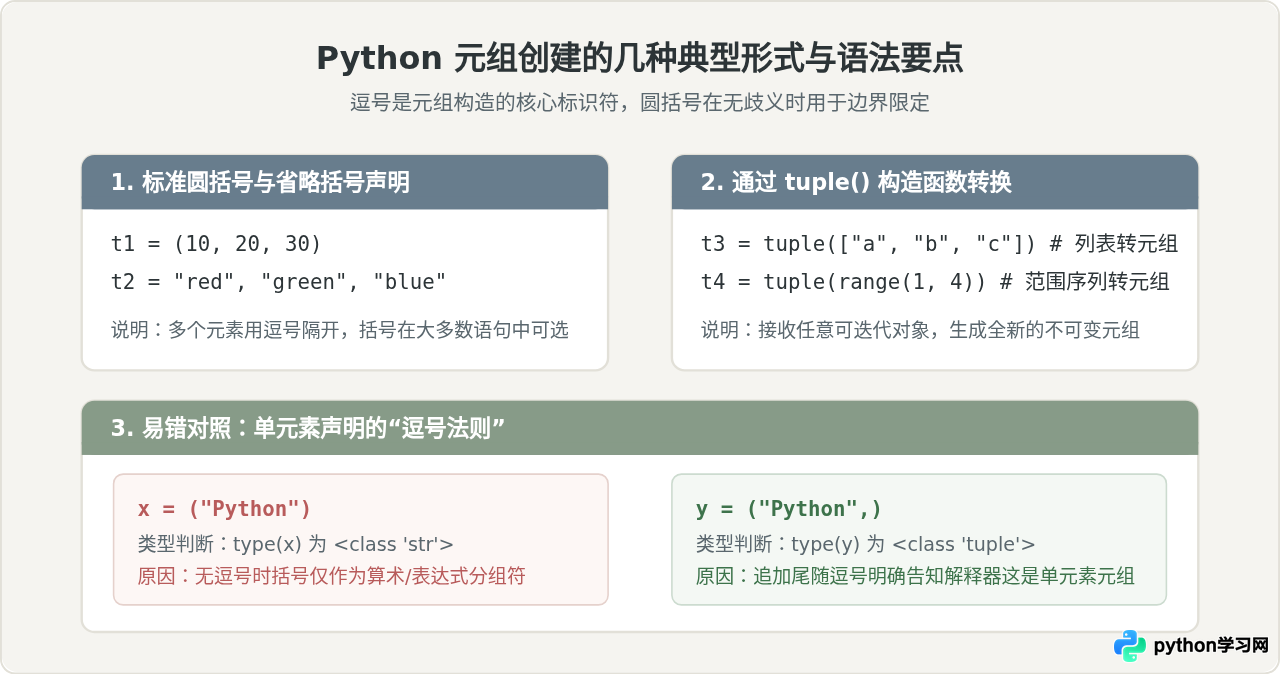
创建元组最直观的方式是使用一对圆括号 (),并在其中用英文逗号 , 分隔各个数据项。元组可以包含任意类型的数据,包括整数、浮点数、字符串、甚至嵌套列表或另一个元组。
1. 常见创建形式
在日常开发中,主要有四种创建元组的方式:
- 空元组:直接使用不带内容的圆括号
t = (),或调用构造函数tuple()。 - 多元素元组:圆括号包裹逗号分隔的值,例如
t = ("apple", "banana", "cherry")。 - 省略括号的逗号打包:在 Python 中,逗号才是真正构成元组的关键。写成
point = 10, 20会自动被识别为元组。 - 类型转换:使用内置函数
tuple(iterable),将列表、字符串或 range 序列转为元组。
# 示例 1:基础创建与类型转换
empty_tuple = ()
languages = ("Python", "Go", "Rust")
coordinates = 120.15, 30.28  # 省略括号形式
from_list = tuple([1, 2, 3, 4])
from_string = tuple("ABC")

print("coordinates 类型:", type(coordinates))
print("from_list 内容:", from_list)
print("from_string 内容:", from_string)coordinates 类型: <class 'tuple'>from_list 内容: (1, 2, 3, 4)from_string 内容: ('A', 'B', 'C')
2. 关键避坑:定义单元素元组
很多初学者容易在此处出错:当试图创建一个只包含单个元素的元组时,如果仅写成 (10),Python 解释器会将其视为普通数学运算中的优先级括号,变量类型仍然是整数。必须在元素后面追加一个英文逗号 (10,),Python 才会将其识别为元组。
not_a_tuple = ("hello") 的结果是 str 字符串类型;而 is_a_tuple = ("hello",) 才是真正的 tuple 类型。在编写函数传参或 SQL 占位符元组时,遗漏逗号是导致 TypeError 的常见原因。
二、通过索引访问元组元素
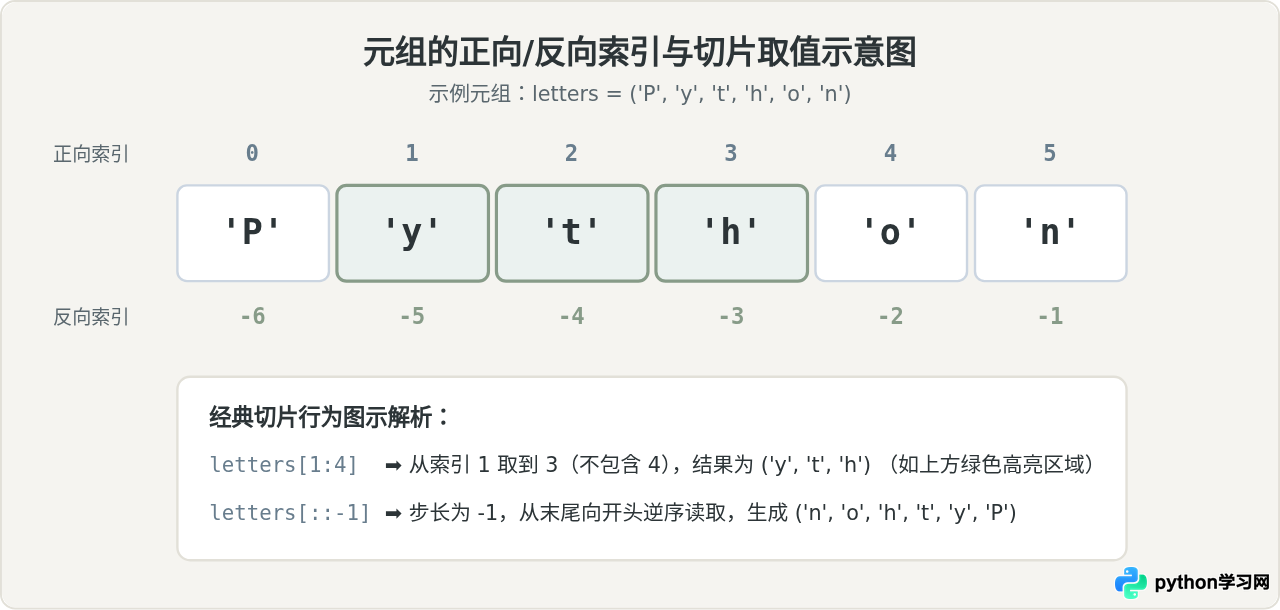
元组属于有序序列,每个位置的元素都对应一个固定的整数索引(Index)。在 Python 中,索引分为两种:
- 正向索引(从前往后):下标从
0开始,依次递增1,最后一个元素的正向索引是len(tuple) - 1。 - 反向索引(从后往前):下标从
-1开始,代表最后一个元素,依次向前递减(-2代表倒数第二个元素)。
# 示例 2:正向索引与反向索引
server_info = ("192.168.1.100", 8080, "web-server", "Ubuntu 22.04")

# 正向读取
host = server_info[0]
port = server_info[1]

# 反向读取
os_name = server_info[-1]
service = server_info[-2]

print(f"主机: {host}:{port}")
print(f"操作系统: {os_name}, 服务名称: {service}")主机: 192.168.1.100:8080操作系统: Ubuntu 22.04, 服务名称: web-server
如果尝试访问超出范围的索引(例如长度为 4 的元组访问 server_info[4] 或 server_info[-5]),Python 将引发 IndexError: tuple index out of range。在不确定长度时,应先通过 len() 进行边界检查。
三、元组的切片提取(Slicing)
切片允许我们从现有元组中提取出一段子序列,语法形式为:tuple[start:stop:step]。
start:起始索引(包含该位置,默认从0开始)。stop:结束索引(不包含该位置,即左闭右开区间,默认到序列末尾)。step:步长(间隔取值步长,默认为1;若为负数则表示反向取值)。
# 示例 3:切片操作与参数演示
data = ("zero", "one", "two", "three", "four", "five", "six")

# 1. 基础区间切片(取索引 1 到 4,不含 5)
sub1 = data[1:5]

# 2. 省略边界(前 3 个元素与从索引 4 到末尾)
head = data[:3]
tail = data[4:]

# 3. 指定步长(每间隔 1 个取 1 个)
evens = data[::2]

# 4. 反向切片(倒序反转元组)
reversed_tuple = data[::-1]

print("sub1 [1:5]:", sub1)
print("前3个 [:3]:", head)
print("偶数位 [::2]:", evens)
print("倒序反转 [::-1]:", reversed_tuple)sub1 [1:5]: ('one', 'two', 'three', 'four')前3个 [:3]: ('zero', 'one', 'two')偶数位 [::2]: ('zero', 'two', 'four', 'six')倒序反转 [::-1]: ('six', 'five', 'four', 'three', 'two', 'one', 'zero')
需要说明的是,由于元组具有不可变特性,切片操作并不会修改原元组,而是基于指定区间生成并返回一个新的元组对象。此外,切片操作即使索引轻微越界也不会报错,而是优雅地截取到序列边界。
四、元组(Tuple)与列表(List)的核心差异对比
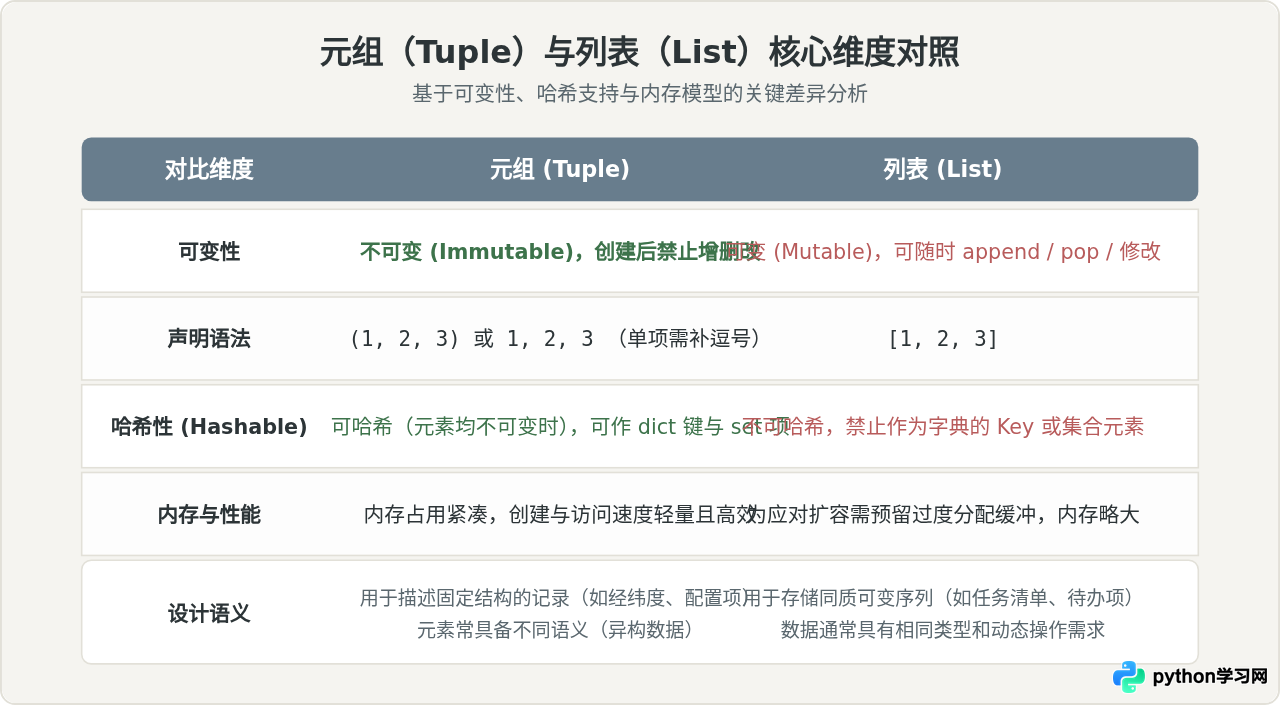
为了让读者在实际编写 Python 代码时能够准确判断何时使用元组、何时使用列表,我们在一致的运行环境下,从语法、可变性、哈希性、内存性能及设计哲学五个核心维度进行系统对照:
为什么不可变性如此重要?
很多开发者会产生疑问:既然列表功能更丰富,为什么 Python 还要单独设计元组?核心原因在于数据安全与运行契约:
- 防御性编程:将不需要修改的数据定义为元组传递给其他函数或模块,可以防止在下游被意外修改(只读保护)。
- 字典复合键支持:字典的 Key 必须是可哈希的。例如,我们可以用坐标元组
(x, y)或多维网格(row, col)作为字典的键,而列表无法做到这一点。 - 性能优化:对于固定不变的常量序列,Python 内部对静态小元组具备缓存与复用优化机制,分配和回收开销显著低于动态列表。
五、元组的遍历与序列解包(Unpacking)
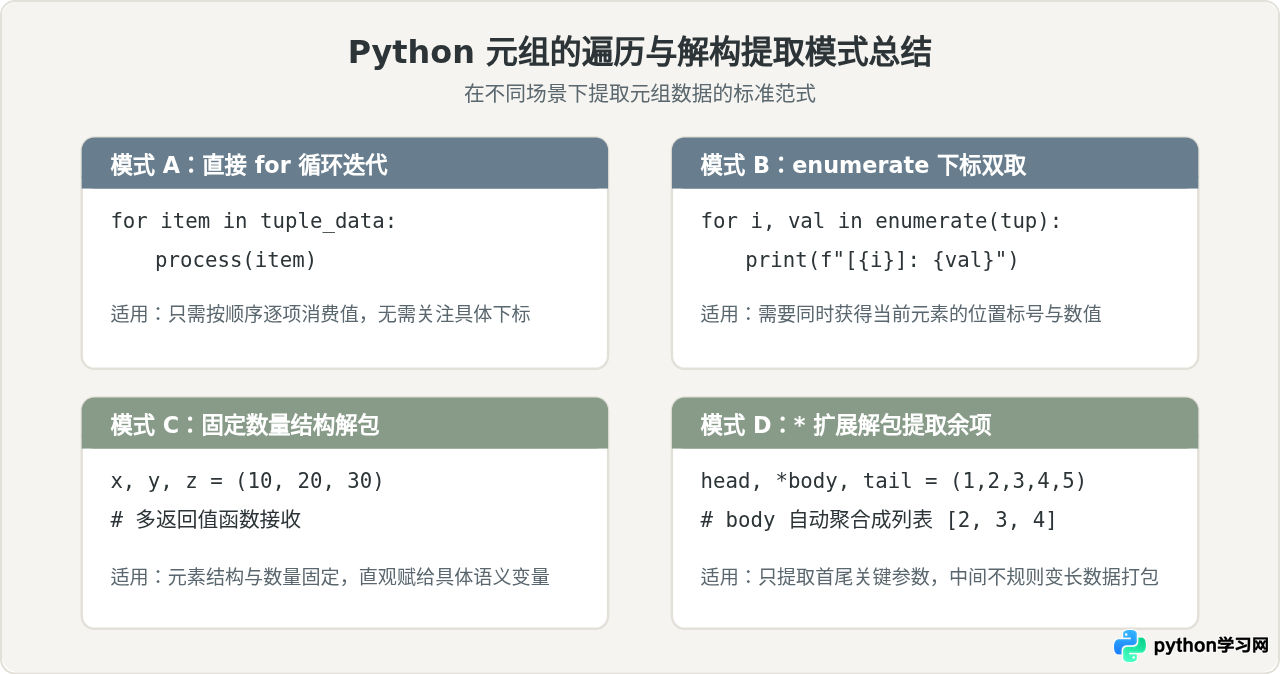
元组是标准的可迭代对象(Iterable),可以使用多种方式进行遍历读取与批量提取。
1. 直接遍历与带索引遍历
如果仅需要依次消费每一个元素,可以直接使用 for item in tuple: 语句;如果遍历的同时需要获知当前元素的位置下标,推荐使用 enumerate() 函数。
# 示例 4:for 循环与 enumerate 索引遍历
frameworks = ("Django", "Flask", "FastAPI", "Tornado")

# 直接遍历
print("--- 直接遍历 ---")
for fw in frameworks:
    print("框架名称:", fw)

# 带索引遍历
print("\n--- 带索引遍历 (从 1 开始编号) ---")
for index, fw in enumerate(frameworks, start=1):
print(f"第 {index} 个框架: {fw}")--- 直接遍历 ---框架名称: Django框架名称: Flask框架名称: FastAPI框架名称: Tornado--- 带索引遍历 (从 1 开始编号) ---第 1 个框架: Django第 2 个框架: Flask第 3 个框架: FastAPI第 4 个框架: Tornado
2. 序列解包与星号(*)扩展解包
解包(Unpacking)是 Python 中最优雅的语法特性之一。我们可以直接将元组中的值一次性赋给对应数量的变量,这在接收函数返回多个值或拆解数据记录时尤为高效。
# 示例 5:元组解包与星号扩展
# 基础解包:变量个数必须与元组长度严格一致
user_record = ("Alice", 28, "Engineer")
name, age, job = user_record
print(f"姓名: {name}, 年龄: {age}, 职位: {job}")

# 星号解包:捕获任意长度的剩余项为列表
scores = (95, 88, 76, 92, 85, 99)
first, *middle, last = scores
print(f"首项: {first}, 中间项列表: {middle}, 末项: {last}")姓名: Alice, 年龄: 28, 职位: Engineer首项: 95, 中间项列表: [88, 76, 92, 85], 末项: 99
六、必须了解的进阶注意事项
虽然元组本身具有不可变性,但在实际编写代码时,仍有两个特殊情况需要引起重视:
1. 元组内嵌可变对象的“表里不一”
“元组不可变”是指元组所持有的各个元素引用地址不可改变。如果元组中包含了一个可变对象(例如列表 [1, 2]),虽然不能把该列表整体替换为另一个对象,但该列表内部的内容却依然可以被修改。
# 示例 6:包含可变对象的元组
nested_tuple = ("config", [100, 200])

# 尝试直接替换列表会抛出 TypeError
# nested_tuple[1] = [300, 400]  # 报错:'tuple' object does not support item assignment

# 但可以直接修改列表内部的数据项
nested_tuple[1].append(300)
print("修改内部列表后的元组:", nested_tuple)修改内部列表后的元组: ('config', [100, 200, 300])
注意:当元组中包含可变对象时,该元组将失去可哈希性,无法再作为字典的 Key 或存入 Set 中,调用 hash(nested_tuple) 会抛出 TypeError: unhashable type: 'list'。
2. 常见内置方法:count() 与 index()
由于元组不支持任何修改操作(无 append、extend、pop、sort 等),其内置方法非常精简,仅包含查询功能的两个方法:
t.count(value):统计指定值在元组中出现的总次数。t.index(value, [start, stop]):查找指定值首次出现的位置索引;若值不存在则抛出ValueError。
七、知识总结
掌握 Python 元组的使用,核心在于理解以下三点:
- 创建:多元素通过逗号分隔定义;单元素必须保留尾随逗号
(item,);括号在很多上下文起到限定作用,但逗号才是元组的本质。 - 访问:索引从
0(正向)与-1(反向)开始,超出范围引发IndexError;切片[start:stop:step]遵循左闭右开规则并返回新元组。 - 应用选择:当需要表示不被篡改的记录、复合字典键或函数多返回值时,优先选用元组;当需要动态增删、排序及频繁变更时,选用列表。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















