


Python中下划线和点的根本区别:命名约定与属性访问

在编写 Python 代码时,诸如 self._status.update() 或 module.__name__ 的写法屡见不鲜。初学者常因它们常组合出现而产生混淆,误以为下划线(_)与点(.)是同类语法标记。然而这两者在 Python 语法体系中存在根本性的鸿沟:点(.)是二元属性访问运算符,在运行时主动驱动对象的属性查找协议;而下划线(_)是合法的标识符字符与命名约定载体,它自身不具备求值行为,而是通过命名模式向解释器传达特殊修饰指令,或向开发者传达内部封装意图。明确两者的职责边界,是理解 Python 面向对象模型与执行机制的必经之路。
一、语法维度的根本分歧:字符与运算符的本质差异
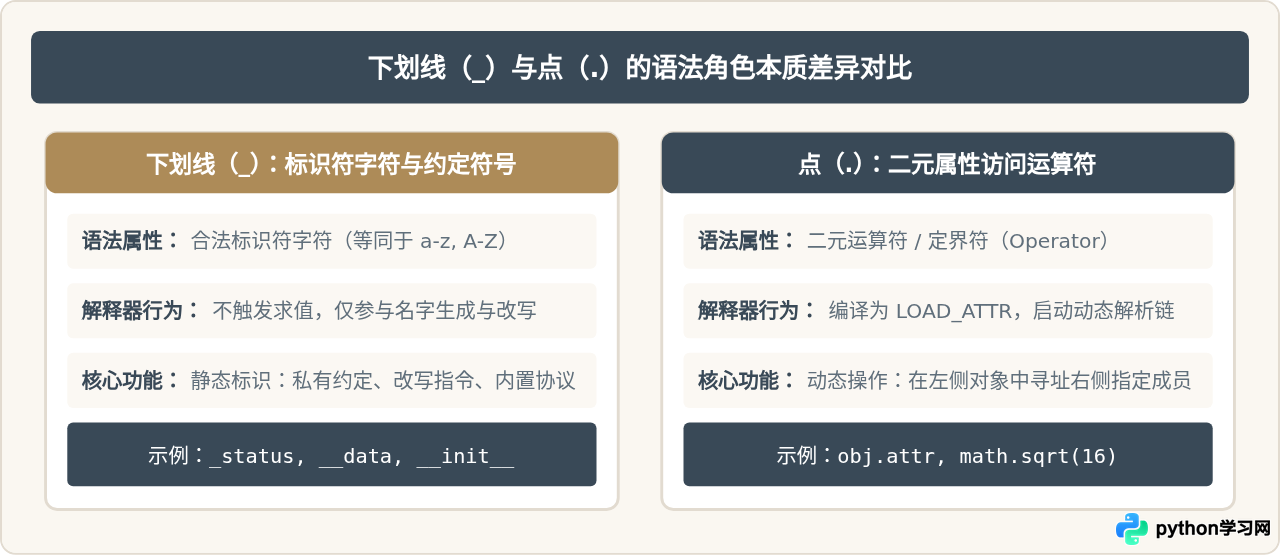
从 Python 词法分析(Lexical Analysis)与语法分析(Syntax Analysis)的角度来看,下划线与点处于完全不同的符号层级:
- 下划线(
_):属于标识符(Identifier)字符集。在词法规范中,下划线与英文字母地位相同,均可作为变量名、函数名或属性名的合法组成部分。下划线本身不执行任何动作,它只是名字字面量(Literal Name)的一部分。当解释器读到下划线时,仅将其作为标识符的一部分记入符号表或名称属性中。 - 点(
.):属于运算符与定界符(Operator / Delimiter)。点是一个二元运算符,连接左侧的主体对象与右侧的属性名称。当解释器遇到点时,会将其编译为专用的字节码指令(如LOAD_ATTR或STORE_ATTR),在运行时触发动态属性查找与描述符机制。
二、点运算符(.):属性访问与动态分发的核心枢纽
在 Python 中,一切皆为对象,而点运算符是连接对象与其实例属性、类属性、方法乃至子模块的唯一官方二元接口。当我们在代码中书写 instance.member 时,底层经历了一套确定性但高度灵活的检索流程。
1. 点运算符的底层机制
表达式 x.y 会在解释器内部直接转换为对 type(x).__getattribute__(x, "y") 的显式调用。其属性解析顺序遵循以下五个严格优先级:
- 数据描述符优先:检查对象所属类及其继承链的字典,若存在定义了
__get__和__set__的数据描述符(如@property),则直接调用描述符并返回其结果。 - 实例字典查找:若非数据描述符,则直接从对象自身的
instance.__dict__中查找名为"y"的键。 - 非数据描述符与类属性:若实例字典中不存在,则回退到类的继承链字典中查找非数据描述符(如普通方法、静态方法)或普通类属性。
- 自定义属性挂钩:若上述路径均未命中,且类定义了
__getattr__,则调用__getattr__(x, "y")作为保底恢复机制。 - 抛出异常:若所有阶段均未检索成功,则抛出标准
AttributeError。
class ConfigManager:
    version = "1.0.0"  # 类属性

    def __init__(self, endpoint):
        self.endpoint = endpoint  # 实例属性

    def connect(self):
        return f"连接至: {self.endpoint}"

cfg = ConfigManager("https://api.example.com")

# 通过点运算符进行访问
print(cfg.version)   # 命中类属性
print(cfg.endpoint)  # 命中实例字典属性
print(cfg.connect()) # 命中方法对象并完成方法绑定调用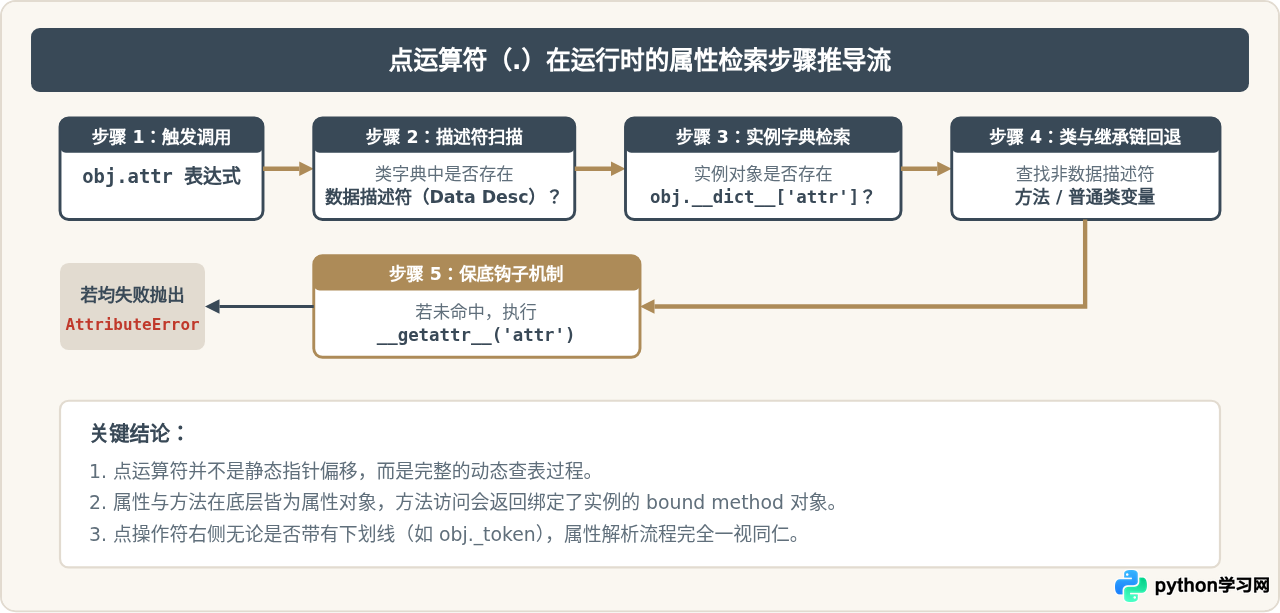
三、下划线(_):命名约定、名称改写与系统特殊语义
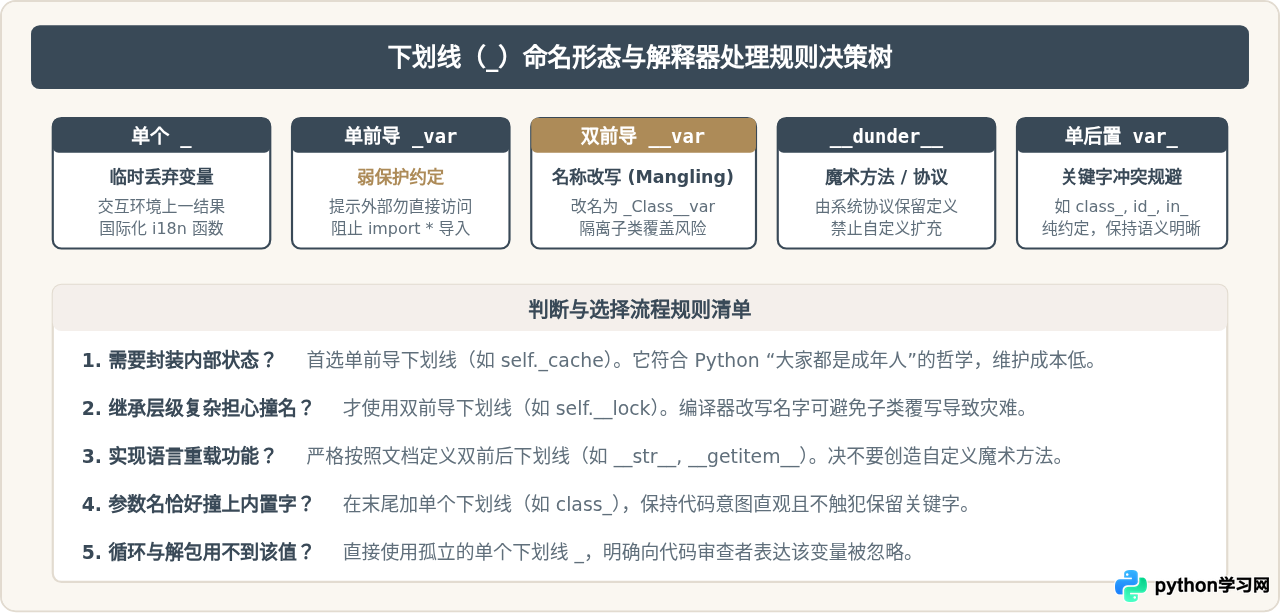
与点运算符驱动主动查找不同,下划线作为字符本身,并不对对象模型施加任何运行时的查找动作。它的行为取决于其出现在标识符中的位置与数量。在 Python 中,下划线承担了五类核心语义角色:
1. 单独下划线 _
- 临时或丢弃变量:在解包赋值或循环中,表示该值在后续逻辑中不会被使用(如
for _ in range(5):或head, *_, tail = data)。 - 交互式解释器环境:在 Python REPL 中,
_保存上一次表达式求值的输出结果。 - 国际化约定:在多语言支持代码中,通常将
gettext.gettext简记为_("Hello")。
2. 单前导下划线 _var(保护约定)
单前导下划线是一种“软提示”。它告诉调用者:“这是一个内部实现属性,外部不应直接依赖它”。但这纯属社区与 PEP 8 的约定,解释器不会在语法上阻止外部直接访问。唯一会受到影响的语法是模块导入:当使用 from module import * 时,所有以单前导下划线开头的顶级名称均不会被导入。
3. 双前导下划线 __var(名称改写 Name Mangling)
当类属性以双下划线开头且结尾至多一个下划线时,Python 编译器在编译期会对其执行名称改写(Name Mangling)。其命名会被自动替换为 _类名__变量名。该机制设计的根本目的不是为了像 Java/C++ 那样实现所谓的“严格私有”,而是为了防止子类在继承扩展时不小心覆盖父类的内部状态。
class Parent:
    def __init__(self):
        self._hint = "约定私有"
        self.__secret = "名称改写保护"

p = Parent()
# 单下划线可以直接通过点运算符访问
print(p._hint)  # 输出: 约定私有

# 直接访问双下划线会抛出 AttributeError
# print(p.__secret)  # 报错: 'Parent' object has no attribute '__secret'

# 但是通过改写后的内部名字,依然可以访问:
print(p._Parent__secret)  # 输出: 名称改写保护
4. 双前后下划线 __init__(魔法方法 / Dunder)
通常被称为 Dunder(Double Underscore)。这是 Python 预留的协议与内部专有钩子名称。例如 __init__、__call__、__enter__、__len__ 等。用户代码不应自行发明未在官方规范中声明的双前后下划线名称,以避免未来与标准库扩充产生冲突。
5. 单后置下划线 var_(关键字规避)
当变量命名与 Python 内置关键字(如 class, def, type, id)冲突时,PEP 8 推荐在尾部追加单个下划线以作规避,例如 class_ = "math"。
四、协同场景与典型误区剖析
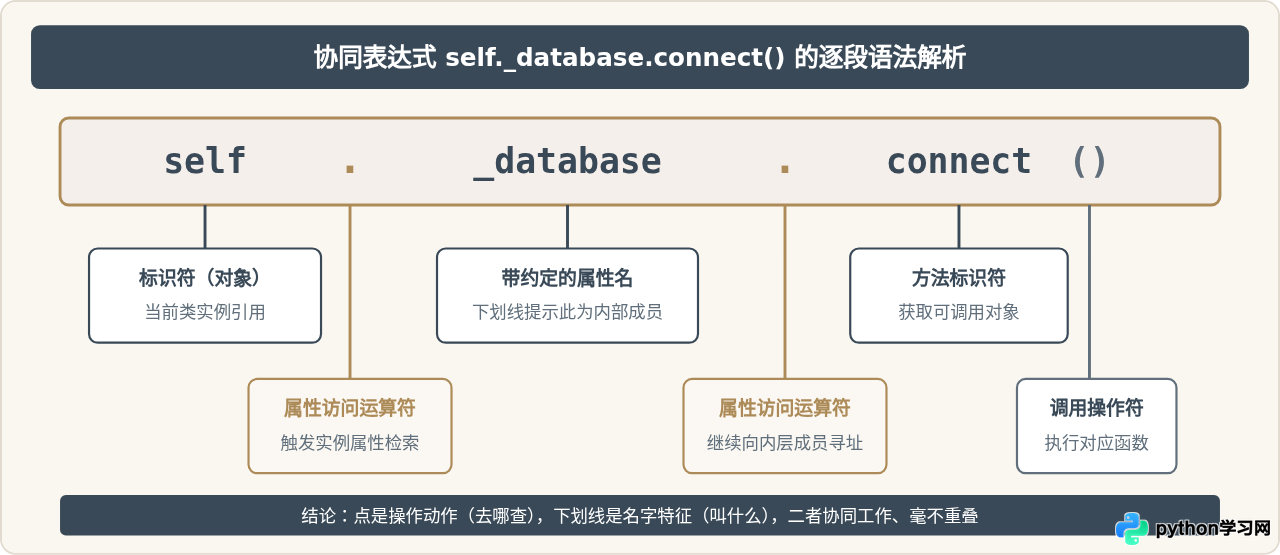
当下划线与点运算符出现在同一个语句中时,它们各自履行分工。剖析一个典型调用语句,能够最直观地体现二者的协同关系:
在这个表达式中:
self:变量标识符,求值为当前类的实例对象。- 第一个点(
.):二元运算符,以self为目标对象,执行属性检索。 _database:受保护约定的属性标识符(下划线是其名称第一字符),检索结果返回一个内部数据库连接对象。- 第二个点(
.):第二个二元运算符,以返回的数据库对象为目标,执行方法查找。 connect:普通方法标识符。():函数调用运算符,执行方法。
常见理解误区与纠偏
- 误区一:“在 Python 中加了下划线就代表绝对私有”:
纠偏:Python 没有任何真正意义上的“强制私有”。即使使用了双下划线触发名称改写,外部依然可以通过
obj._ClassName__attr轻易读取和修改该变量。Python 的核心设计理念是“大家都是心智成熟的成年人(We are all consenting adults here)”。下划线是防护栏而不是铁牢笼。 - 误区二:“点运算符可以访问变量,但无法访问模块或方法”:
纠偏:在 Python 运行时,模块(Module)、类(Class)、函数(Function)、方法(Method)全都是普通的第一类对象(First-class Objects)。点运算符统一处理所有对象成员的访问需求。例如
math.sin和instance.method背后使用的都是完全同一套属性检索机制。 - 误区三:“到处使用双下划线提高封装性”:
纠偏:滥用双下划线会导致类在继承重构、单元测试、打桩 Mock 以及序列化调试时变得异常脆弱。日常代码中,绝大多数内部变量使用单个前导下划线
_var便完全足够。
五、总结:核心规则速查清单
为了便于在日常开发中准确区分与选用,我们将下划线与点运算符的核心差异整理为如下对照清单:
| 对比维度 | 点运算符(.) |
下划线(_) |
|---|---|---|
| 语法地位 | 二元操作符(Binary Operator) | 标识符字符 / 约定符号(Identifier Character) |
| 介入时期 | 运行时(Runtime)触发属性查找机制 | 词法/编译期(Lexical/Compile time)构成名称或执行改写 |
| 底层动作 | 编译为 LOAD_ATTR / STORE_ATTR 字节码,调用 __getattribute__ |
无运算动作;仅在双前导下划线时由编译器改写属性名 |
| 承担的核心职责 | 建立访问通路:在左侧对象中寻址右侧成员 | 传递语义意图:指示内部保护、避免命名覆盖、实现系统协议 |
| 语法限制 | 左侧必须为合法对象表达式,右侧必须为有效标识符 | 可自由作为普通标识符首字符、中间字符或单独成词 |
| 典型代表场景 | math.pi、person.get_name()、pkg.submod |
_internal_val、__mangled、__str__、for _ in range(3) |
简而言之:点是“动作”——它指示解释器去哪里找属性;下划线是“属性的名字”——它告诉人和机器这个名字具有何种约定特征。理解这种“行为与名称”的分工,是编写标准、地道、健壮 Python 代码的重要基石。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















