


数据科学用Anaconda还是原生Python?场景对比分析

对于数据科学从业者而言,选择 Anaconda 还是官方原生 Python(搭配 venv 与 pip)往往决定了开发环境的搭建效率与后期维护成本。核心结论可以明确概括为:本地探索性分析、初学入门以及强依赖底层 C/C++ 与 CUDA 硬件库的场景,优先选用 Anaconda(或轻量化分支 Miniconda);而在工程化 Web 服务、微服务容器化(Docker)打包部署以及持续集成(CI/CD)流水线中,应当坚定使用原生 Python。二者并非非此即彼的替代对立,而是针对不同工作流生命周期深度优化的工具链组合。
一、核心属性与设计哲学对比
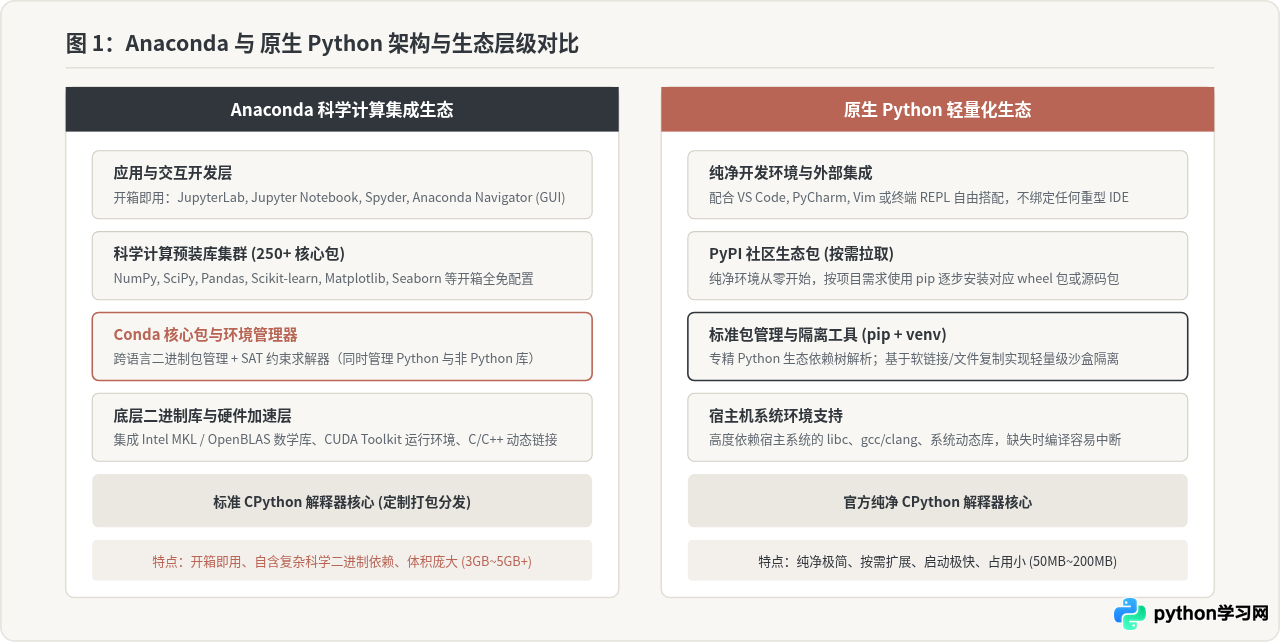
很多开发者初学时容易产生一个误解,认为“Anaconda 是另一种 Python 语言”。实际上,Anaconda 发行版内部运行的依然是官方标准的 CPython 解释器,但二者在软件分发哲学和依赖管理机制上存在根本差异。
原生 Python 秉承极简主义设计,官方安装包仅提供轻量级的运行时和核心标准库,其余所有第三方库均依靠社区 PyPI(Python Package Index)和 pip 工具按需下载。原生工具链的优势是纯粹、启动迅速且没有任何历史负担,但劣势在于当某些科学计算库依赖宿主机的 C/Fortran 编译器或底层特定硬件动态链接库时,安装极易因为缺少本地构建链而报错中断。
Anaconda 则是针对科学计算与数据分析量身定制的“重型集成套件”。它不仅打包了 Python 解释器,还捆绑了 Conda 环境管理器、图形化导航器(Anaconda Navigator),以及预先编译好的 250 多个常用科学计算核心库(如 NumPy、Pandas、SciPy、Matplotlib、Scikit-learn、JupyterLab)。更重要的是,它携带了 Intel MKL(Math Kernel Library)等高度优化的底层数学运算加速库,让用户完全无需关心系统编译器的配置问题。
二、环境搭建与包管理操作步骤对比
在实际开发过程中,两套体系的日常交互命令和项目隔离流程大不相同。以下分别列出从初始创建到环境导出的完整标准工作流程。
1. 原生 Python 工作流(基于 venv 与 pip)
原生 Python 推荐将虚拟环境建立在项目根目录内(通常命名为 .venv),通过激活脚本切换环境变量:
# 步骤 1:确认官方 Python 版本
python3 --version

# 步骤 2:在当前项目目录下创建虚拟隔离沙盒
python3 -m venv .venv

# 步骤 3:激活虚拟环境(macOS/Linux)
source .venv/bin/activate
# Windows 环境命令为:.venv\Scripts\activate

# 步骤 4:升级 pip 并按需安装数据科学基础包
pip install --upgrade pip
pip install numpy pandas matplotlib jupyterlab

# 步骤 5:冻结导出当前环境的依赖清单
pip freeze > requirements.txt
2. Anaconda / Conda 工作流
Conda 的虚拟环境默认统一由全局环境目录管理,可以通过显式参数直接指定 Python 解释器的具体版本,甚至可以在同一个系统中同时存在 Python 3.8、3.10 与 3.12 多个独立环境:
# 步骤 1:确认 Conda 运行状态
conda --version

# 步骤 2:创建指定 Python 版本的独立环境
conda create -n py310_ds python=3.10 -y

# 步骤 3:激活创建好的独立环境
conda activate py310_ds

# 步骤 4:利用 conda 通道安装科学计算库
conda install numpy pandas matplotlib jupyterlab -c conda-forge -y

# 步骤 5:导出包含底层二进制和跨语言依赖的环境配置文件
conda env export > environment.yml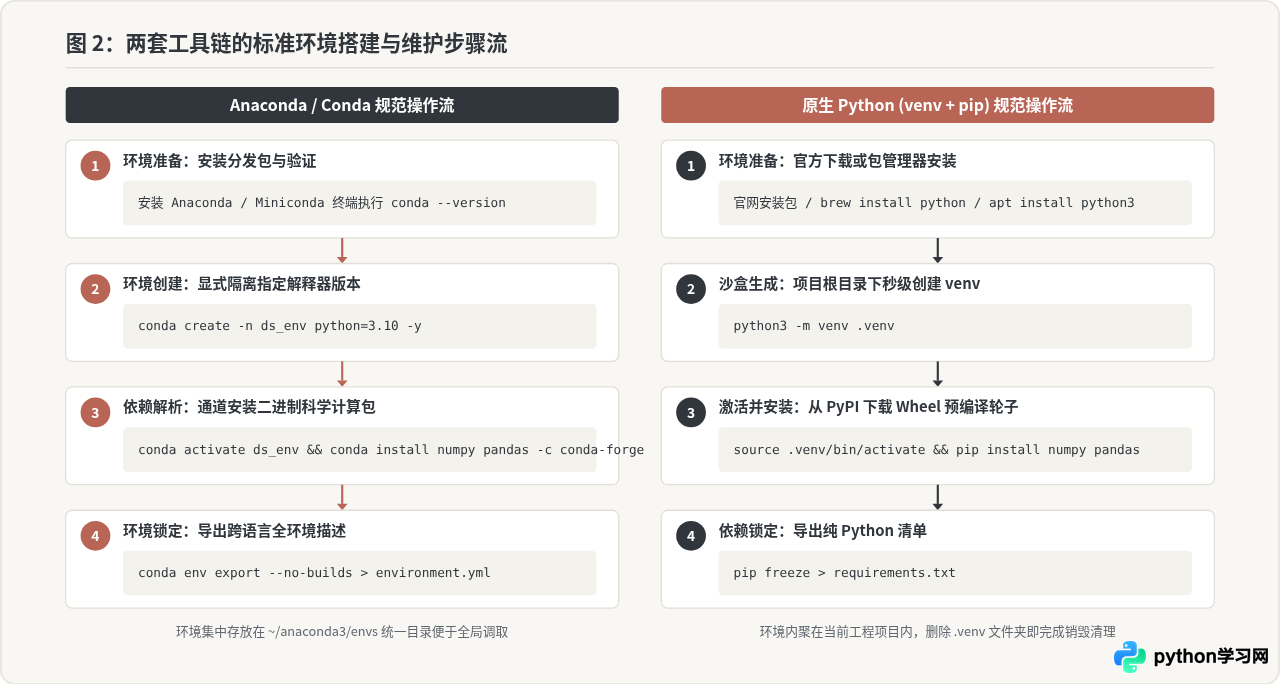
三、四大关键技术维度的深度剖析
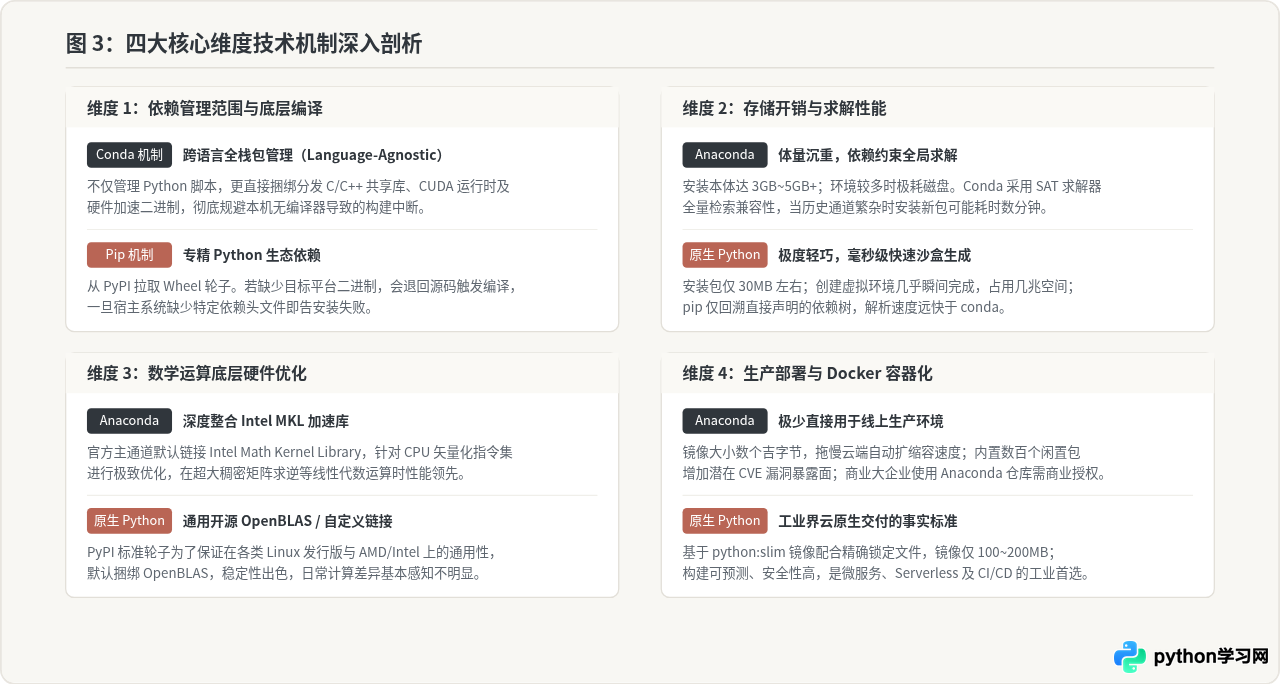
为了让选型有理有据,我们需要深入底层机制,从四个工程视角对两者进行横向解构:
1. 依赖管理范围:系统级二进制 vs Python 专用包
pip 的全称是 “Pip Installs Packages”,它的职责范围严格局限于 Python 包生态。虽然现代 PyPI 提供了大量的 .whl(Wheel)二进制预编译轮子,大大缓解了编译难题,但对于像 GDAL、Graphviz、CUDA Toolkit、HDF5 等强依赖底层系统共享库的工具,pip 往往无能为力。一旦遇到没有对应操作系统版本的 wheel,pip 会退回到下载 .tar.gz 源码包并在本机调用编译,若宿主机缺少 gcc、cmake 或指定版本的 C 库头文件,安装就会报错。
相反,conda 的定位是一个跨语言的二进制包管理器。在 Conda 看来,Python 解释器本身只是一个普通的包,甚至 C 编译器、CUDA 运行时、OpenBLAS 都是普通的包。安装一个复杂的深度学习框架时,Conda 可以直接把相匹配的动态链接库一并安装到隔离目录中,完全不污染操作系统的全局环境,也不需要开发者具备 Linux C 语言环境的编译排错经验。
2. 计算性能表现:Intel MKL 与通用编译
在涉及密集矩阵运算、SVD 分解或傅里叶变换的线性代数任务中,NumPy 的底层计算引擎至关重要。Anaconda 发行版的核心卖点之一,就是其官方源中的 NumPy 深度集成了 Intel MKL(数学核心函数库)。在 Intel CPU 架构上,MKL 能极好地发挥 AVX-512 等指令集的向量化威力。
而通过官方 pip install numpy 安装的轮子,通常默认链接的是通用的 OpenBLAS。虽然 OpenBLAS 已经非常优秀且完全能够胜任日常分析,但在特定大矩阵运算场景下,MKL 的吞吐性能可能会比 OpenBLAS 高出 10% 到 30%。可以通过在终端运行 python -c "import numpy; numpy.show_config()" 自行检验当前环境链接的具体加速库。
3. 资源占用与磁盘空间:开箱全家桶 vs 轻量小快灵
这是原生 Python 完胜 Anaconda 的维度。安装一次完整的 Anaconda,基础体积直接突破 3GB 至 5GB。随着后续不断新建项目环境,磁盘占用极易迅速膨胀到数十吉字节。此外,Conda 在执行复杂包安装时,采用的 SAT 依赖约束求解算法需要扫描通道元数据并进行全局求解,在配置较老的机器上解析耗时显著,消耗大量内存。
原生 Python 安装包通常只有 30MB 左右,利用 venv 创建一个初始虚拟环境仅需几十毫秒,占用空间只有数兆字节(仅包含必要解释器链接和基础工具)。pip 的安装过程直奔主题,极少出现卡死漫长求解的情况。
4. 生产环境部署与云原生容器化(Docker)
在后端服务化和微服务架构中,Anaconda 几乎从来不是推荐选项。构建一个基于 Anaconda 的 Docker 镜像,体积往往轻易超过 4GB~6GB。庞大的镜像体积会导致云端镜像拉取极慢、容器冷启动延迟高、CI/CD 构建流水线堵塞,并且预装的大量闲置组件还会显著增加系统的潜在安全漏洞(CVE)暴露面。
工业界标准做法是基于 python:3.10-slim 或 python:3.11-alpine 官方原生基础镜像,借助 requirements.txt 或 modern 包管理工具(如 uv、poetry)构建纯净微服务。最终镜像体积通常能控制在 150MB~300MB 以内,安全、轻便且构建迅速。
四、典型场景选型决策指南
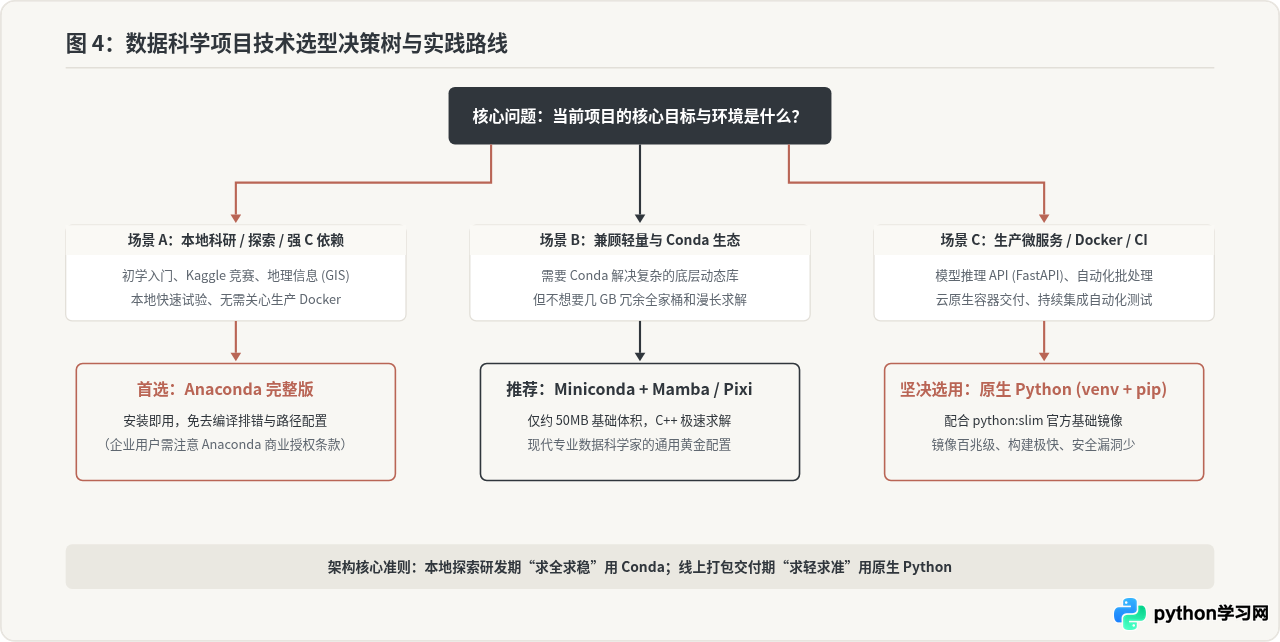
脱离具体业务与团队背景谈选型毫无意义。根据开发阶段、项目属性和团队基础设施,推荐采用以下明确的选择路径:
| 业务与技术场景 | 推荐方案 | 核心权衡依据 |
|---|---|---|
| 学生/初学者入门数据分析 | Anaconda 完整版 | 开箱即带 JupyterLab 和 Pandas,不用处理任何环境变量和终端路径报错,保护初学者的学习积极性。 |
| 本地机器学习/深度学习研发 | Miniconda / Anaconda | 方便直接通过 conda 管理 CUDA Toolkit、cuDNN 与 PyTorch/TensorFlow,避免显卡驱动和系统动态库冲突。 |
| 空间地理信息与物理建模 (GIS) | Conda (conda-forge) | GDAL、GEOS、PROJ、Cartopy 等空间库拥有极度复杂的 C++ 外部绑定,用 pip 安装极易遇到编译死锁。 |
| FastAPI / Django 模型推理服务 | 原生 Python (venv) | 生产微服务追求高吞吐、轻镜像和极简攻击面,纯净的 venv 或 Docker 容器能够杜绝冗余包带来的安全风险。 |
| 云原生微服务与 CI/CD 自动部署 | 原生 Python + uv/pip | 几秒内拉取基础镜像完成构建部署,节约云服务器带宽与冷启动耗时。 |
| 追求轻量但需 Conda 依赖的团队 | Miniconda + Mamba / Pixi | 现代推荐折中解:仅保留 50MB 的 Conda 骨架,用 C++ 重写的 Mamba 提升求解速度数十倍。 |
五、工程实操中的常见误区与避坑指南
1. 切忌在 Conda 基础环境(base)中直接执行大量 pip install
很多开发者在安装 Anaconda 后,无论做什么项目都在默认的 (base) 环境下运行,遇到 conda 没有的库就直接 pip install。这是导致环境崩溃的头号杀手!
pip 无法感知 Conda 的包元数据数据库,直接使用 pip 可能会强行替换 Conda 安装的底层基础包(如替换系统专用的 openssl、certifi 或特定版本的 numpy)。一旦底层包版本错乱,不仅新包无法运行,连 conda 命令行自身都可能因为缺少依赖而崩溃瘫痪。正确做法:无论何时,必须先通过 conda create -n my_project 建立子环境,且在子环境中优先使用 conda install,仅在 conda 通道确实没有该包时,才在最后阶段使用 pip install。
2. 明确商业授权边界(Anaconda Commercial Edition)
许多企业技术主管忽略了 Anaconda 的授权合规问题。自 2020 年起,Anaconda 修改了服务条款(TOS):在拥有超过 200 名员工或年收入达到一定规模的营利性商业组织中,直接使用 Anaconda 官方 repo.anaconda.com 默认通道下载包属于商业使用,必须购买商业许可证。
如果所在公司有严格的开源合规审查,可以采用以下两种合法免费方案替代:
- 使用纯粹的原生 Python:官方 Python 遵循 PSF 许可,完全自由免费商用。
- 使用 Miniconda 并将默认源切换为社区 conda-forge:Conda 命令行客户端本身是开源的,仅官方默认服务器有使用限制。配置
conda-forge社区通道完全免费合规。
实操总结:不要再纠结哪一个是“绝对最好”的工具。在本地机器上安装 Miniconda 并搭配 conda-forge 通道,既拥有了 Conda 处理底层复杂 C 依赖的超强能力,又避免了数个吉字节的冗余全家桶;而当项目需要固化封装为 Docker 镜像上线部署时,导出清晰的包版本清单并在原生 Python 镜像中重新构建,就是兼顾开发舒适度与工程严谨性的最优解法。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















