


Python保留字和内置函数有什么区别

Python保留字与内置函数的核心区别在于它们所处的语言层级不同:保留字(Keywords)是Python语言语法的核心骨架,属于词法分析层面的固定标记,绝对不允许被赋值或当作变量名使用;而内置函数(Built-in Functions)则是随解释器启动自动载入内存的一批预定义对象,位于最外层的内置作用域中,语法上允许被局部或全局同名变量覆盖,但覆盖后会导致原有函数无法直接调用。
一、底层机制:语法解析与作用域链的差异
为了透彻理解这两者的不同,需要先明确Python解释器在读取一段代码时经历了哪些阶段。当解释器拿到源代码字符串后,首先会通过词法分析器(Tokenizer)将其切分成一个个记号(Tokens)。在这个阶段,保留字会被直接识别为语法标记(如 DEF、IF、CLASS 等)。解释器的语法解析器(Parser)随后会根据语法树规则严格校验结构。如果发现有人尝试给保留字赋值(例如写出 def = 1),解析器在构建抽象语法树阶段就会直接拦截并抛出语法错误,甚至根本不会生成字节码。
内置函数则完全处于另一个维度。内置函数(例如 len、print、sum)在编译阶段被当作普通的标识符(Identifier)对待。直到代码实际运行时,Python按照 LEGB 规则(Local 本地作用域 → Enclosing 闭包作用域 → Global 全局作用域 → Built-in 内置作用域)进行查找。内置函数保存在名为 builtins 的模块命名空间中。只有当前面的 Local、Enclosing 和 Global 都找不到同名标识符时,解释器才会回退到内置作用域中去调用它。
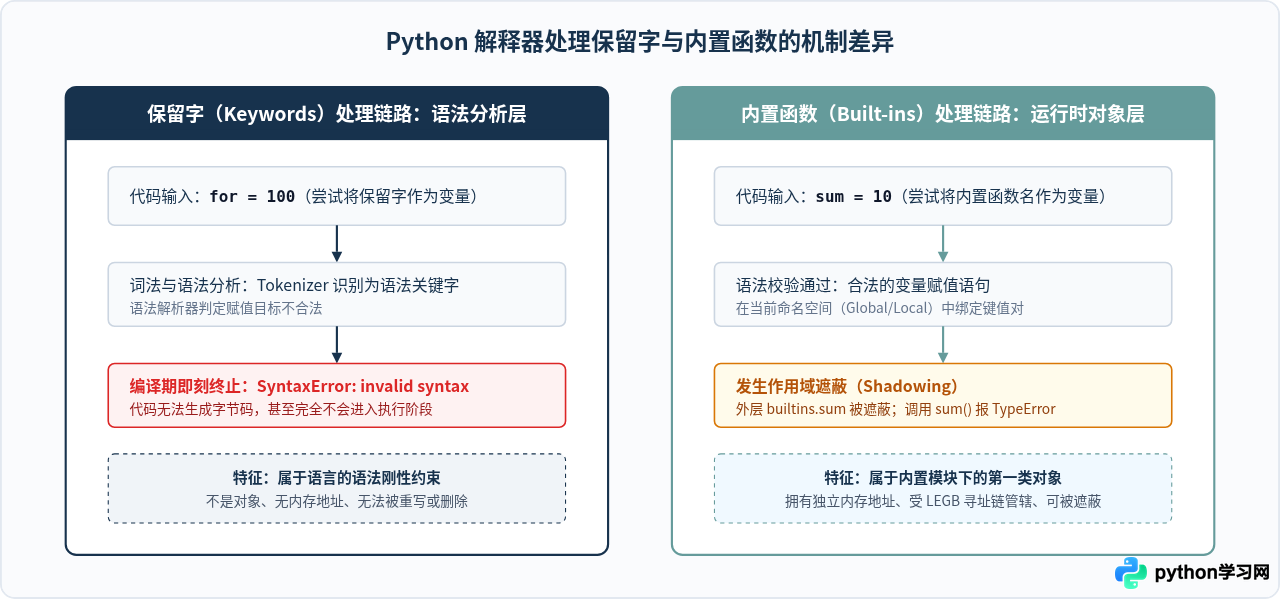
二、行为对比:赋值操作与语法报错的区别
由于两者的机制不同,直接对它们进行赋值操作时,Python会表现出截然不同的行为反馈。
1. 对保留字赋值:语法树构建失败
保留字是编写Python代码结构的固定词汇,例如 if、while、def、class、import 等。如果你尝试把保留字当成普通变量名使用,解释器会立即在编译期抛出语法错误:
# 示例代码:尝试将保留字作为变量名
def = "my_function"SyntaxError: invalid syntax
不仅是赋值,保留字也不能用作函数名、类名、方法名或导入模块的别名。这种限制是由编译器底层的词法分析硬编码决定的,没有任何语法后门可以绕过。
2. 对内置函数赋值:引起作用域遮蔽(Shadowing)
与保留字不同,内置函数(如 sum、max、min、list、str)本质上只是绑定在 builtins 作用域中的函数对象。因此,Python的语法解析器完全允许你定义同名的变量:
# 示例代码:使用与内置函数同名的变量
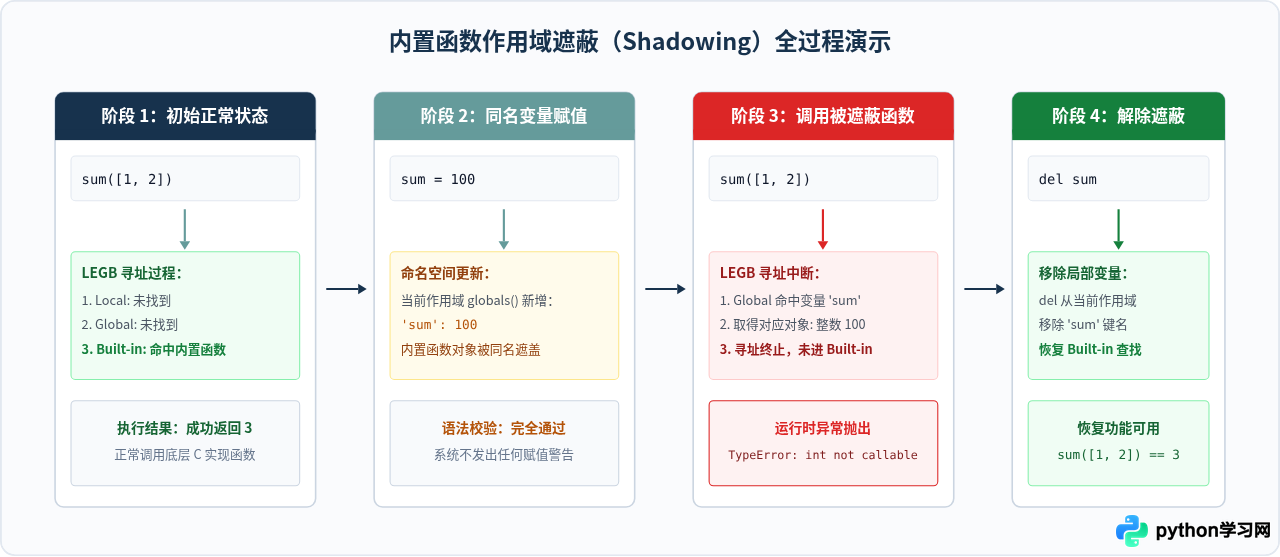
numbers = [1, 2, 3, 4, 5]
sum = 100  # 赋值成功,并未报错

# 随后尝试再次使用内置函数求和
result = sum(numbers)TypeError: 'int' object is not callable
上面的赋值语句 sum = 100 不会触发任何语法错误,因为解释器只是在当前的全局命名空间中创建了一个键为 'sum'、值为整型对象 100 的变量。然而,当后续执行 sum(numbers) 时,根据 LEGB 查找顺序,解释器在全局作用域就找到了名为 sum 的整型对象,并立即停止继续向外搜索内置作用域。随后解释器尝试像函数一样调用一个整数,因而触发了 TypeError。
三、检查方式:如何通过代码列出与验证
在日常开发与排查中,我们可以通过标准库工具分别获取当前环境下的保留字和内置函数列表。
1. 查看与判断保留字
Python通过内置的 keyword 标准库模块统一维护保留字。可以通过 keyword.kwlist 获取完整的关键字列表,或使用 keyword.iskeyword() 进行单项判定:
import keyword

# 输出当前 Python 版本的保留字总数与列表
print(f"保留字总数: {len(keyword.kwlist)}")
print(keyword.kwlist)

# 判定指定字符串是否为保留字
print(keyword.iskeyword("def"))     # 结果为 True
print(keyword.iskeyword("sum")) # 结果为 False保留字总数: 35
['False', 'None', 'True', 'and', 'as', 'assert', 'async', 'await', 'break', 'class', 'continue', 'def', 'del', 'elif', 'else', 'except', 'finally', 'for', 'from', 'global', 'if', 'import', 'in', 'is', 'lambda', 'nonlocal', 'not', 'or', 'pass', 'raise', 'return', 'try', 'while', 'with', 'yield']
True
False
2. 查看与筛选内置函数
内置函数位于 builtins 模块中。在交互式环境中也可以直接读取 __builtins__。因为 builtins 模块中同时包含内置异常类(如 ValueError)和特殊属性,若只需提取纯粹的函数或可调用对象,可以结合 callable() 和 inspect.isbuiltin() 进行过滤:
import builtins

# 筛选出 builtins 中所有内置函数与可调用类型构造器
builtin_funcs = [
    name for name in dir(builtins)
    if not name.startswith("_") and callable(getattr(builtins, name))
]

print(f"常用内置可调用对象数量: {len(builtin_funcs)}")
print(builtin_funcs[:10]) # 展示前 10 个常用内置可调用对象数量: 73
['abs', 'aiter', 'all', 'anext', 'any', 'ascii', 'bin', 'bool', 'breakpoint', 'bytearray']
四、操作指南:编写代码时的命名检查与排查步骤
在编写业务逻辑或封装工具库时,误用内置函数名是初学者甚至资深工程师经常遇到的隐蔽缺陷。按照以下四个步骤可以在开发阶段完全规避命名冲突与作用域遮蔽问题:
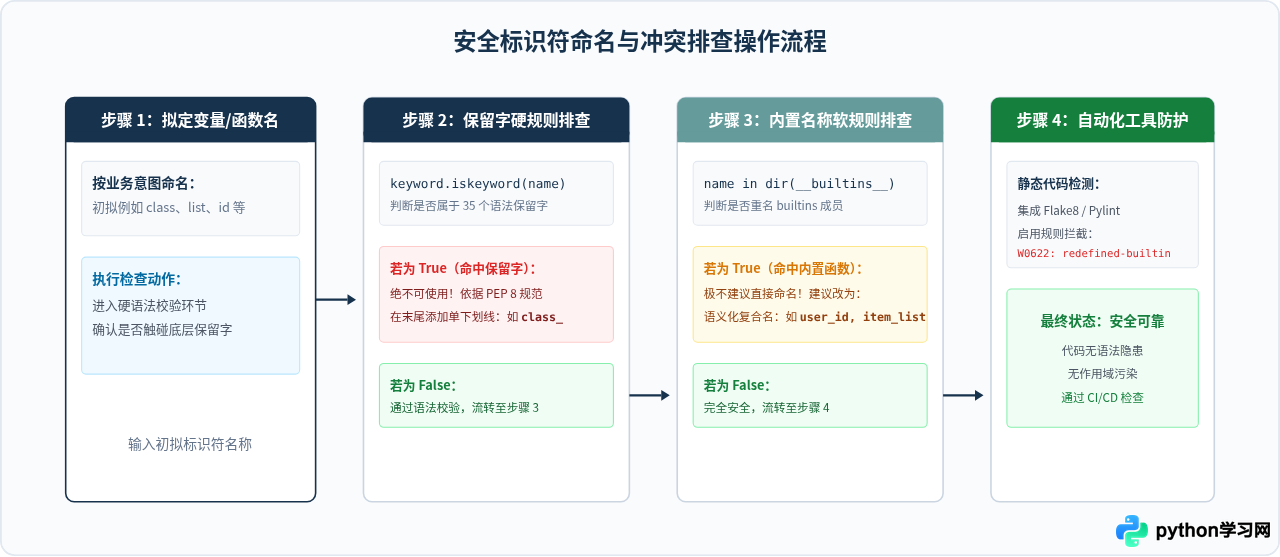
排查与补救细节:
- 必须使用与关键字相似名称时的处理:如果代码中确实需要表示类别(class)、类型(type)或逻辑分支(pass),应严格遵守 Python 官方 PEP 8 规范,在末尾加上单个下划线(例如
class_、type_、id_)。 - 误覆盖内置函数后的应急恢复:如果不小心在全局执行了
list = [1, 2, 3]导致内置list()构造器失效,可以通过del list将该全局变量删除,系统便会重新将寻址权交还给builtins作用域。或者在不删除变量的前提下,显式通过import builtins; builtins.list()访问原函数。
五、全维度对比总结
综合以上各方面的机制与表现,我们可以把保留字和内置函数的核心差异总结为下表所列的七个关键维度:
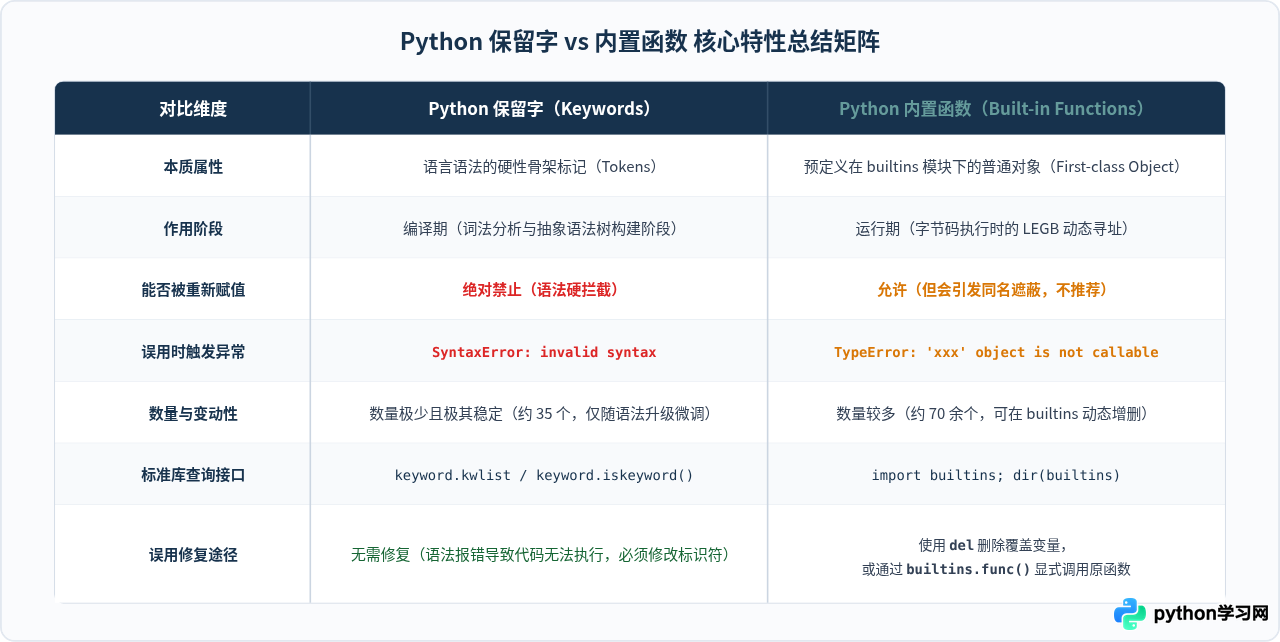
总结:保留字是构建 Python 语法的“钢筋骨架”,决定了代码结构的基本形状;内置函数则是随语言开箱即用的“内置工具箱”,属于普通的 Python 对象。区分两者的关键在于记住:保留字绝不可作为变量名赋值,而内置函数虽然语法上能被同名变量覆盖,但在编写代码时应当主动避免遮蔽,以保证程序的清晰与健壮。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















