


RAGFlow API集成开发指南:怎么在应用中调用知识库

将 RAGFlow 的知识库检索能力嵌入现有业务系统,能让应用直接基于企业内部文档回答用户问题,避免大模型幻觉并保障数据隐私。通过 API 集成,你可以灵活控制文档解析策略、召回逻辑和生成参数,实现定制化的智能问答体验。
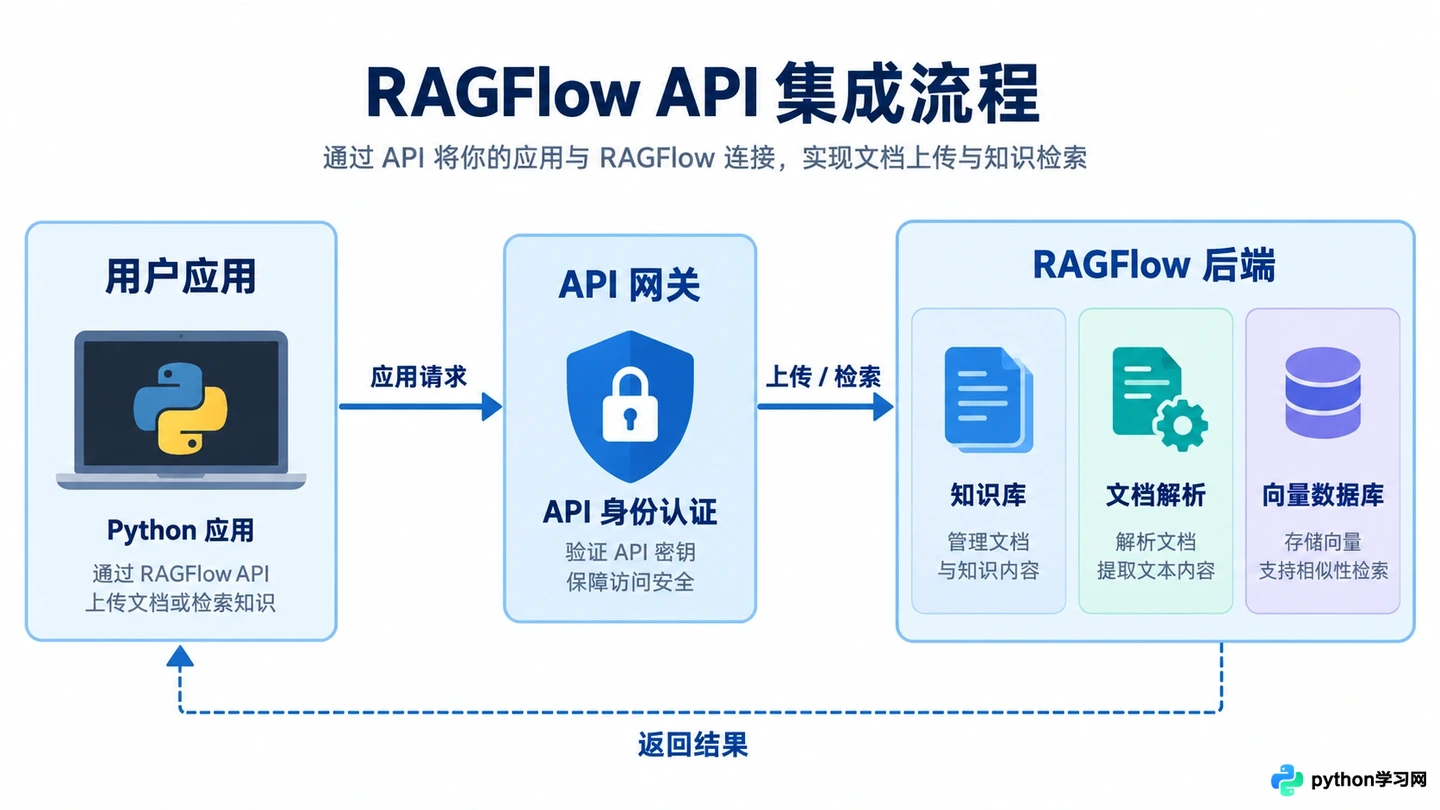
RAGFlow API 集成工作流程概览
在开始之前,确保你已部署或拥有访问权限的 RAGFlow 实例,并具备基础的 Python 开发环境。核心概念只需明确两点:Dataset(数据集)是文档的容器,Chunk(分块)是检索的最小单元。API 调用的本质就是管理这些对象并触发检索流程。
1. 获取 API Key 并配置客户端
登录 RAGFlow 前端界面,点击右上角头像进入【用户设置】或【API Keys】页面。点击“创建新密钥”,复制生成的字符串。这是后续所有请求的身份凭证,请妥善保管。
在代码中,建议使用环境变量存储 Key,避免硬编码。以下是一个基础的客户端配置示例,使用 requests 库进行演示:
import requests
import os

# 配置基础信息
BASE_URL = "http://your-ragflow-host.com/api/v1" # 替换为你的实际地址
API_KEY = os.getenv("RAGFLOW_API_KEY") # 从环境变量获取

headers = {
    "Authorization": f"Bearer {API_KEY}",
    "Content-Type": "application/json"
}
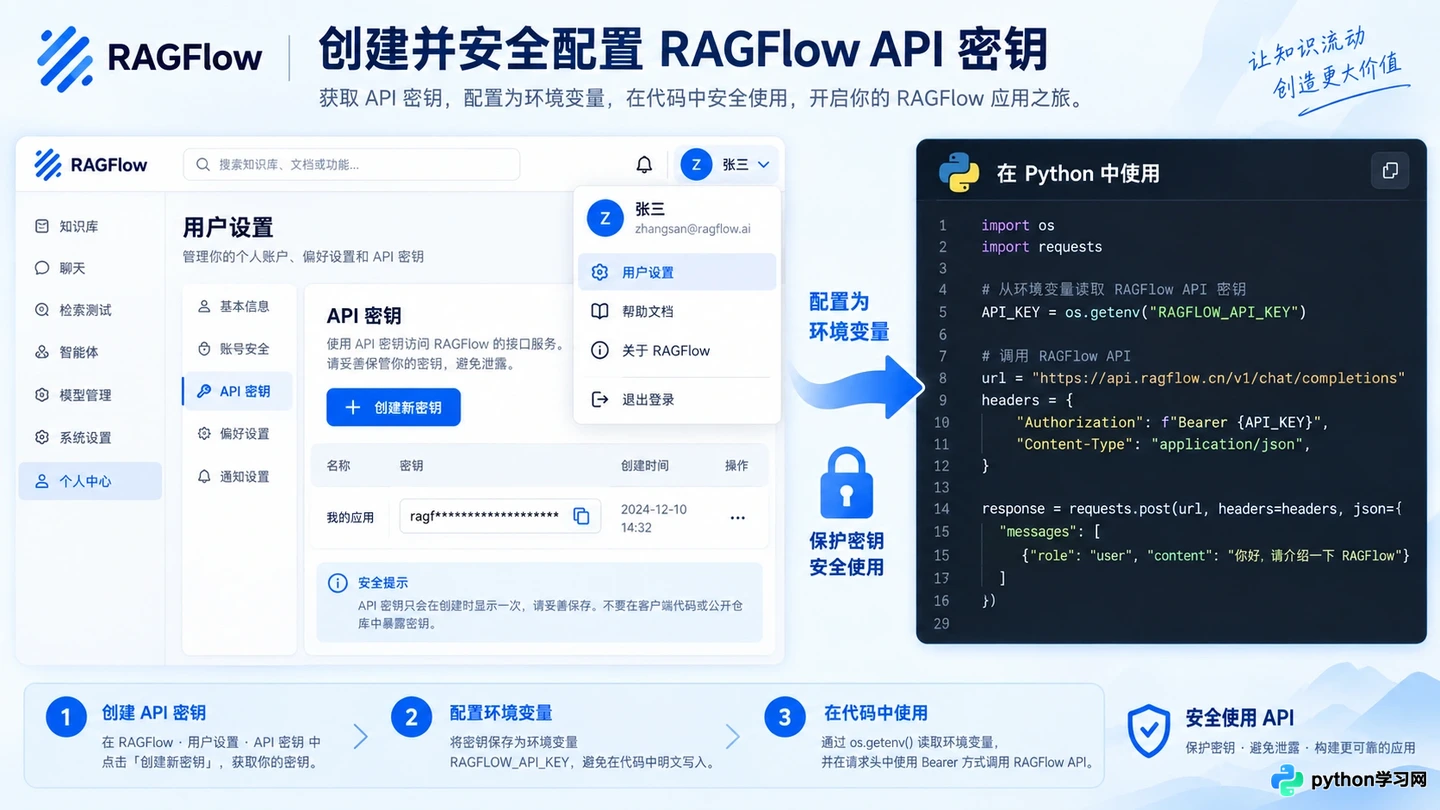
1. 获取 API Key 并配置客户端
2. 创建数据集 (Dataset)
数据集是文档的逻辑分组。在调用检索前,必须先创建一个数据集来获取其 ID。
发送 POST 请求到 /datasets 接口。你需要指定数据集名称,可选参数包括描述和权限设置。成功响应会返回包含 id 的 JSON 对象,这个 ID 在后续上传文档时必不可少。
def create_dataset(name):
    url = f"{BASE_URL}/datasets"
    payload = {
        "name": name,
        "description": "用于测试API集成的数据集"
    }
    response = requests.post(url, headers=headers, json=payload)
    if response.status_code == 200:
        data = response.json()
        print(f"数据集创建成功, ID: {data['data']['id']}")
        return data['data']['id']
    else:
        print(f"创建失败: {response.text}")
        return None

# 执行创建
dataset_id = create_dataset("My_KB_Test")
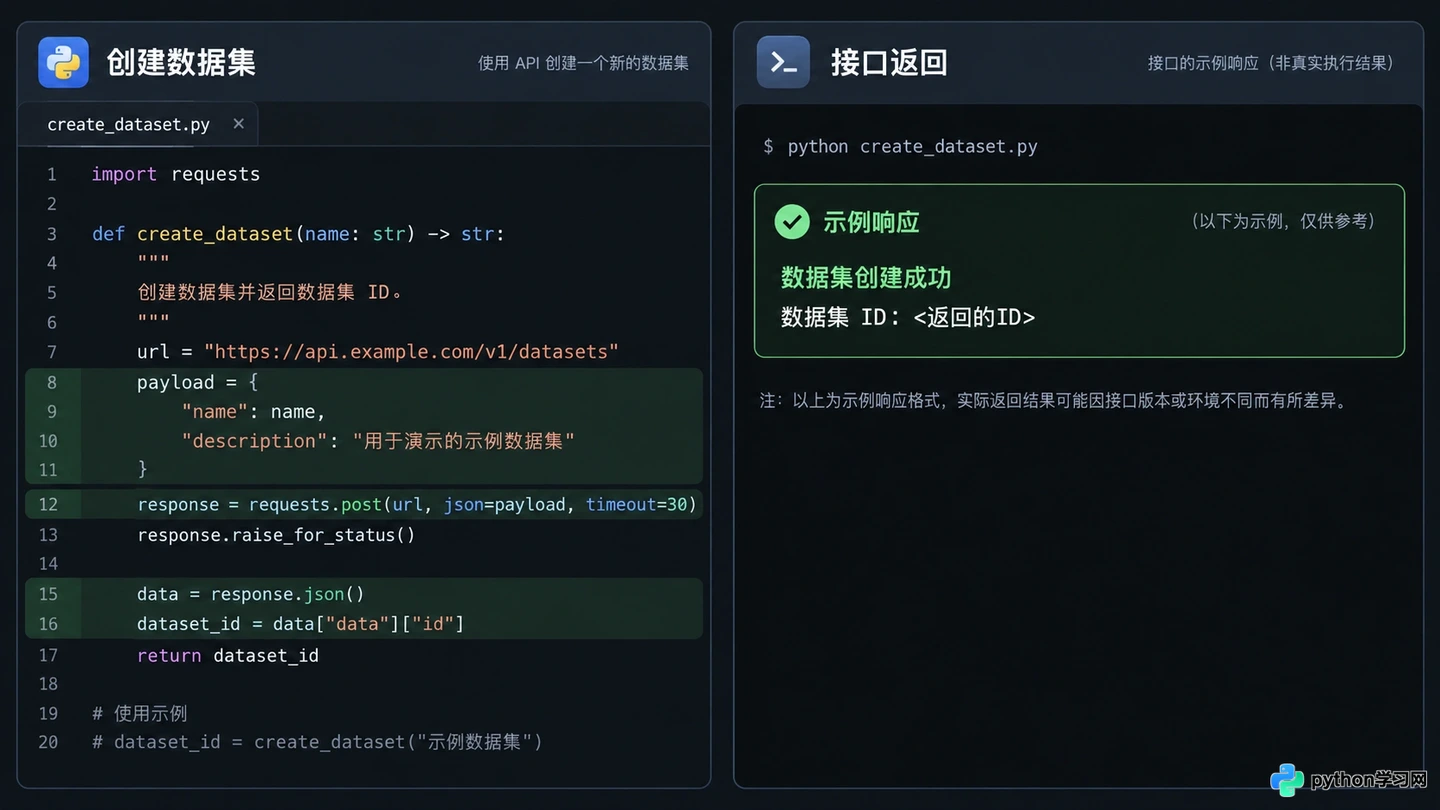
创建数据集的代码与响应截图
3. 上传文档并触发解析
有了数据集 ID,就可以上传 PDF、Word 或 TXT 等格式的文件。RAGFlow 的优势在于其深度文档解析能力,支持保留表格、图片和层级结构。
使用 POST 请求到 /datasets/{dataset_id}/documents 接口。注意,这是一个文件上传接口,需要使用 multipart/form-data 格式。上传成功后,文档处于“UNSTART”状态,需要手动或自动触发解析。
def upload_document(dataset_id, file_path):
    url = f"{BASE_URL}/datasets/{dataset_id}/documents"

    with open(file_path, 'rb') as f:
        files = {'file': (os.path.basename(file_path), f, 'application/pdf')}
        response = requests.post(url, headers={"Authorization": f"Bearer {API_KEY}"}, files=files)

    if response.status_code == 200:
        doc_data = response.json()['data'][0] # 假设单文件上传
        doc_id = doc_data['id']
        print(f"文档上传成功, ID: {doc_id}")
        return doc_id
    else:
        print(f"上传失败: {response.text}")
        return None

doc_id = upload_document(dataset_id, "./product_manual.pdf")
上传完成后,文档默认不会立即被切片索引。你需要调用解析接口。对于大多数场景,使用默认的解析方法即可;如果需要高精度表格还原,可在创建数据集时指定解析器类型,或在解析时调整参数。
def parse_document(dataset_id, document_ids):
    url = f"{BASE_URL}/datasets/{dataset_id}/chunks"
    # 注意:不同版本API路径可能略有差异,此处以常见v1路径为例
    # 实际请参照具体版本的Swagger文档,有时解析是异步自动触发的
    payload = {
        "document_ids": document_ids,
        "run": True # 触发解析任务
    }
    response = requests.post(url, headers=headers, json=payload)
    return response.status_code == 200

if doc_id:
    parse_document(dataset_id, [doc_id])
    print("已触发解析任务,请稍后查询状态或直接进行检索测试")
4. 执行检索与问答 (Retrieval & Chat)
当文档解析完成并建立索引后,就可以通过 API 发起检索。RAGFlow 提供了专门的检索接口,允许你混合使用关键词匹配和向量相似度搜索。
调用 /retrieval 接口,传入查询语句、数据集 ID 以及可选的参数如 top_k(返回片段数量)、similarity_threshold(相似度阈值)。
def retrieve_answers(dataset_id, question, top_k=3):
    url = f"{BASE_URL}/retrieval"
    payload = {
        "question": question,
        "dataset_ids": [dataset_id],
        "top_k": top_k,
        "similarity_threshold": 0.2
    }
    response = requests.post(url, headers=headers, json=payload)
    if response.status_code == 200:
        return response.json()['data']
    else:
        return None

# 测试检索
result = retrieve_answers(dataset_id, "如何重置管理员密码?")
if result:
    for chunk in result.get('chunks', []):
        print(f"来源: {chunk.get('docnm_kwd')}")
        print(f"内容: {chunk.get('content_with_weight')}\n")
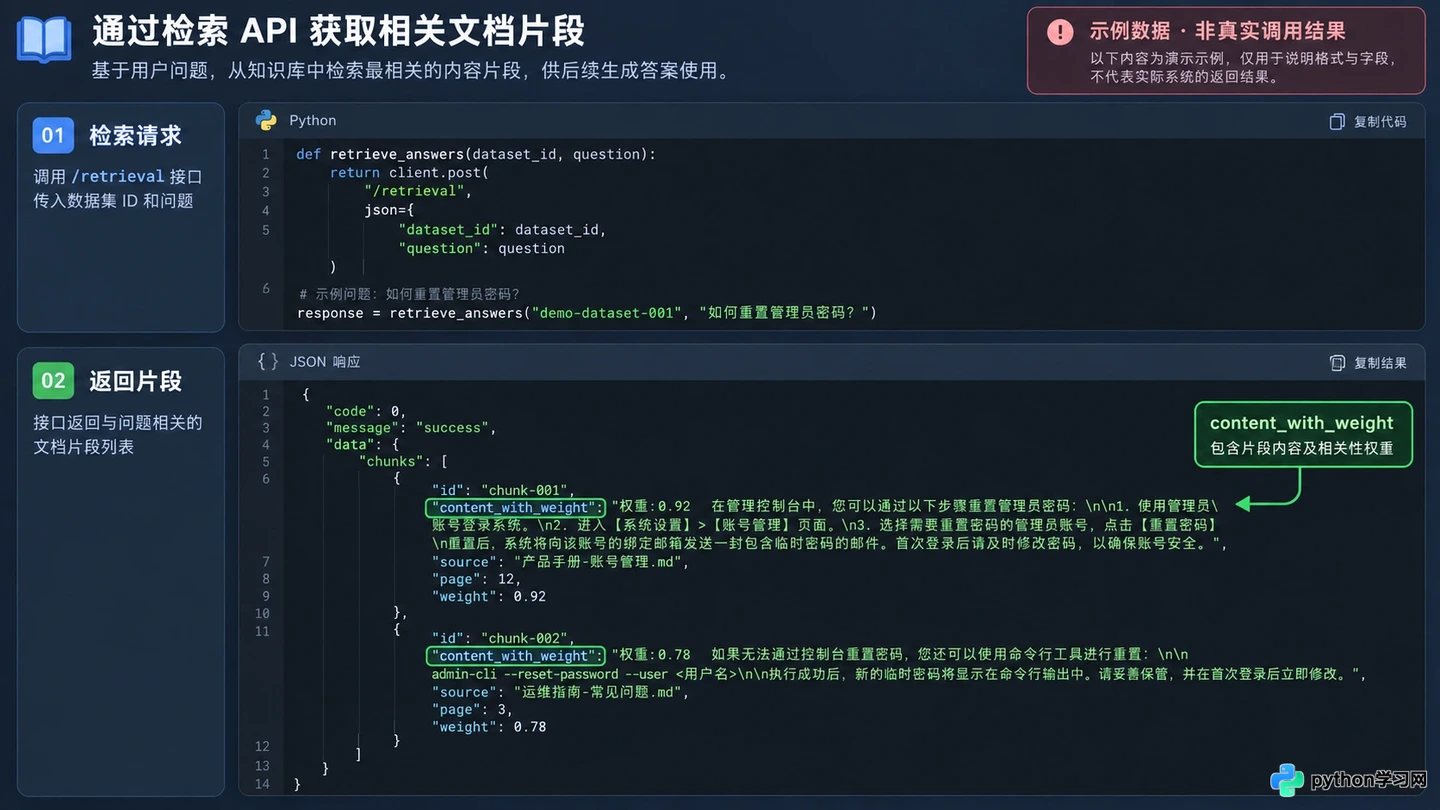
API 返回的检索片段内容
如果你希望直接获得由大模型生成的最终答案,而不是原始片段,可以调用 /chat 接口(如果当前版本支持端到端聊天)。该接口内部会自动执行检索并将结果注入 Prompt。你需要指定一个关联了知识库的 Chat ID,或者在请求中动态绑定数据集。
5. 验证集成效果与维护
完成上述步骤后,你的应用已经能够通过 API 读取知识库内容。为了确保稳定性,建议在正式环境中加入错误处理机制,特别是针对文档解析状态的轮询检查。
可以通过 /datasets/{dataset_id}/documents/{document_id} 接口查询文档的详细状态,确认 progress 字段是否达到 100% 且 status 为 “SUCCESS”。只有解析成功的文档才能被有效检索。
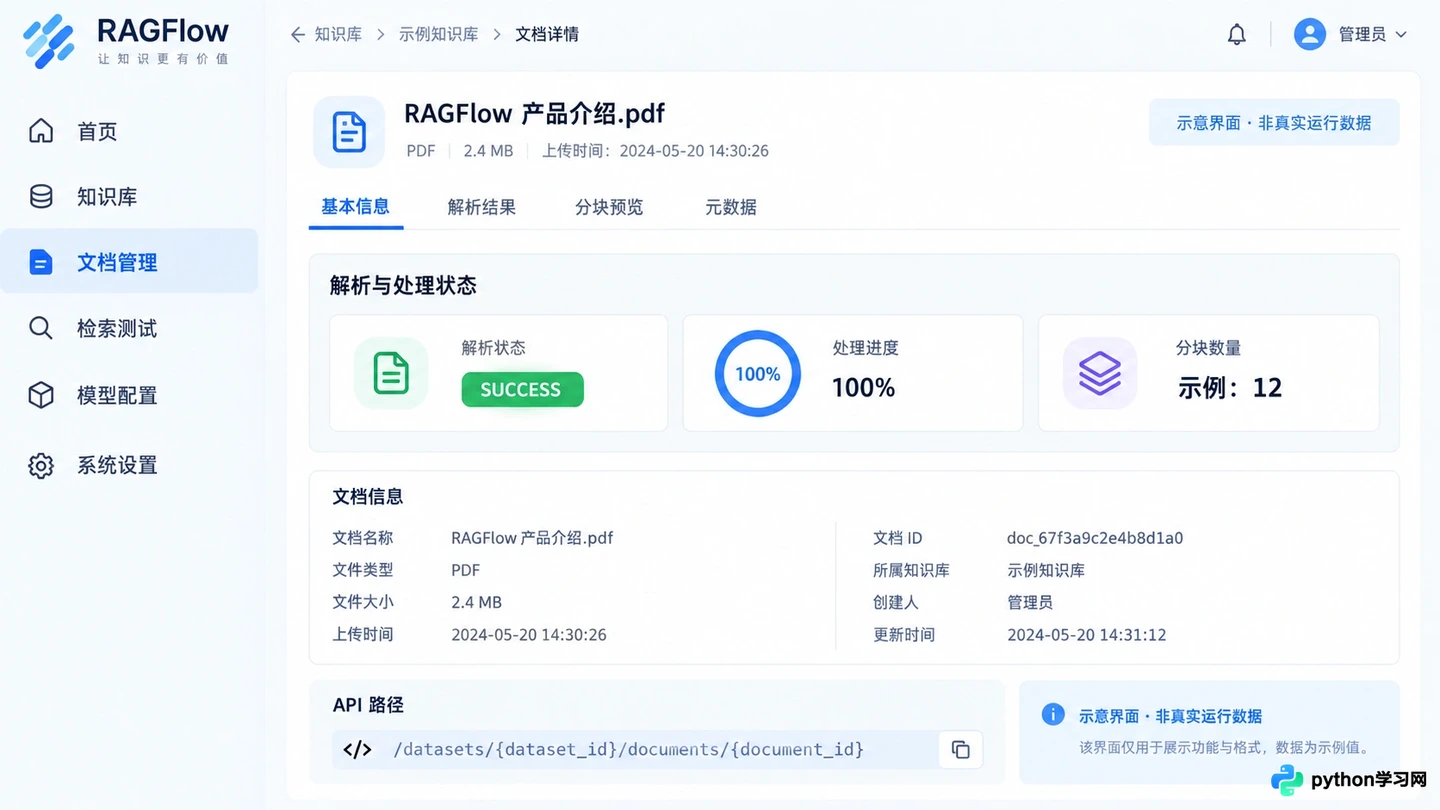
验证文档解析成功的状态检查
保留好创建的数据集 ID 和文档 ID 映射关系,便于后续更新或删除特定文档。RAGFlow 支持增量更新,当你有新版本文档时,只需重新上传并触发解析,系统会自动处理版本更替,无需重建整个数据集。这种细粒度的控制能力,正是 API 集成相比纯前端操作的核心优势。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















