


为什么不建议在Python中频繁使用全局变量赋值
深入解析为什么不建议在Python中频繁使用全局变量赋值。从LEGB作用域解析机制、隐式耦合、并发竞态、单测污染到内存驻留,全面分析全局赋值的技术隐患,并提供dataclass封装、显式传参及ContextVars等现代重构方案。
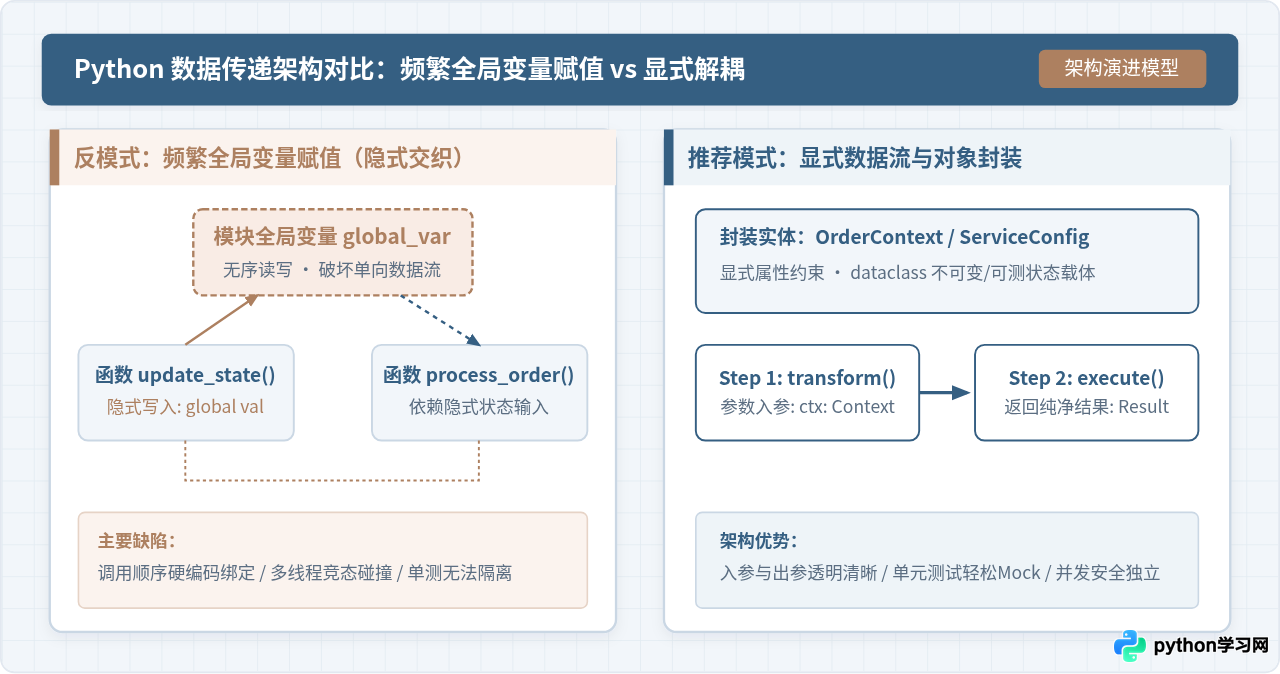
global 关键字频繁对全局变量进行重新赋值,是一种公认的反模式。这种做法不仅会打破函数的纯粹性与可预期性,在大型工程中极易引发数据竞态、测试污染、循环依赖以及令人头疼的 UnboundLocalError。本文将从 Python 解释器底层的作用域解析规则切入,逐项剖析频繁全局赋值的五大核心隐患,并给出基于数据类(dataclass)、依赖注入与上下文管理器的工程重构方案。
一、Python 变量赋值与 LEGB 作用域解析规则
要理解为什么不能随意对全局变量赋值,首先需要明确 Python 解释器在编译期和运行期是如何查找并绑定变量的。Python 采用经典的 LEGB 规则进行作用域查找:Local(函数局部)→ Enclosing(闭包外层)→ Global(模块全局)→ Built-in(系统内置)。
在 Python 中,“读取变量”与“赋值变量”遵循截然不同的处理机制:
- 只读查找:如果在当前函数局部作用域内没有同名变量,Python 会沿着 LEGB 链向外逐层搜索,直到在模块的全局字典
globals()中找到该变量。这也是为什么函数内直接读取全局常量能够正常运行的原因。 - 赋值绑定:Python 在编译函数字节码时,如果检测到函数体内存在针对某名称的赋值操作(例如
count = 1),解释器会默认将该名称标记为局部变量(Local),生成STORE_FAST字节码,而不会自动去修改外层的全局变量。
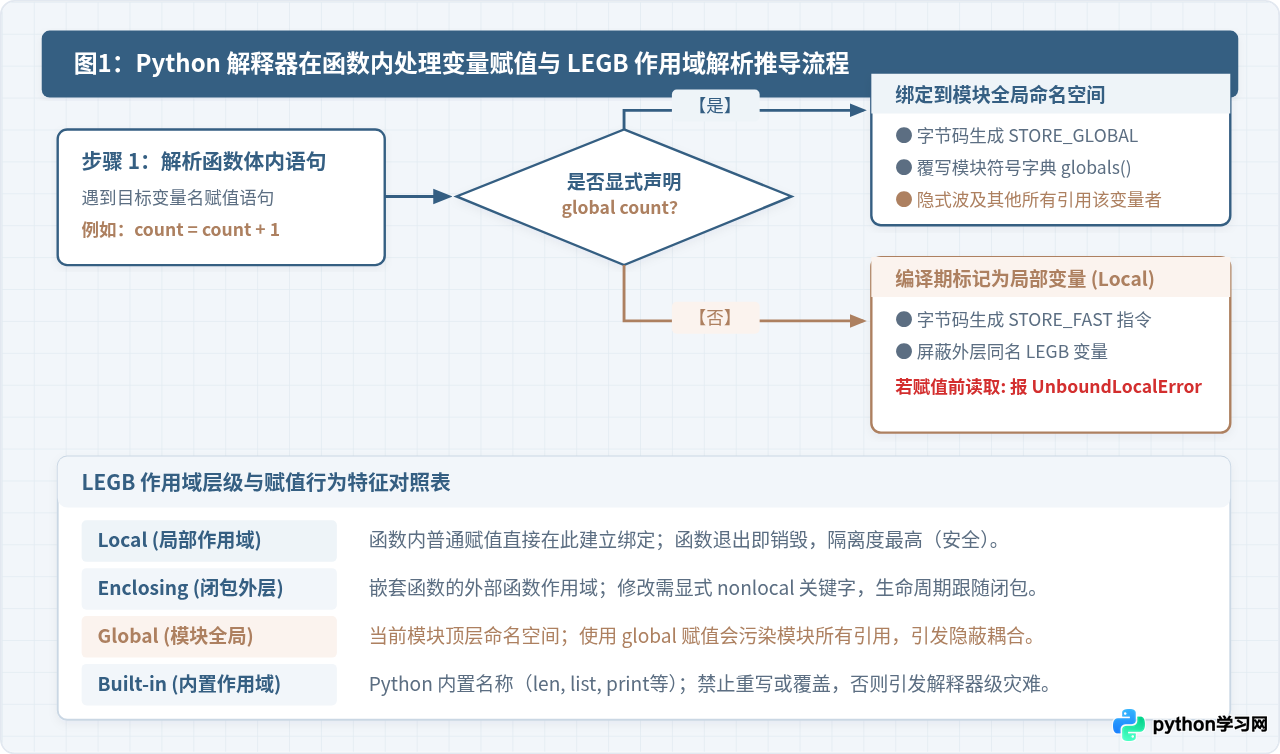
这种机制往往会导致初学者最常遇到的 UnboundLocalError。例如下方示例:
# 典型报错示例:赋值导致编译期局部绑定
total_count = 10

def increment():
    # 试图读取全局变量并自增,但下方存在赋值,导致 total_count 被标记为局部变量
    total_count = total_count + 1  # 抛出 UnboundLocalError: local variable 'total_count' referenced before assignment

increment()
很多开发者为了解决这个报错,便机械地在函数首行添加 global total_count。虽然程序表面上恢复了运行,但这正是代码走向混乱和不可控的起点。添加 global 后,解释器会生成 STORE_GLOBAL 指令,使得函数跨越局部边界,直接修改模块级别的符号表字典。当项目中多个函数都在随机改写这个字典时,灾难便随之降临。
二、频繁全局变量赋值的五大核心隐患
为什么经验丰富的工程师和主流代码规范(如 PEP 8、Google Python Style Guide)都明确反对频繁修改全局变量?以下是五种在实际生产环境中最为致命的隐患。
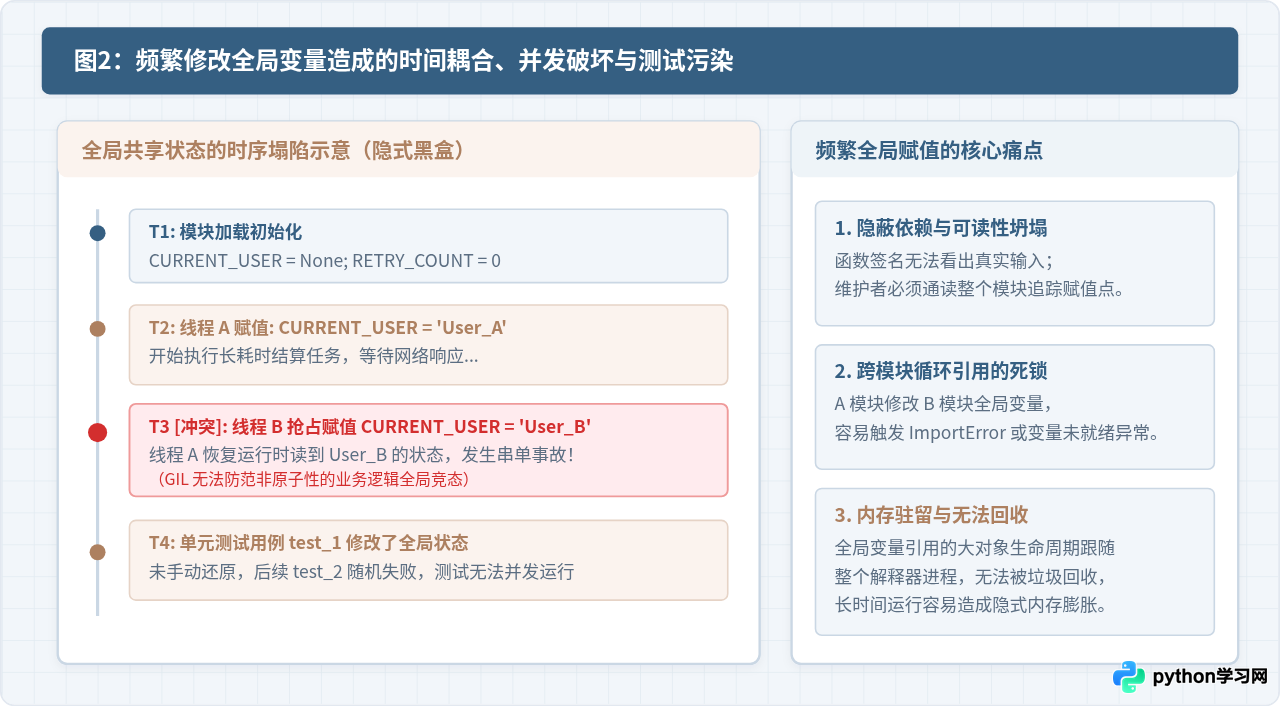
1. 隐蔽的状态副作用,摧毁函数的透明度
一个设计良好的函数应该具备“引用透明性”——其行为仅由输入参数决定,输出结果仅通过返回值体现。当函数依赖并随意改写全局变量时,它就变成了一个充满副作用的“黑盒”:
- 调用者单看函数签名
def process_order(order_id: str) -> None,根本无法得知它在后台修改了CURRENT_USER_STATUS和INVENTORY_CACHE。 - 后续接手代码的维护者必须逐行阅读所有函数的内部实现,才能梳理出全局变量在哪个时间点被谁修改,认知负荷呈指数级上升。
2. 时序强耦合与难以复现的幽灵 Bug
当多个函数共享并写入同一个全局变量时,代码的正确执行完全依赖于特定的调用先后顺序。例如函数 A 必须在函数 B 之前执行,而函数 C 绝不能在 A 和 B 之间被触发。一旦业务逻辑变动调整了调用流程,或者引入了条件分支跳过了某个初始化步骤,就会产生数据脏读,这种时序 Bug 在线下排查时极难复现。
3. 单元测试无法隔离,测试套件相互污染
在自动化测试中,每个测试用例(Test Case)都必须保持独立与隔离。然而,全局变量的生命周期与整个 Python 进程相同:
- 用例
test_case_a()在执行过程中修改了全局变量的值; - 紧接着运行的用例
test_case_b()就会读取到上一个用例残留的脏数据,导致断言失败; - 开发人员不得不编写大量脆弱的
setUp()和tearDown()逻辑去重置全局变量;更糟糕的是,这使得多进程/多线程并发跑测试(如pytest -n 4)成为不可能。
4. 多线程并发下的竞态条件与数据损坏
很多初学者误以为 Python 拥有全局解释器锁(GIL),多线程操作就是安全的。事实绝非如此:GIL 仅保证单个字节码指令执行的原子性,并不保证多行 Python 逻辑乃至单个复杂表达式的原子性。
import threading

counter = 0

def worker():
    global counter
    for _ in range(100000):
        # counter += 1 包含三步字节码:LOAD_GLOBAL, BINARY_ADD, STORE_GLOBAL
        # 线程切换可能发生在其中任何一步,导致严重的数据丢失
        counter += 1

threads = [threading.Thread(target=worker) for _ in range(5)]
for t in threads: t.start()
for t in threads: t.join()

print(f"预期计数: 500000, 实际计数: {counter}")
# 示例输出:预期计数: 500000, 实际计数: 312845(数据发生静默破坏)5. 模块循环引用死锁与内存无法释放
在模块化开发中,如果模块 A 内部修改模块 B 的全局变量,模块 B 又反向引用模块 A 的状态,非常容易引发 Python 的 ImportError: cannot import name ... 循环导入死锁。同时,全局变量挂载在模块字典下,生命周期贯穿进程始末。若将一个庞大的数据集或字典频繁赋值给全局变量,其引用的对象无法被 Python 的垃圾回收器(Garbage Collector)及时清理,容易引发内存泄漏或内存膨胀。
三、从全局赋值到结构化架构的重构实操
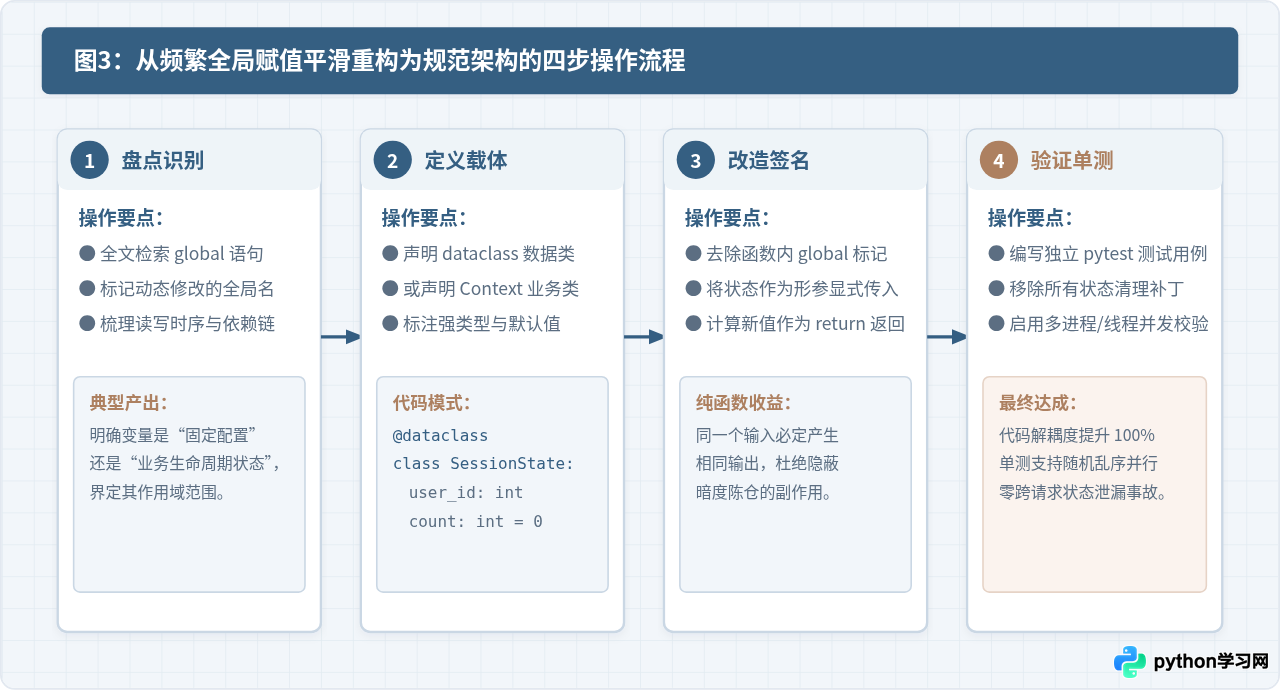
面对现有的全局变量赋值代码,如何规范地进行平滑重构?下面通过一个完整的重构案例,展示标准四步迁移流程。
反面案例:使用全局变量串联业务流程(重构前)
下面是一个订单结算模块的旧代码,业务流程通过模块级全局变量 current_order 和 discount_rate 进行流转与动态修改:
# anti_pattern.py - 充满 global 赋值的旧代码
current_order = None
discount_rate = 1.0

def init_order(order_id: str, amount: float):
    global current_order, discount_rate
    current_order = {"id": order_id, "amount": amount, "status": "PENDING"}
    discount_rate = 1.0

def apply_coupon(coupon_code: str):
    global discount_rate
    if coupon_code == "VIP90":
        discount_rate = 0.9
    elif coupon_code == "SUPER80":
        discount_rate = 0.8

def finalize_payment() -> float:
    global current_order
    if not current_order:
        raise ValueError("订单未初始化")
    final_amount = current_order["amount"] * discount_rate
    current_order["status"] = "PAID"
    current_order["paid_amount"] = final_amount
return final_amount该代码存在的核心缺陷:无法并发处理两个订单;调用 finalize_payment() 之前若未调用 init_order() 会引发运行时崩溃;两个测试用例同时跑必然互相践踏。
正面规范:四步重构实战
第一步:识别状态生命周期并定义实体数据类
将原本分散在全局作用域中的动态状态聚集为一个强类型的上下文对象。在现代 Python(3.7+)中,使用 dataclass 是最简洁优雅的方式:
from dataclasses import dataclass
from typing import Optional

@dataclass
class OrderContext:
    order_id: str
    amount: float
    discount_rate: float = 1.0
    status: str = "PENDING"
    paid_amount: Optional[float] = None
第二步:改写函数签名为显式入参与纯粹返回值
消除所有函数内部的 global 关键字。函数需要什么数据,就从参数传入;产生了什么变更,就通过返回值或者明确的方法变迁输出:
class OrderService:
    @staticmethod
    def calculate_discount(coupon_code: str) -> float:
        if coupon_code == "VIP90":
            return 0.9
        if coupon_code == "SUPER80":
            return 0.8
        return 1.0

    @classmethod
    def apply_coupon(cls, ctx: OrderContext, coupon_code: str) -> OrderContext:
        rate = cls.calculate_discount(coupon_code)
        ctx.discount_rate = rate
        return ctx

    @classmethod
    def process_payment(cls, ctx: OrderContext) -> float:
        final_amount = round(ctx.amount * ctx.discount_rate, 2)
        ctx.status = "PAID"
        ctx.paid_amount = final_amount
        return final_amount
第三步:调用端显式创建与管理上下文
业务调用方负责实例化 OrderContext。因为每个订单都是一个独立的实例,并发处理完全互不干扰:
# 业务消费端
def handle_checkout(order_id: str, amount: float, coupon: str) -> float:
    # 状态局限在局部作用域中,随请求结束自动销毁
    ctx = OrderContext(order_id=order_id, amount=amount)
    OrderService.apply_coupon(ctx, coupon)
    paid = OrderService.process_payment(ctx)
    return paid
第四步:编写零副作用的独立单元测试
无需任何全局状态清理,单测简单、纯净且能多线程并行:
def test_order_payment_with_vip_coupon():
    ctx = OrderContext(order_id="ORD-001", amount=100.0)
    OrderService.apply_coupon(ctx, "VIP90")
    amount = OrderService.process_payment(ctx)
    assert amount == 90.0
    assert ctx.status == "PAID"

def test_order_payment_without_coupon():
    ctx = OrderContext(order_id="ORD-002", amount=200.0)
    amount = OrderService.process_payment(ctx)
    assert amount == 200.0
    assert ctx.status == "PAID"
四、常见替代方案与设计选型决策
放弃全局变量赋值后,面对不同的业务场景,应当如何选用合适的状态传递方案?
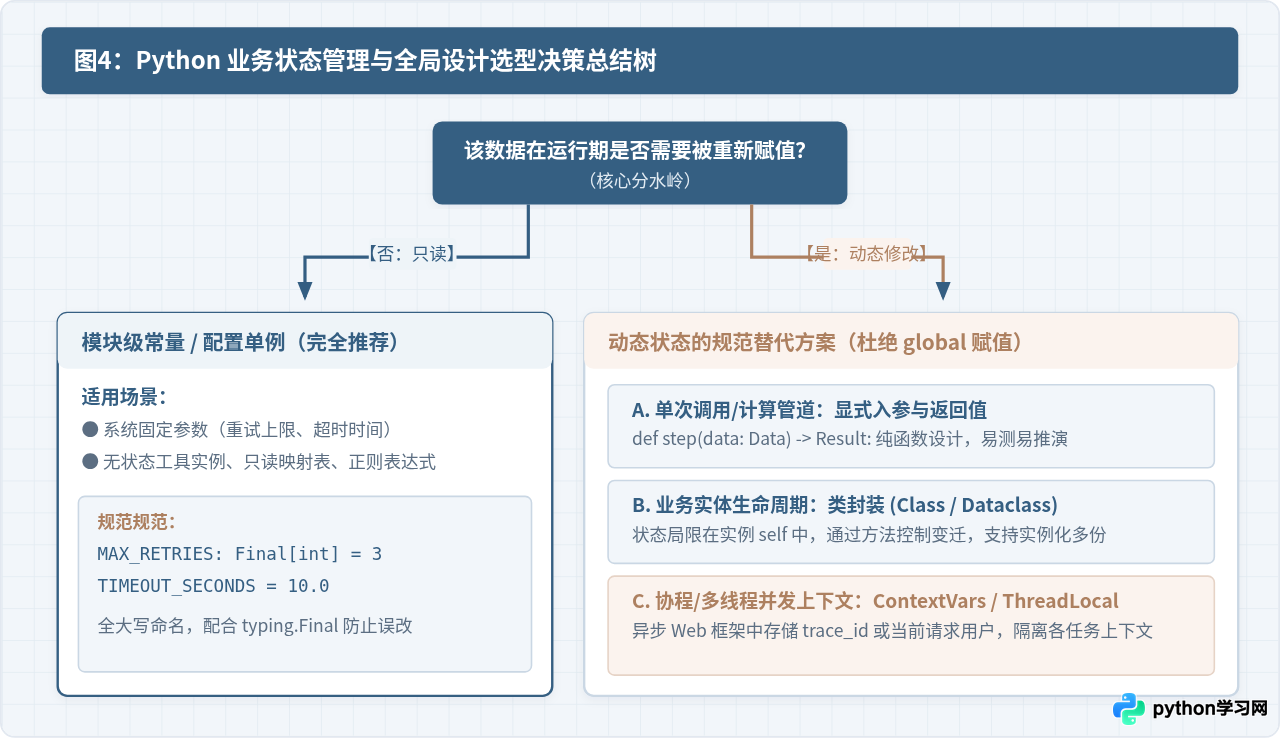
| 设计模式 / 工具 | 适用场景 | 状态隔离级别 | 代码示例 / 关键特征 |
|---|---|---|---|
| 模块级只读常量 | 应用配置、业务枚举、系统阈值、正则表达式编译对象 | 进程级共享(只读不可改) | MAX_RETRY: Final[int] = 3使用全大写命名,禁止运行时重新赋值 |
| 函数参数与返回值 | 无状态计算、纯数据转换流水线、工具函数 | 调用栈级(完全隔离) | def transform(data: T) -> R:输入输出明确,单元测试成本最低 |
| 类封装与实例属性 | 具有独立生命周期的业务实体、状态机、服务组件 | 对象实例级(互不干扰) | self.state = new_state封装属性与行为,支持多实例并发共存 |
| ContextVars (上下文变量) | 异步 Web 框架请求链路追踪、TraceId、当前会话 | 异步协程 / 任务链隔离 | from contextvars import ContextVar在 asyncio 并发环境下天然安全隔离 |
| 依赖注入 / 配置容器 | 数据库连接池、外部微服务客户端、复杂系统依赖 | 应用生命周期受管 | 集中在入口组装,通过构造参数显式向下分发 |
五、常见疑问与边界场景(FAQ)
1. 模块级常量(如 MAX_CONNECTIONS = 10)属于全局变量吗?能用吗?
属于全局作用域变量,但完全可以使用。业界所反对的是“频繁对其进行运行时重新赋值”的动态修改行为。在顶层定义的只读常量(如数值、字典映射、模板字符串)只在模块初次导入时解析一次,所有函数只读不写,具有高度的确定性与缓存亲和力。建议使用 typing.Final 予以显式标注,配合 mypy 等静态类型检查工具防范无意修改。
2. 编写几十行的单文件自动化小脚本,可以使用 global 吗?
在几十行的一次性探索脚本或算法验证原型中,为了快速出结果,偶尔使用一两次 global 并不致命。但一旦脚本的逻辑行数超过百行、需要维护或者后续可能被其他模块 import 引用时,应立刻将其封装为函数入参或类。工程规范的价值恰恰在于防范简单脚本演变成难以维护的“遗留系统”。
3. 为什么有时不写 global,也能修改全局列表或字典?
这是一个非常经典的 Python 语义陷阱:就地修改(In-place Mutation)与重新赋值(Re-binding)的区别:
- 当执行
config["timeout"] = 5或item_list.append(item)时,并没有修改变量名config本身的指向,而是通过变量名索引到了全局对象并修改其内部状态。因此即使不声明global,Python 也不会报错。 - 这种在函数内部隐蔽修改全局可变容器(Mutable Objects)的做法,其危害甚至大于直接使用
global赋值,因为代码连显式的global警示标记都没有,隐藏得更深。 - 最佳防范:对于全局只读数据,使用不可变类型如
tuple、types.MappingProxyType或frozen=True的 dataclass 进行保护,防止任何意外的就地篡改。
六、总结
Python 语言设计精炼自由,global 关键字提供了直接接触全局符号表的通道,但这种便利性往往伴随着高昂的工程维护代价。在软件工程中:
- 显式优于隐式(Explicit is better than implicit):通过明确的入参和返回值传递数据,让代码流向一目了然。
- 收敛状态作用域:将数据的生命周期严格限制在需要它的最小作用域内(从 Local 函数局部到 Class 实例)。
- 区分只读配置与动态状态:全局空间只留不可变常量,动态变迁的状态全部沉淀至结构化对象中。
遵循这几条核心准则,就能从根本上消除由全局变量赋值引发的各类疑难杂症,编写出健壮、可读、易测且具备优秀并发性能的高质量 Python 程序。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















