


Python数据分析相比Excel有什么优势:工具特点与局限性对比

一、数据规模与计算性能的边界对比
Excel 作为主流电子表格软件,单个工作表有着严格的物理行数限制(1,048,576 行,即 2 的 20 次方)和列数限制(16,384 列)。当数据记录超过几十万行,或者工作簿内嵌套大量复杂计算公式(例如数组公式、跨表 VLOOKUP 或 XLOOKUP)时,Excel 容易出现内存占用居高不下、滚动卡顿甚至未响应假死的情况。其数据存储模型要求将所有单元格及其图形对象完整驻留在内存中,限制了吞吐大批量记录的能力。
Python(结合 pandas、polars 及 numpy 等生态库)将数据与视图展示彻底解耦。内存中的数据结构以高密度的连续内存块(C 语言层数组)组织,消除了单元格元数据的开销。更关键的是,Python 支持“流式分块读取”(chunking)与内存映射机制,能够以固定的小内存窗口逐批计算数十 GB 乃至数亿行的日志数据,突破了桌面端硬件的物理限制。
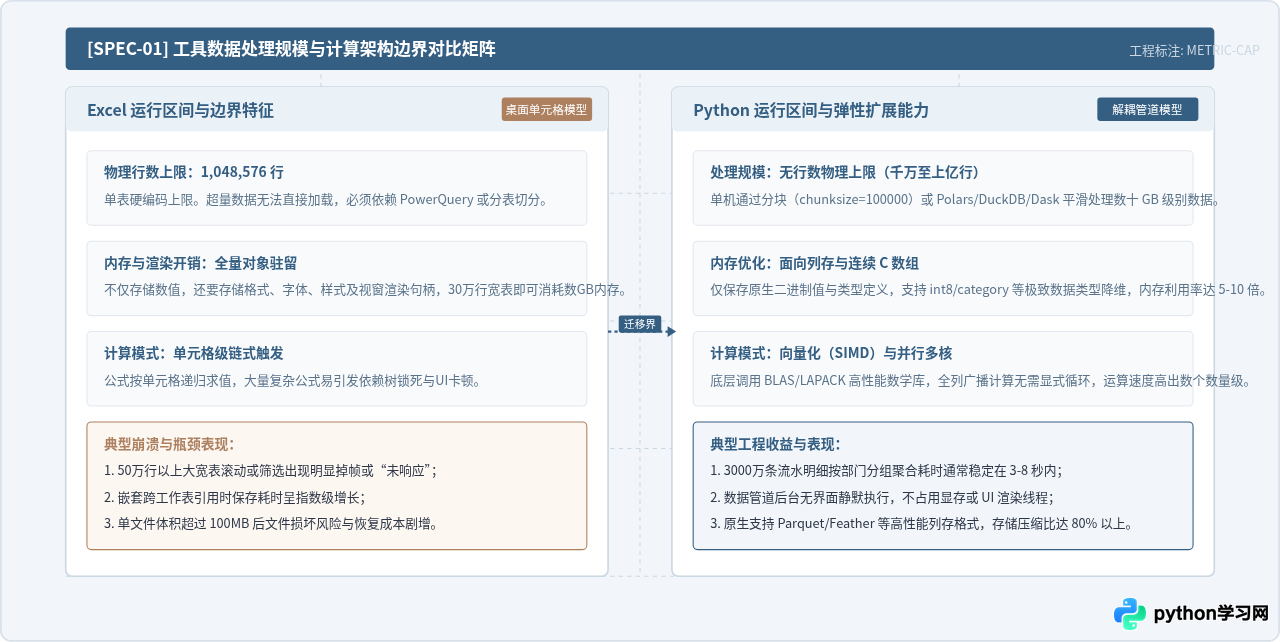
在实际工程中,当分析人员需要合并 12 个月份、每个月份包含 20 万行销售流水时,Excel 文件会膨胀到数百兆,公式计算耗时拉长,甚至因内存溢出引发崩溃。而在 Python 中,通过简短的代码即可进行流式批量合并与聚合统计,如下所示:
import pandas as pd
import glob

# 批量加载 12 个月份的销售明细(总计超 200 万行)
file_list = glob.glob("sales_2024_*.csv")
df_list = [pd.read_csv(f, usecols=["order_id", "date", "dept", "amount"]) for f in file_list]
full_sales = pd.concat(df_list, ignore_index=True)

# 向量化聚合计算:按部门与月份汇总营收与客单价
monthly_summary = (
    full_sales.assign(month=pd.to_datetime(full_sales["date"]).dt.to_period("M"))
    .groupby(["month", "dept"])
    .agg(total_revenue=("amount", "sum"), order_count=("order_id", "count"))
    .reset_index()
)
# 毫秒级输出干净结构
print(monthly_summary.head())
二、流程复现性与自动化流水线差异
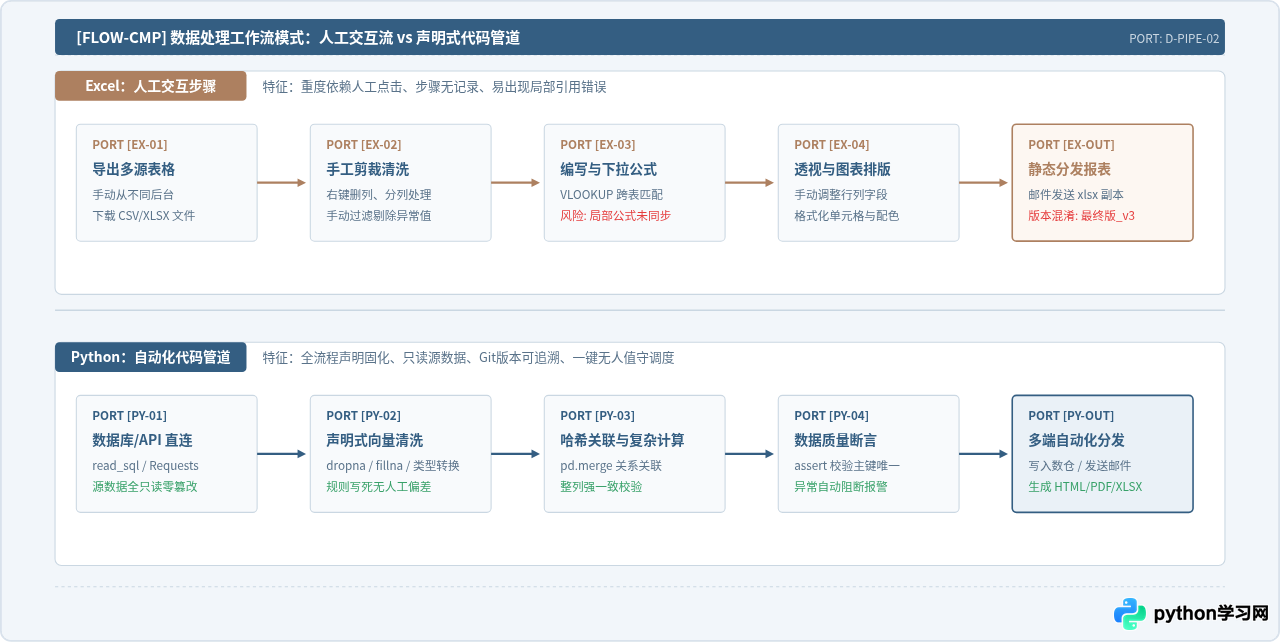
在日常报表生成中,许多团队经常陷入“周报噩梦”:每周一需从系统中导出原始 CSV,打开 Excel 执行分列、删除无用列、填充缺失值、使用 VLOOKUP 匹配维表、手动拖动公式、刷新数据透视表并重新调整图表格式。这一过程存在三大痛点:
- 操作黑盒化与不可溯:中间所有的清洗修改直接覆写在网格中,无法判断某一行数据是被误删还是被规则过滤。
- 单元格逻辑脆弱:一旦某一行公式未正确下拉填充,或者插入了新行列导致相对引用偏移,错误往往隐蔽且难以排查。
- 高耗时无价值重复:一旦源数据表头调整或跨周期生成,全部步骤必须重新人工执行一次。
Python 构建的是“确定性数据流水线”(Deterministic Pipeline)。每一个数据加工步骤(清洗、格式转换、逻辑过滤、关联聚合)都被显式声明在脚本文件中。源数据永远保持只读,清洗逻辑作为代码纳入 Git 进行版本控制。每次遇到新数据,仅需输入新文件路径并重新执行脚本,即可在数秒内得到结构完全一致的最终产物。
三、复杂计算、扩展生态与两者的局限性
除了规模与自动化,二者在计算能力的上限上存在本质代差。Excel 能够胜任四则运算、描述性统计(均值、中位数、分位数)、查找匹配以及常规回归趋势线。然而,一旦业务分析进入现代算法领域,Excel 就显得力不从心:
- 高阶统计与假设检验:在 Python 中调用
scipy.stats,可一行代码完成双样本 t 检验、卡方检验、Mann-Whitney U 检验及 ANOVA 方差分析; - 时间序列建模与预测:利用
statsmodels或prophet,可快速拟合带有节假日效应、季节性波动的 ARIMA 与加法模型; - 非结构化数据处理:Python 可直接处理文本分类、正则表达式批量提取、图片元数据解析以及大语言模型 API 批处理,这些是传统电子表格无法原生支持的领域。
过度神化 Python 往往会导致团队在落地中受挫。必须明确认识到 Python 带来的客观局限:
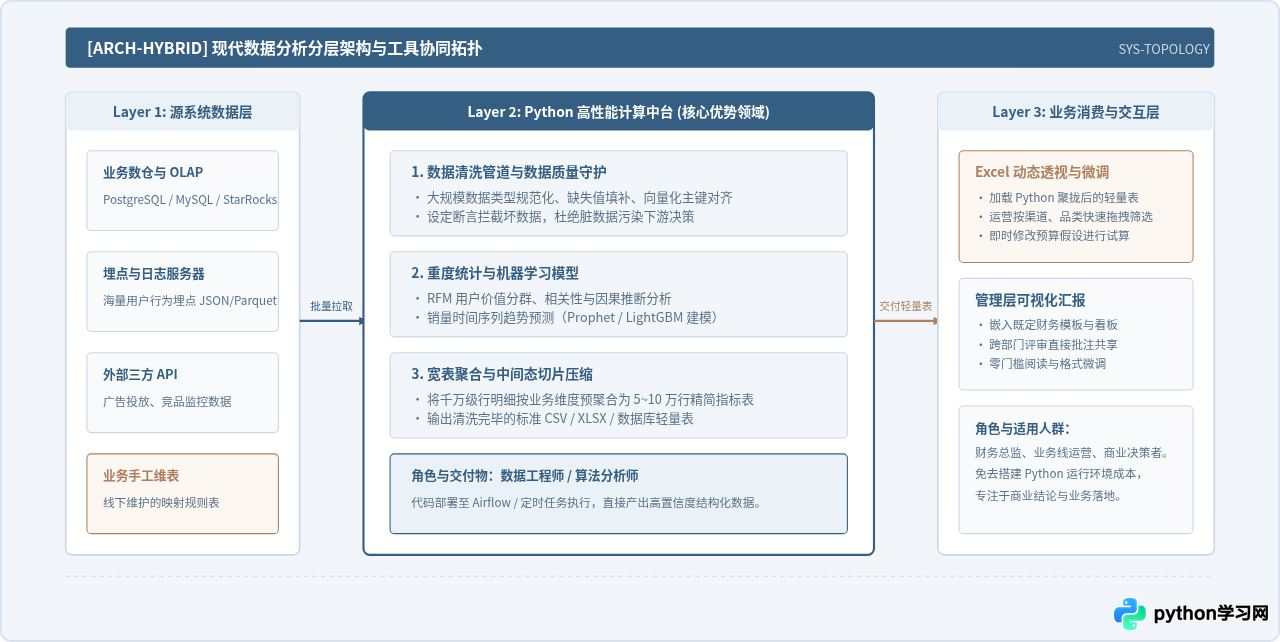
- 环境依赖与配置成本:Python 依赖解释器版本、虚拟环境(venv/conda)以及第三方库版本兼容性。常常出现“在开发者电脑上能运行,在同事电脑上报依赖冲突”的问题。
- 即时可视交互与微调门槛:若业务人员只需快速扫一眼前 20 条异常记录、手动调整某个单元格假设进行“What-If”测算,Excel 只需双击直接改动,几秒即可验证;而在 Python 中则需要修改代码、过滤索引、打印结果或重新绘图,效率反而更低。
- 团队协作与沟通摩擦:在绝大多数商业企业中,业务、财务、管理层不具备代码阅读能力。直接交付
.py文件或 Jupyter Notebook 会形成严重的沟通壁垒,而.xlsx文件则是通用的商业事实标准。
因此,成熟的数据团队通常采用“Python 负责重度计算与中台沉淀,Excel 负责末端交互与业务微调”的混合协同架构,使两种工具各自发挥最大效能。
四、工具选型决策依据与判断路径
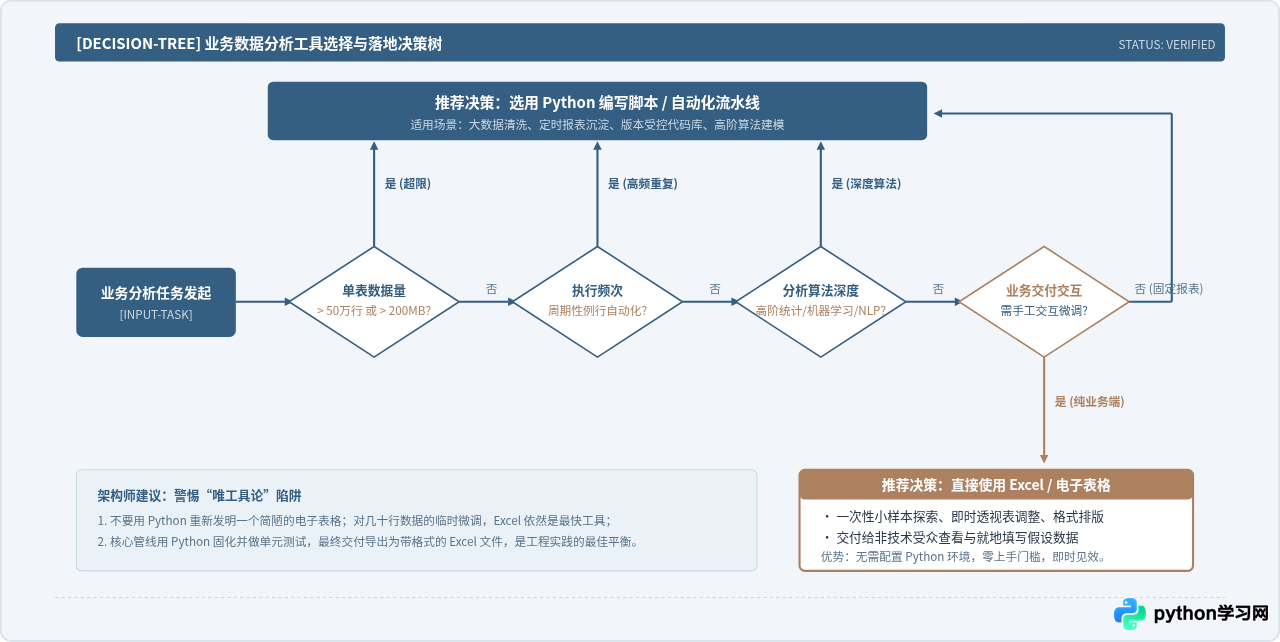
在实际工作中,分析师往往面临“是用 Excel 搞定还是写 Python 脚本”的权衡。为了避免过度工程化(如对仅有几十行的小表格强行写几十行代码)或工具选型不当导致的生产力瓶颈(如用 Excel 硬啃百万行明细),建议依据以下四个关键指标建立决策边界:
| 评估维度 | 推荐使用 Excel 的场景 | 推荐转向 Python 的场景 |
|---|---|---|
| 数据行数规模 | 数据量小于 10 万行,可在单机表格内平滑加载并流畅计算。 | 数据量大于 50 万行,或需要跨多个大文件、多张表频繁关联。 |
| 任务复用频次 | 一次性探索、临时抽查、即兴“What-If”敏感性测算。 | 周期性执行的任务(如每日、每周、每月定时复跑的固定报表)。 |
| 计算与模型深度 | 基础加减乘除、分组聚合、描述性统计及标准财务公式。 | 需要进行高级回归分析、聚类算法、时间序列预测或正则文本清洗。 |
| 交付与协作对象 | 非技术背景的业务主管、客户或财务审计人员,需频繁微调单元格。 | 交付给数仓系统、自动化邮件服务,或团队成员具备代码管理能力。 |
为了帮助读者快速判断手头任务的最佳落地方式,以下决策流程图梳理了从业务需求输入到工具选型的关键判断节点:
五、总结与落地建议
Python 与 Excel 并不是取代与被取代的单一对立关系,而是数据分析能力演进过程中的不同支点。
当数据分析需求聚焦于业务感知、即时调整和跨部门通用查看时,Excel 凭借极低的学习曲线、所见即所得的直观布局和灵活的图表表现,依旧是商业运作中最普及的基础设施;而当业务规模扩张,面对百万级以上海量日志、复杂的算法预测模型或每周耗费数小时的手工重复清洗任务时,Python 提供的脚本化管道、严格的版本追溯和工业级计算生态,则是突破生产力瓶颈的关键武器。
理想的数据实践不是盲目淘汰 Excel,而是以 Python 筑牢底层数据流转与算法中枢的根基,同时借助 Excel 保持前台商业互动的敏捷性,让代码的严谨性与表格的灵活性协同发力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















