


Python读取Excel指定行列时怎么处理合并单元格

在使用 Python 读取 Excel 文件的指定行或列时,最常遇到的意外结果是读取出来的值变成了 None(或者 pandas 中的 NaN)。出现这种情况的核心原因在于:在 Excel 底层存储规范中,合并单元格区域内的数据只保存在最左上角的单元格中,区域内的其余单元格物理上都是空单元格。要准确获取指定行列中的真实数据,关键在于建立“坐标与合并区域的映射逻辑”:当目标行列坐标落在某个合并区域内时,重定向读取该区域左上角锚点单元格的值,或者在批量读取前通过前向填充完成数据补全。
为什么直接读取合并单元格会返回 None
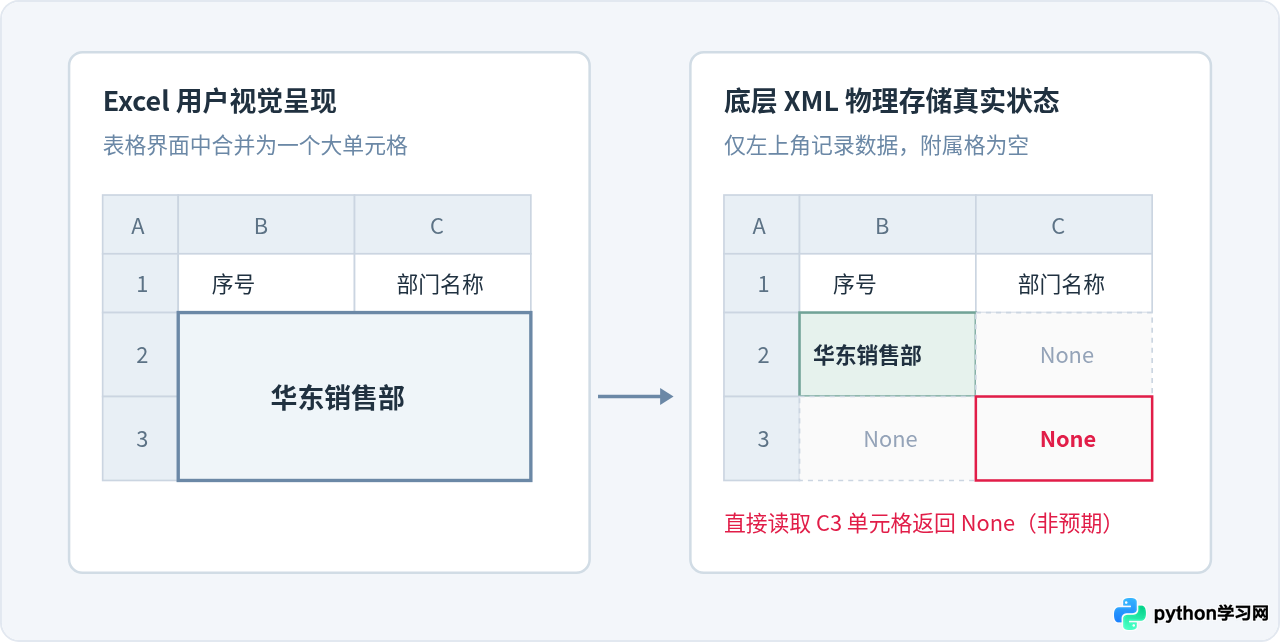
日常在 Excel 界面中查看表格时,多个单元格合并后看起来形成了一个整体的大矩形,视觉上内容填满了整片区域。但如果解压 .xlsx 文件查看其内部的 XML 源码,会发现 Excel 只是把这片矩形定义成了一个合并区域(例如 B2:C4),实际的文本内容仅写入在 B2 单元格内,而 B3、B4、C2、C3、C4 要么完全没有记录,要么值直接为空。
这就解释了为什么用 Python 读取指定位置时容易踩坑:当你通过 sheet.cell(row=3, column=3).value 尝试读取第 3 行第 3 列(即 C3)时,Python 会如实返回该单元格的物理存储值,即 None,而不是直觉中看到的合并内容。
方案一:使用 openpyxl 定位并读取合并区域的锚点值
如果业务需求是读取指定行、指定列或指定单格(例如第 4 行第 2 列),使用 openpyxl 的合并区域范围对象进行动态寻址是最标准、最节约内存的做法。
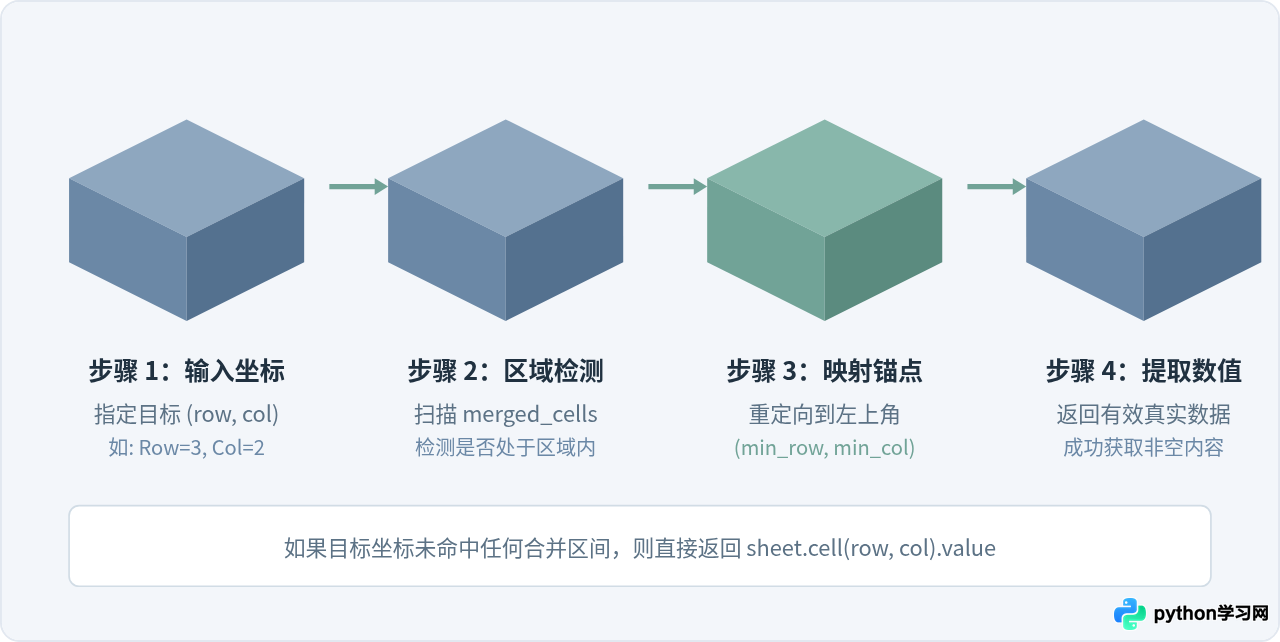
openpyxl 的 Worksheet 对象提供了 ws.merged_cells.ranges 属性,它包含当前工作表中所有合并区域的定义。每一个合并区域都有起始行 min_row、起始列 min_col、结束行 max_row 和结束列 max_col。我们只需判断目标行列是否落入某个区域;如果命中,直接提取 (min_row, min_col) 处的值。
1. 读取指定单个单元格的封装函数
下面是一个封装好的函数,输入指定的工作表、行号和列号,自动处理是否处于合并单元格中的情况:
import openpyxl

def get_merged_cell_value(sheet, row: int, col: int):
    """
    读取指定行列的单元格值。如果处于合并单元格中,则返回左上角锚点单元格的值。

    :param sheet: openpyxl 的 Worksheet 对象
    :param row: 目标行号(从 1 开始)
    :param col: 目标列号(从 1 开始)
    :return: 单元格对应的真实数据值
    """
    # 遍历当前工作表中的所有合并单元格区域
    for merged_range in sheet.merged_cells.ranges:
        if (merged_range.min_row <= row <= merged_range.max_row and
                merged_range.min_col <= col <= merged_range.max_col):
            # 命中合并区域,读取左上角单元格的值
            return sheet.cell(row=merged_range.min_row, column=merged_range.min_col).value

    # 不属于任何合并区域,直接读取对应位置
    return sheet.cell(row=row, column=col).value

# 示例调用
wb = openpyxl.load_workbook("example.xlsx", data_only=True)
ws = wb.active

# 读取第 3 行第 2 列
target_val = get_merged_cell_value(ws, row=3, col=2)
print("读取到的结果:", target_val)
2. 读取整行或整列数据
当需要读取整行(例如第 5 行)或整列(例如第 B 列)时,不能直接切片遍历原始单元格,而应该结合上述映射逻辑遍历该范围内的所有坐标:
def get_entire_column_values(sheet, col: int, start_row: int = 1, end_row: int = None):
    """
    读取指定列的整列数据,自动填充合并单元格值
    """
    if end_row is None:
        end_row = sheet.max_row

    column_data = []
    for r in range(start_row, end_row + 1):
        column_data.append(get_merged_cell_value(sheet, row=r, col=col))
    return column_data

def get_entire_row_values(sheet, row: int, start_col: int = 1, end_col: int = None):
    """
    读取指定行的整行数据,自动填充合并单元格值
    """
    if end_col is None:
        end_col = sheet.max_column

    row_data = []
    for c in range(start_col, end_col + 1):
        row_data.append(get_merged_cell_value(sheet, row=row, col=c))
    return row_data
如果 Excel 合并单元格的内容是通过公式计算生成的,必须在
openpyxl.load_workbook() 中传入 data_only=True。否则 openpyxl 只会读取到公式字符串本身(如 =SUM(A1:A5)),而不是计算后的最终数值。
方案二:使用 pandas 配合 ffill 处理批量数据
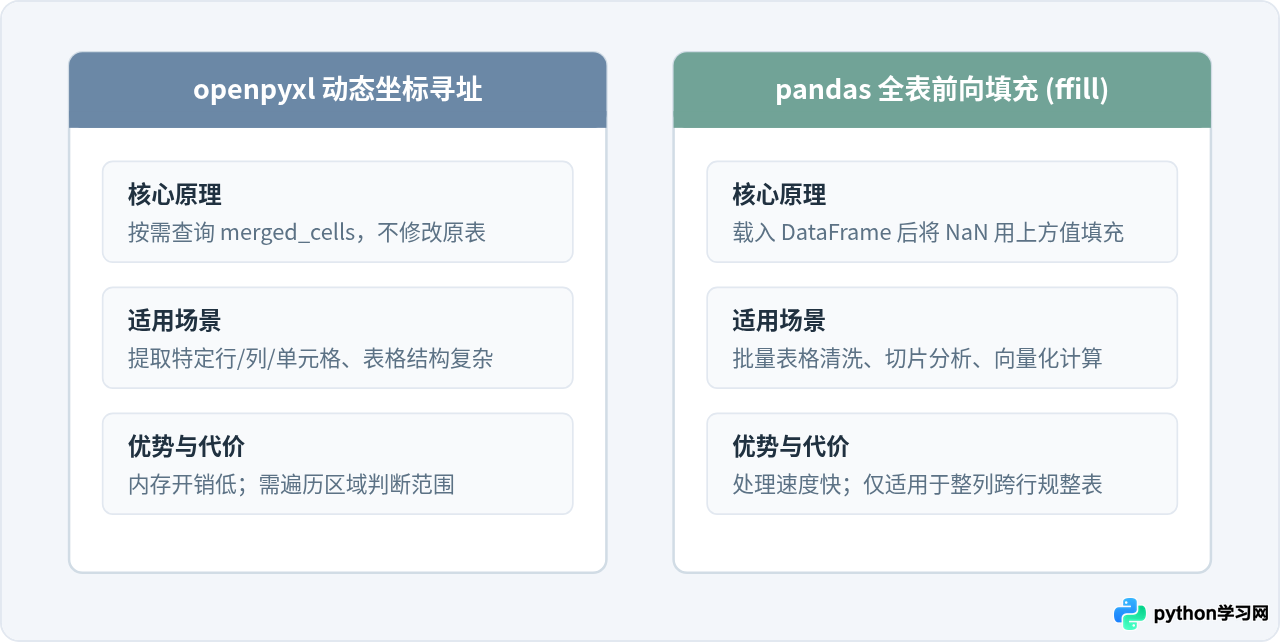
在数据分析与报表清洗场景中,如果需要读取整个工作表或较大的子区域,并按行、列切片进行统计计算,使用 pandas 的前向填充功能(ffill)会更为简洁高效。
当使用 pd.read_excel() 导入包含跨行合并的表格时,合并区域除首行外其余行会自动被解析为 NaN。此时利用 ffill() 可以沿垂直方向将上一行的非空值直接向下填充到所有的空值单元格中,使整张表规整化。
pandas 处理合并单元格示例代码
import pandas as pd

# 读取 Excel 文件
df = pd.read_excel("example.xlsx")

# 针对包含纵向合并单元格的列(如“部门名称”和“团队”)进行向下填充
columns_to_fill = ["部门名称", "团队"]
df[columns_to_fill] = df[columns_to_fill].ffill()

# 此时可以按正常逻辑读取指定行或列
# 读取第 3 行数据(对应索引 2)
row_3 = df.iloc[2]
print("第 3 行完整数据:\n", row_3)

# 读取“部门名称”列的前 5 项
dept_col = df["部门名称"].head(5)
print("部门名称前 5 项:\n", dept_col)
df.ffill()如果有些普通单元格本身就是合法的空值(例如某位员工没有填写“备注”或“固定电话”),盲目使用全局
df.ffill() 会导致这些正常空值被错误地填充为上一行的内容。因此建议显式指定需要前向填充的合并列名。
实战处理合并单元格时的关键注意事项
在实际开发过程中,处理合并单元格不仅要考虑读取逻辑,还要注意以下常见边界情况:
- 行列索引计数差异:
openpyxl的行列坐标是从 1 开始的(即第 1 行是 1,A 列是 1),而pandas.iloc的切片是从 0 开始的。在混合使用或转换逻辑时务必注意偏移量。 - 横向合并与纵向合并的区别:纵向合并单元格跨越多行(同列),补全时使用的是向下填充(ffill 轴向为 index);而横向跨列合并时(如标题栏合并 A1:E1),若要读取整列,应使用向右填充(
axis=1)。 - 反合并并写回原文件:如果希望把读取清洗后的完整表格重新存回 Excel,可以使用
ws.unmerge_cells()取消合并,并将锚点值逐格写入原区域中,防止下游其他系统读取时继续出现 None。
总结
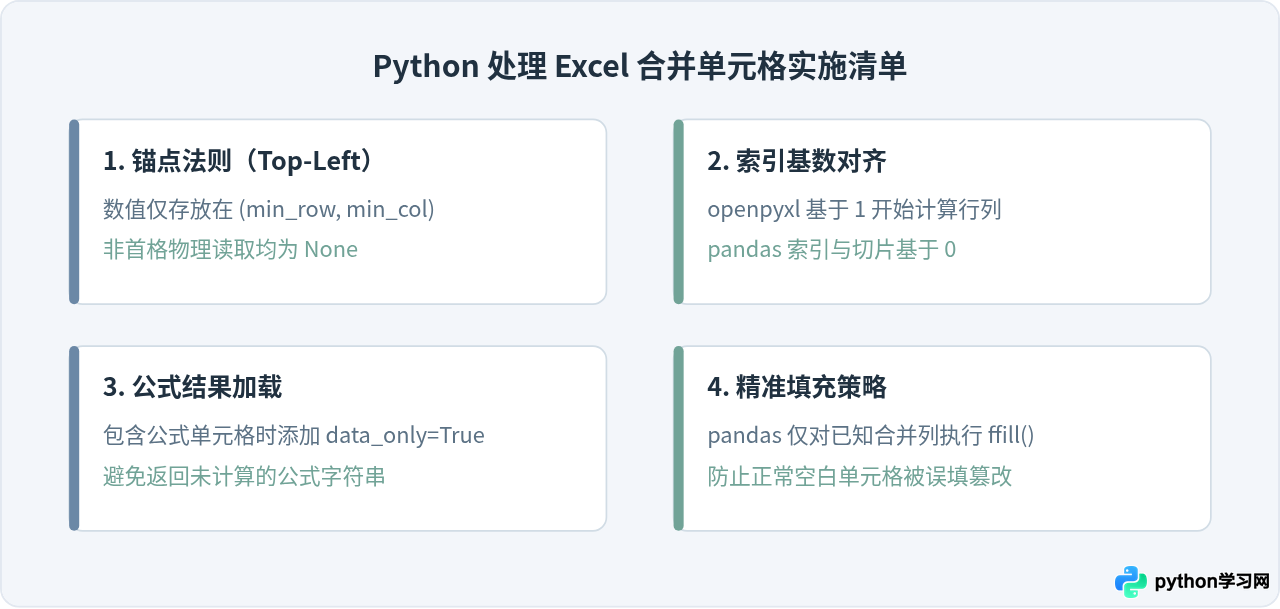
处理 Excel 合并单元格的核心,在于理解其底层“仅首格存值”的设计特点。在 Python 中针对指定行列读取时:
- 如果只需要定位单行、单列或零星几个单元格,首选 openpyxl。通过遍历
merged_cells.ranges判断行列是否在合并矩形内,将坐标重定向至左上角(min_row, min_col)取值。 - 如果是批量读取整表进行清洗和运算,首选 pandas。利用
read_excel()配合指定列的ffill()快速进行向下或向右补齐,再进行标准的行、列切片访问。
根据具体的访问颗粒度选择对应方案,即可彻底解决读取合并单元格时频繁出现的空值问题。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















