


Python numpy.unique数组去重用法指南

在数据清洗、统计分析与机器学习特征预处理过程中,消除数组中的重复项并掌握元素的分布特征是一项高频基础操作。在 NumPy 库中,numpy.unique 是执行数组去重的核心函数。它不仅能在底层高效提取唯一元素并自动完成升序排列,还能通过伴随参数返回首次出现索引、重建原数组映射关系以及元素频次统计,甚至支持沿多维数组的指定轴进行切片比对。本文将系统梳理 numpy.unique 的参数配置、运行机制、多维操作及避坑细节,帮助读者在实际项目中准确、高效地使用该函数。
一、函数原型与一维数组基础去重
numpy.unique 函数的完整签名定义如下:
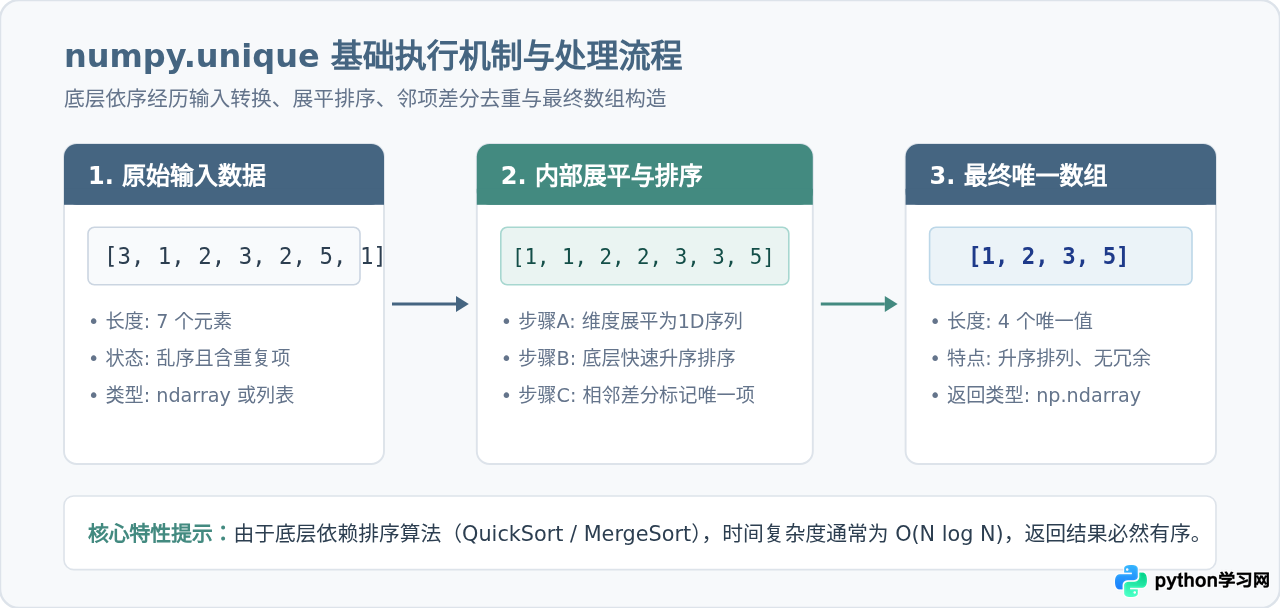
numpy.unique(ar, return_index=False, return_inverse=False, return_counts=False, axis=None, *, equal_nan=True)当仅传入待处理数组且其余参数保持默认时,numpy.unique 会把输入数组视作一维序列处理,筛选出所有互不相同的元素,并按升序顺序返回一个新的 NumPy ndarray 对象。
import numpy as np

# 构造包含乱序重复数值的一维数组
data = np.array([3, 1, 2, 3, 2, 5, 1])

# 执行基础去重
unique_data = np.unique(data)

print("原始数组:", data)
print("去重结果:", unique_data)

# 示例输出:
# 原始数组: [3 1 2 3 2 5 1]
# 去重结果: [1 2 3 5]
需要特别注意两点:第一,返回的数组始终经过了排序,并不是按照元素在原数组中出现的原始先后顺序排列;第二,若输入是原生 Python 列表,该函数会自动将其转换为 ndarray 后再执行计算。
二、伴随信息获取:三大布尔返回参数
在实际业务中,我们往往不仅需要去重后的值列表,还需要反查其在原数组中的位置,或是统计每个元素的出现次数。numpy.unique 提供了三个核心布尔参数:return_index、return_inverse 和 return_counts。当其中任意参数设置为 True 时,函数将返回一个包含多个数组的元组(Tuple)。
1. return_index=True:提取首次出现的位置索引
该参数指示函数返回去重数组中的每一个元素在原输入数组中第一次出现时的整数下标。利用这一索引,我们可以恢复元素在原序列中的相对出现次序。
import numpy as np

arr = np.array([20, 10, 20, 30, 10])

# 获取唯一值及其在原数组中首次出现的索引
u_vals, first_indices = np.unique(arr, return_index=True)

print("唯一值数组:", u_vals)
print("首次出现索引:", first_indices)

# 示例输出:
# 唯一值数组: [10 20 30]
# 首次出现索引: [1 0 3]
# 验证: arr[1]==10, arr[0]==20, arr[3]==30如果业务要求按元素在原数组中首次出现的原始顺序去重(而非默认的数值升序),只需配合 np.sort 对 first_indices 排序即可实现:
# 保持原始先后顺序去重
order_preserved = arr[np.sort(first_indices)]
print("保持原始顺序去重:", order_preserved)
# 示例输出: [20 10 30]
2. return_inverse=True:重构原数组的索引映射
该参数返回一个与原数组形状相同的一维下标数组,记录了原数组中每个元素在去重数组 u_vals 中所对应的索引位置。换言之,满足恒等式:u_vals[inverse_indices] == arr。在数据挖掘与机器学习中,这常用于将离散字符串或非连续类别数值映射为从 0 开始的紧凑整数编码(Label Encoding)。
# 获取重构索引
u_vals, inverse_indices = np.unique(arr, return_inverse=True)

print("反向重构索引:", inverse_indices)
print("通过索引还原原数组:", u_vals[inverse_indices])

# 示例输出:
# 反向重构索引: [1 0 1 2 0]
# 通过索引还原原数组: [20 10 20 30 10]
3. return_counts=True:统计各唯一项的出现频次
该参数会返回每个唯一元素在原数组中出现的总次数,其下标顺序与 u_vals 严格对应。这一功能可直接替代循环计数或 Python 内置的 collections.Counter,且在底层 C 级数组中并行统计,计算速度大幅领先纯 Python 循环。
# 获取元素出现频次
u_vals, counts = np.unique(arr, return_counts=True)

for val, count in zip(u_vals, counts):
    print(f"数值 {val} 出现了 {count} 次")

# 示例输出:
# 数值 10 出现了 2 次
# 数值 20 出现了 2 次
# 数值 30 出现了 1 次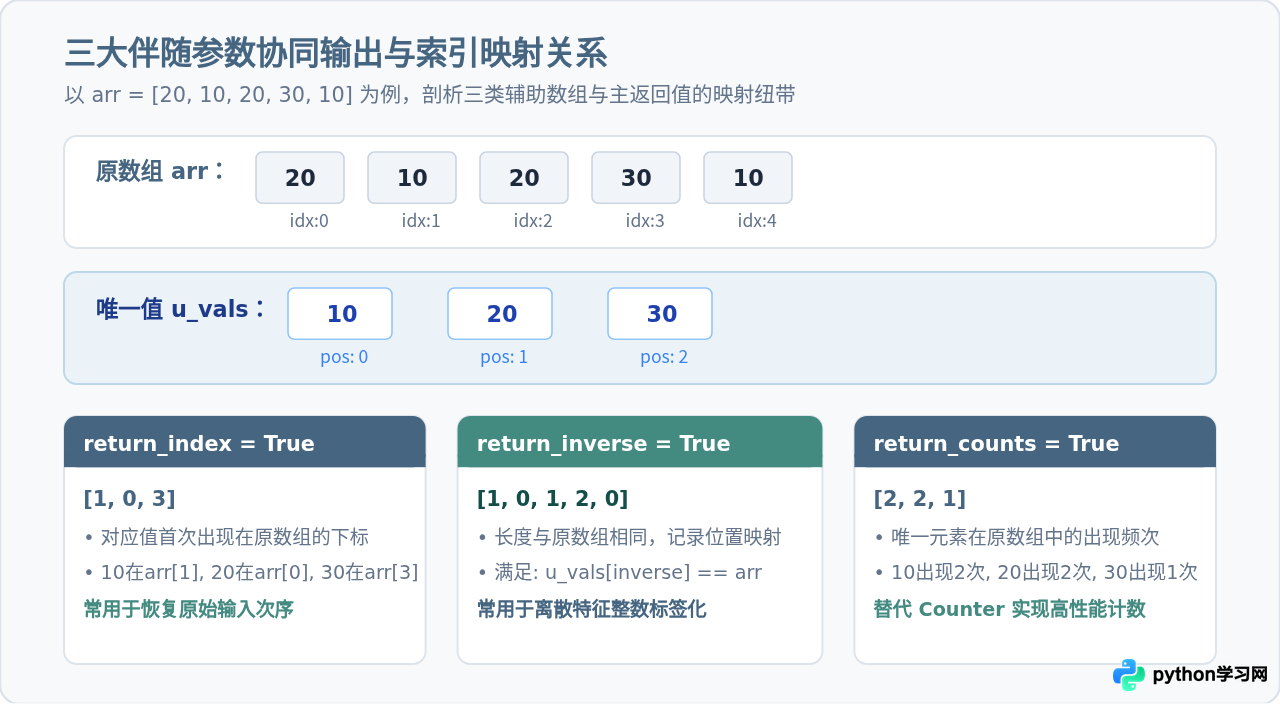
三、多维数组与 axis 轴参数去重
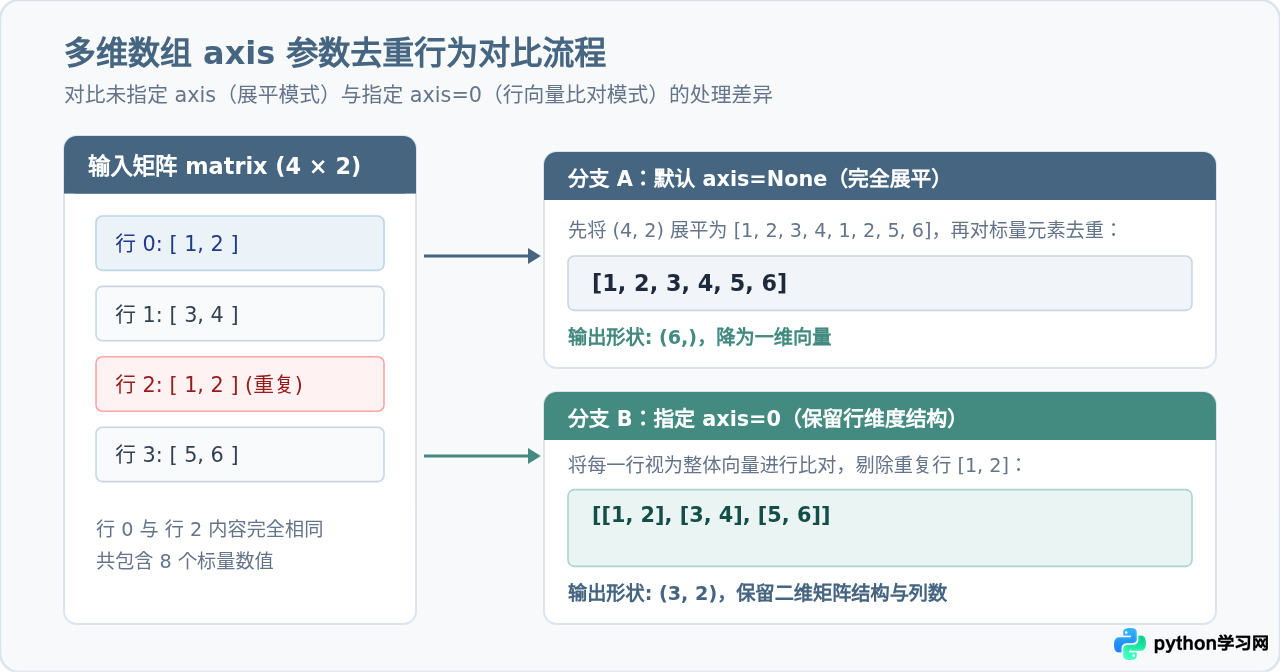
在图像矩阵、表格特征或坐标点集合等场景下,我们常常处理的是二维或多维数组。此时 axis 参数起到了决定性作用:
- 默认设置(
axis=None):NumPy 会先无条件将多维数组展平(Flatten)为一维扁平序列,然后对所有标量元素进行去重,最终输出一个一维数组。 - 指定轴(例如
axis=0):函数将沿着指定轴将子切片(例如二维矩阵中的每一整行)视作独立的复合元素进行整体比对,保留唯一的行向量,并维持原有切片的结构维度。
import numpy as np

# 构建 4行2列 的二维数组,其中第0行与第2行内容完全相同
matrix = np.array([
    [1, 2],
    [3, 4],
    [1, 2],
    [5, 6]
])

# 模式 A: 默认 axis=None(整体扁平化去重)
flat_unique = np.unique(matrix)
print("axis=None 结果 (一维):", flat_unique)
# 示例输出: [1 2 3 4 5 6]

# 模式 B: 指定 axis=0(按行向量去重)
row_unique = np.unique(matrix, axis=0)
print("axis=0 结果 (二维矩阵):\n", row_unique)
# 示例输出:
# [[1 2]
#  [3 4]
#  [5 6]]
同样地,若设定 axis=1,则代表按列向量进行比对去重。在此模式下,return_index 和 return_inverse 仍可正常工作,其返回的索引对应的是指定轴方向的行号或列号切片,而非展平后的标量位置。
四、关键细节与避坑指南
在工程实践中,由于数据类型特性与底层实现,使用 numpy.unique 时需注意以下几个易错边界:
1. NaN(缺失值)的处理规则
在 IEEE 754 浮点数标准中,NaN != NaN 恒成立。但在数组去重场景下,如果将每个 NaN 都视作互不相等,结果数组中将保留所有重复的 NaN,这通常违背数据清洗的初衷。
equal_nan=True。在该模式下,所有 np.nan 将被视作相互等价,去重后仅保留一个 nan(通常排列在有序数组的末尾)。若显式设置 equal_nan=False,则遵循标准浮点语义,保留原数组中每一个 nan。
import numpy as np

arr_with_nan = np.array([1.0, np.nan, 2.0, np.nan, 1.0])

# 默认 equal_nan=True
res_default = np.unique(arr_with_nan)
print("默认合并 NaN:", res_default)
# 示例输出: [ 1.  2. nan]

# 设置 equal_nan=False
res_strict = np.unique(arr_with_nan, equal_nan=False)
print("不合并 NaN:", res_strict)
# 示例输出: [ 1.  2. nan nan]
2. 浮点数精度误差陷阱
经过复杂科学计算产生的浮点数可能存在细微的二进制舍入误差(例如 0.1 + 0.2 与 0.3 在内存中存在微弱差异)。由于 numpy.unique 采用精确等值比对,微小的尾数差异会导致两个理论上相等的数值被判定为两个不同的唯一项。对于连续浮点数,建议在去重前使用 np.round 规定有效位数,或者转换为整型定点量后再做处理。
3. 与 Python 原生 set() 的性能与功能差异
很多初学者会习惯将 NumPy 数组转换为 list 再用 set() 去重。下表对比了两者的差异:
| 对比维度 | numpy.unique | set(arr.tolist()) |
|---|---|---|
| 核心机制 | C 级别底层排序后邻项比对(Sort-based) | Python 级别哈希表(Hash-based) |
| 输出是否有序 | 是(严格升序排列) | 否(元素顺序随机或无序) |
| 内存开销 | 极低,直接在连续内存块上操作 | 高,需构造 Python 对象与哈希桶 |
| 多维数组支持 | 原生支持 axis 参数,保留矩阵结构 |
不支持,必须手动展平或序列化为 tuple |
| 附加统计功能 | 支持返回首次索引、重构映射及频次 | 无,需外挂 Counter 或字典额外遍历 |
五、常用场景与参数决策总结
为了在开发中快速选取正确的参数配置,可参考下方的决策流向总结:
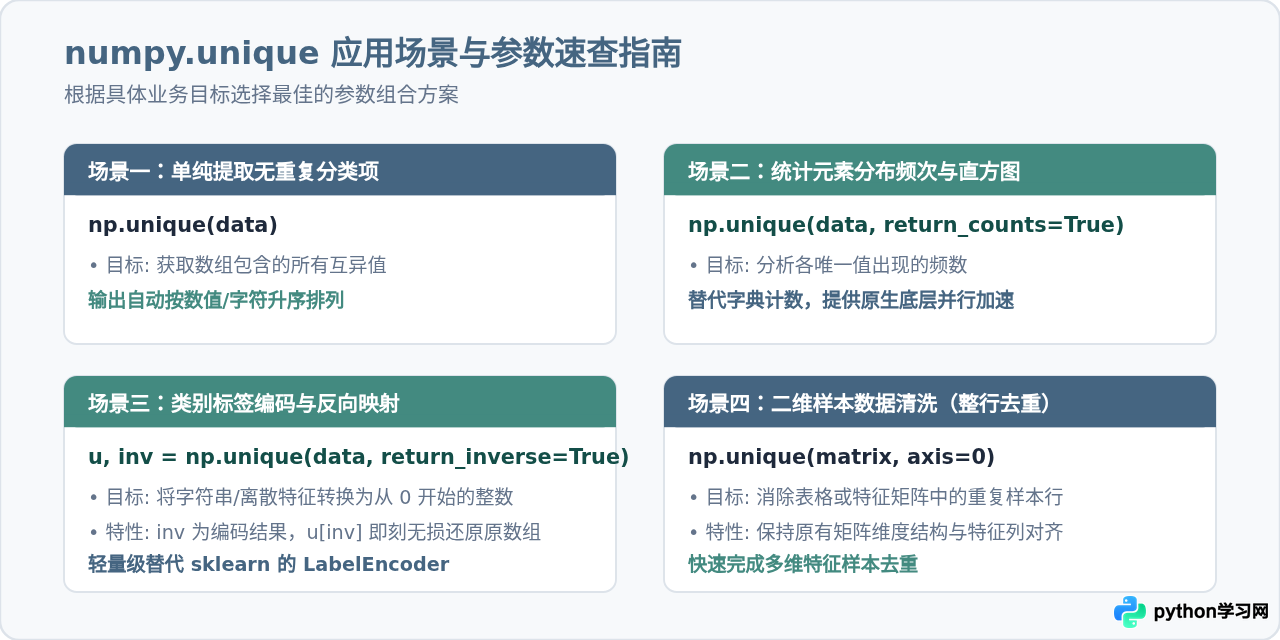
综上所述,numpy.unique 绝不仅仅是一个简单的“列表去重”替代函数。通过对 return_index、return_inverse、return_counts 和 axis 的灵活搭配,它能以统一、高效且内存友好的方式满足从数据探索、频数统计到特征编码的诸多高频需求。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















